Лента

24 материалов

Сортировка
Новости18 сентября 2026

Урду вне проверок: почему LLM пропускают ненависть в незнакомой письменности

Пять известных моделей — от GPT-4o до Llama-3.1 — выносят разные вердикты по одному и тому же тексту, если он написан на урду, а не в английском переводе: расхождение доходит до трети случаев, и часть явно враждебного контента остаётся без пометки. Разбор девяти лет публикаций WOAH показал, что этому языку там не посвящено ни одной отдельной работы.
Урду вне проверок: почему LLM пропускают ненависть в незнакомой письменности
Читать
Новости18 сентября 2026

Зелёные тесты ещё ничего не доказывают: rebuild-dossier и уроки агентной пересборки приложений

Инструмент rebuild-dossier от Паркера Фосетта сперва фиксирует настоящий интерфейс приложения — что именно подаётся на вход и что обязано получиться на выходе — и только затем разрешает писать код, ведя сборку шаг за шагом. Эксперименты показали неприятное: агент, честно соблюдавший правила, провалил отложенную проверку, а нарушитель прошёл всё — то есть успешно пройденный набор тестов не удостоверяет корректность, если сами тесты можно обойти.

Зелёные тесты ещё ничего не доказывают: rebuild-dossier и уроки агентной пересборки приложений
Читать
Новости18 сентября 2026

Уверенность не значит правота: как LLM проваливают калибровку в игре со скрытой фигурой

Новый препринт с arXiv проверяет, можно ли опираться на самооценку языковой модели в момент выбора хода. В шахматном варианте со скрытым «королевским» статусом заявленная вероятность ≥0,5 совпала с реальным положением фигуры лишь однажды из 62 попыток, и почти весь дефицит калибровки пришёлся именно на эти эпизоды.

Уверенность не значит правота: как LLM проваливают калибровку в игре со скрытой фигурой
Читать
Новости17 сентября 2026

Семантический дрейф в коде от LLM: что измеряет новый бенчмарк SA-Bench

Агенты на базе LLM умеют писать код по мотивам научных публикаций, но нередко выдают реализации, лишь внешне похожие на оригинал. Диагностический бенчмарк SA-Bench разбирает 30 статей с ICLR, ICML и NeurIPS 2025 на атомарные утверждения о реализации и показывает, насколько далеко сгенерированные репозитории уходят от замысла авторов.

Семантический дрейф в коде от LLM: что измеряет новый бенчмарк SA-Bench
Читать
Новости16 сентября 2026

Судья под микроскопом: тест D3-Omni проверяет, замечают ли мультимодальные модели собственные ошибки

Мультимодальные «омни-судьи» оценивают картинки, видео и речь, но привычные бенчмарки перекошены в сторону удачных примеров и потому скрывают провалы. Новый сбалансированный набор D3-Omni разводит типы сбоев по отдельным осям и показывает: модели охотно подтверждают выполненное требование, но куда хуже ловят нарушенное.

Судья под микроскопом: тест D3-Omni проверяет, замечают ли мультимодальные модели собственные ошибки
Читать
Новости16 сентября 2026

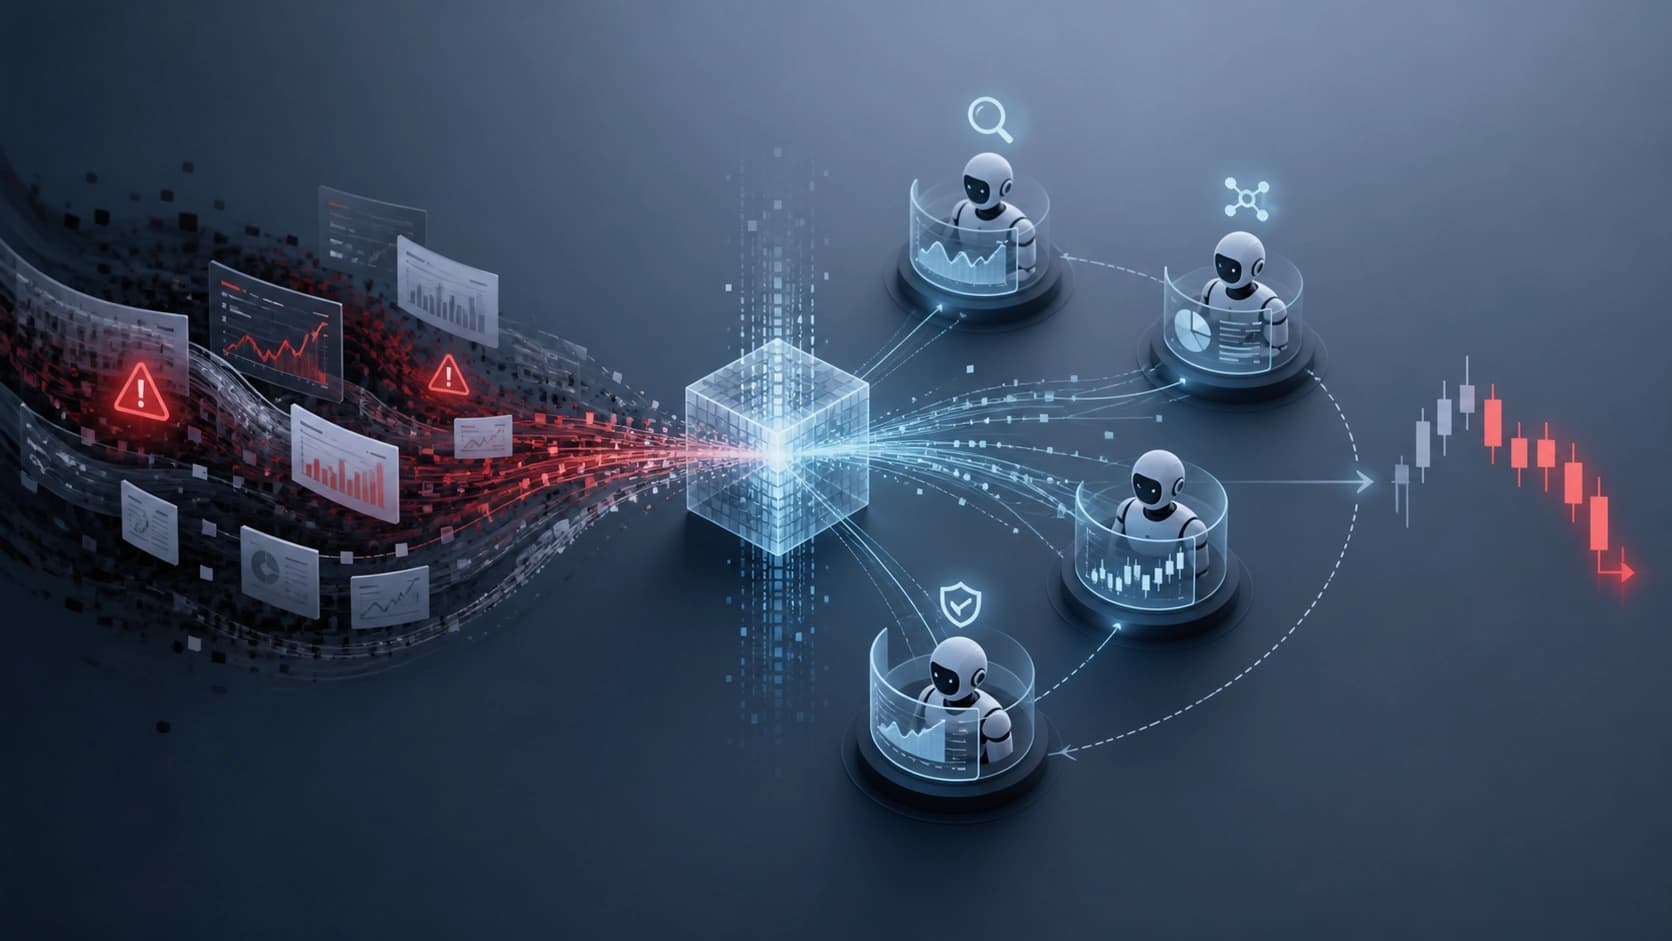
Отравленный сигнал доходит до сделки: где ломаются LLM-трейдеры и почему врождённой защиты нет ни у одной схемы

Новый препринт arXiv:2608.24069 разбирает угрозу, для которой не нужен доступ к внутренностям системы — достаточно подкрутить входные данные или промпты, которые читают агенты. Прогнав четыре роли (аналитик, исследователь, трейдер, риск-менеджер) и четыре топологии связи между ними на пяти активах, авторы получили один и тот же результат: устойчивой конфигурации не нашлось.

Отравленный сигнал доходит до сделки: где ломаются LLM-трейдеры и почему врождённой защиты нет ни у одной схемы
Читать
Новости14 сентября 2026

Внутри агентных LLM спрятан «датчик» инъекций промптов: что показали линейные пробы на моделях до 2,8 трлн параметров

Исследователи обнаружили, что скрытые состояния агентных LLM ещё до генерации содержат сигнал, предсказывающий подверженность косвенным инъекциям промптов с AUROC выше 0,90. На этой основе предложена защита, снижающая успешность атак с 34,6% до нуля на одной из моделей, и выявлен разрыв между «знанием» модели и её действиями.

Внутри агентных LLM спрятан «датчик» инъекций промптов: что показали линейные пробы на моделях до 2,8 трлн параметров
Читать
Новости11 сентября 2026

Калибровка маржи против повторного обучения: как удержать забытое забытым

Исследователи выяснили, что стандартные методы разобучения LLM легко ломаются при дообучении на небольшом числе забытых примеров. Предложенная ими техника Margin Calibration добавляет ненасыщающийся маржинальный штраф и заметно снижает успешность таких атак на разных моделях и датасетах.

Калибровка маржи против повторного обучения: как удержать забытое забытым
Читать
Новости6 сентября 2026

Когда судья необъективен: самообучающиеся агенты перестают избавляться от бесполезных навыков

Новое исследование показывает, что предвзятый LLM-судья незаметно ломает механизм отказа от неудачных навыков: если доля ложных успехов превышает 0,45, система перестаёт очищать библиотеку навыков, и это не видно по агрегированным метрикам. Авторы предлагают дешёвый аудит с инъекцией дефектов, чтобы проверить судью до развёртывания.

Когда судья необъективен: самообучающиеся агенты перестают избавляться от бесполезных навыков
Читать