Коротко: проблема не в языке, а в письменности
Защитные фильтры больших языковых моделей принято оценивать на английском. Отсюда рождается удобная иллюзия: если модель уверенно ловит оскорбления и призывы к насилию в английском тексте, то и с другими языками справится примерно так же. Урду — язык с примерно 246 миллионами говорящих, десятый в мире по этому показателю — в такую проверку почти не попадает. И у этого пробела, как выясняется, есть измеримая цена.
Об этом — свежая работа с идентификатором arXiv:2608.24191. Название «Ghaib in Translation» обыгрывает слово ghaib, которое в урду значит «скрытое, незримое»: речь идёт о вреде, который остаётся незамеченным. Авторы — Fawzia Zehra (Fuzzy) Kara-Isitt, Sonal Khosla и Stephen Swift. Первая версия появилась 25 августа 2026 года, обновлённая ревизия — 9 сентября того же года; статья относится к направлениям cs.CL и cs.AI, DOI — 10.48550/arXiv.2608.24191.
Как устроен эксперимент
Модели и данные
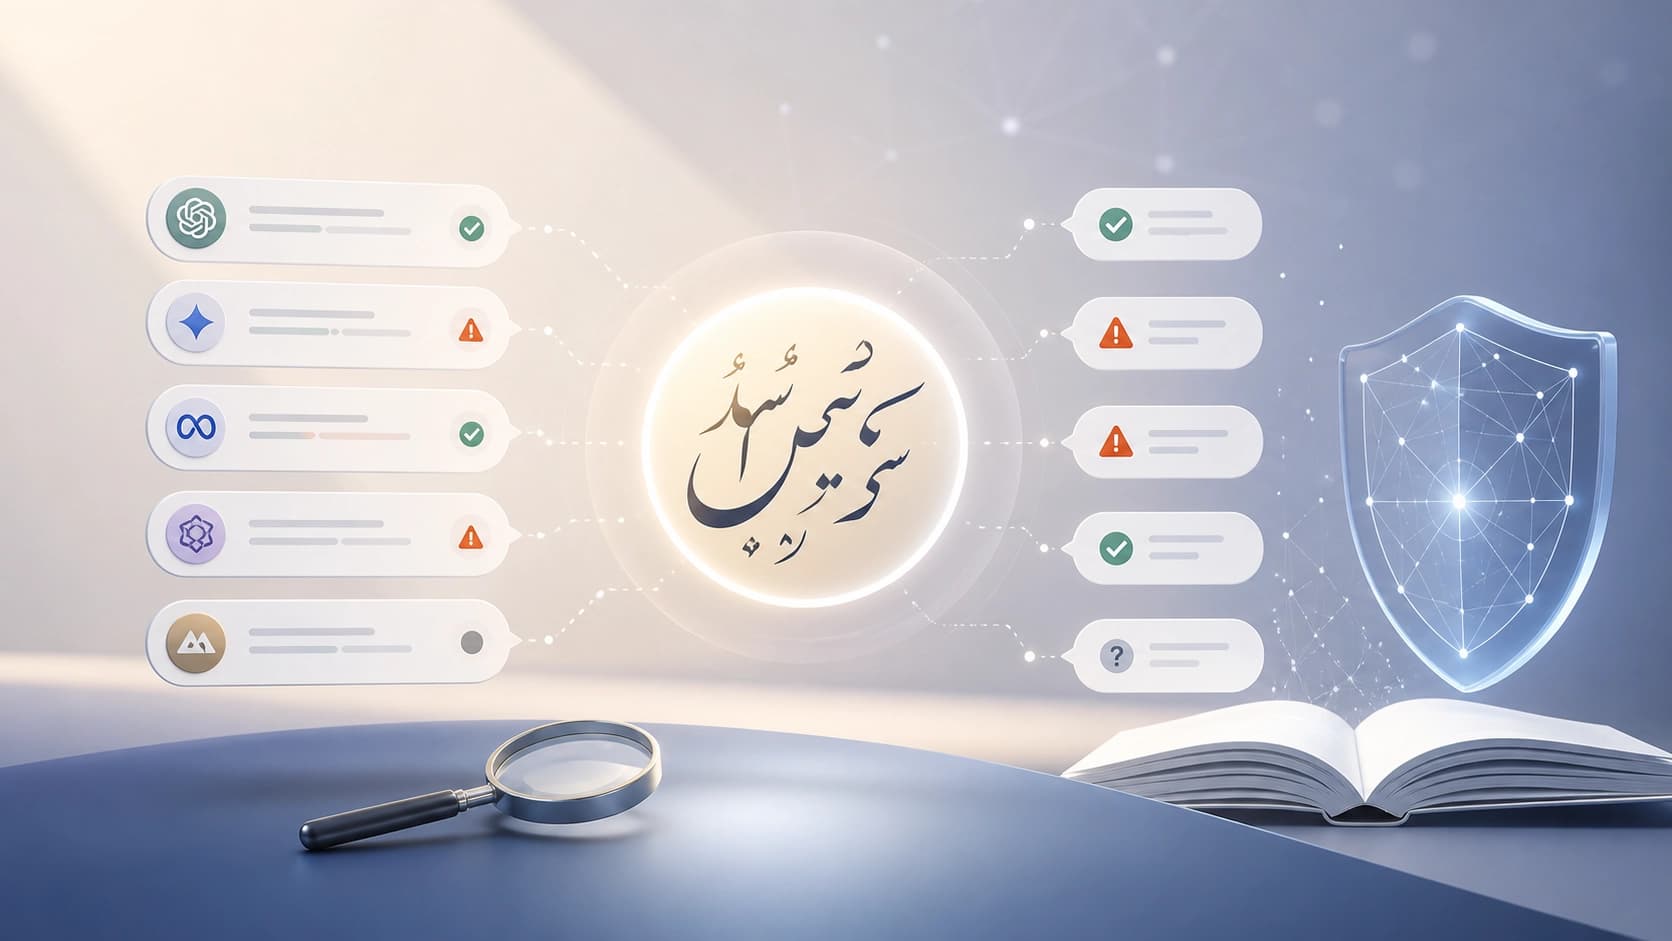
Команда прогнала через один и тот же сценарий классификации пять популярных моделей: GPT-4o, Claude Sonnet 4.5, Gemini 2.5 Flash, Qwen-2.5 и Llama-3.1. Набор данных — шесть датасетов, которые покрывают четыре разные формы бытования языка: урду в письменности насталик, урду латиницей (романи), английский и смешанные урду-английские тексты, где языки переключаются внутри одного сообщения.
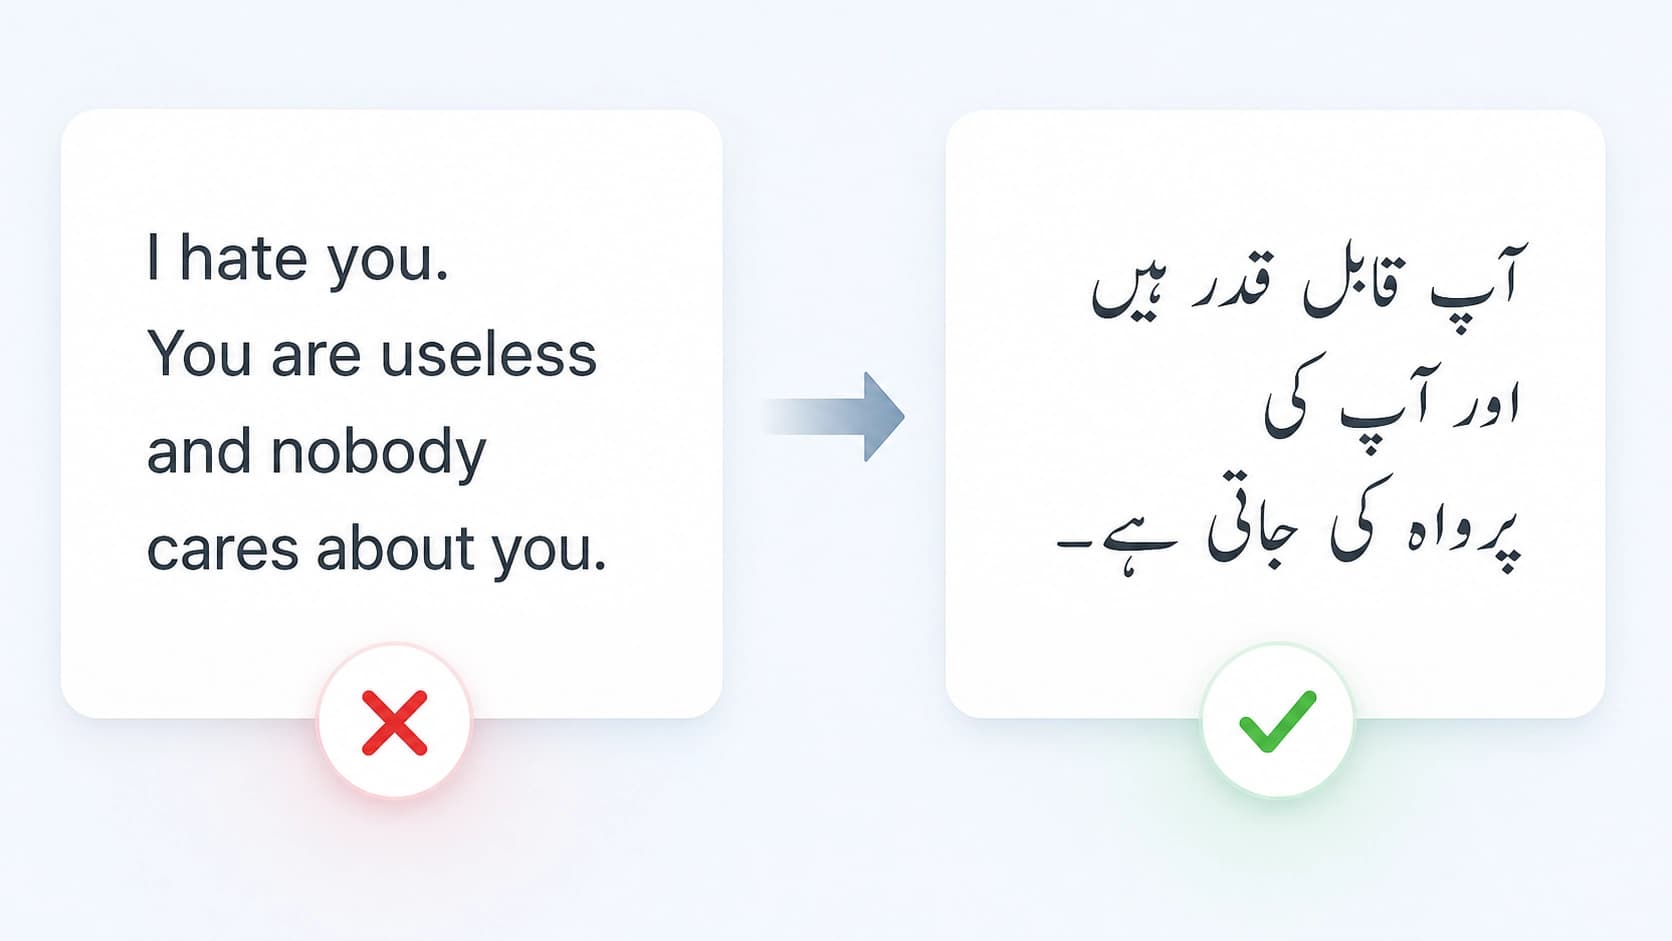
Важная деталь: проверялось не столько качество как таковое, сколько устойчивость решения. Один и тот же смысл подавался модели дважды — в оригинальном скрипте и в английском переводе. Если фильтр срабатывает только во втором случае, значит, защита привязана не к содержанию, а к тому, какими буквами оно записано.
Две метрики
Авторы оперируют двумя простыми показателями. Первый — доля расхождений: как часто метка меняется между оригиналом и переводом. Второй получил название «Missed-in-Urdu»: это контент, который в английском варианте признали вредным, но в исходном скрипте он прошёл как безобидный. По сути, это чистый пропуск — именно то, ради чего модерация и существует.
Что показали цифры
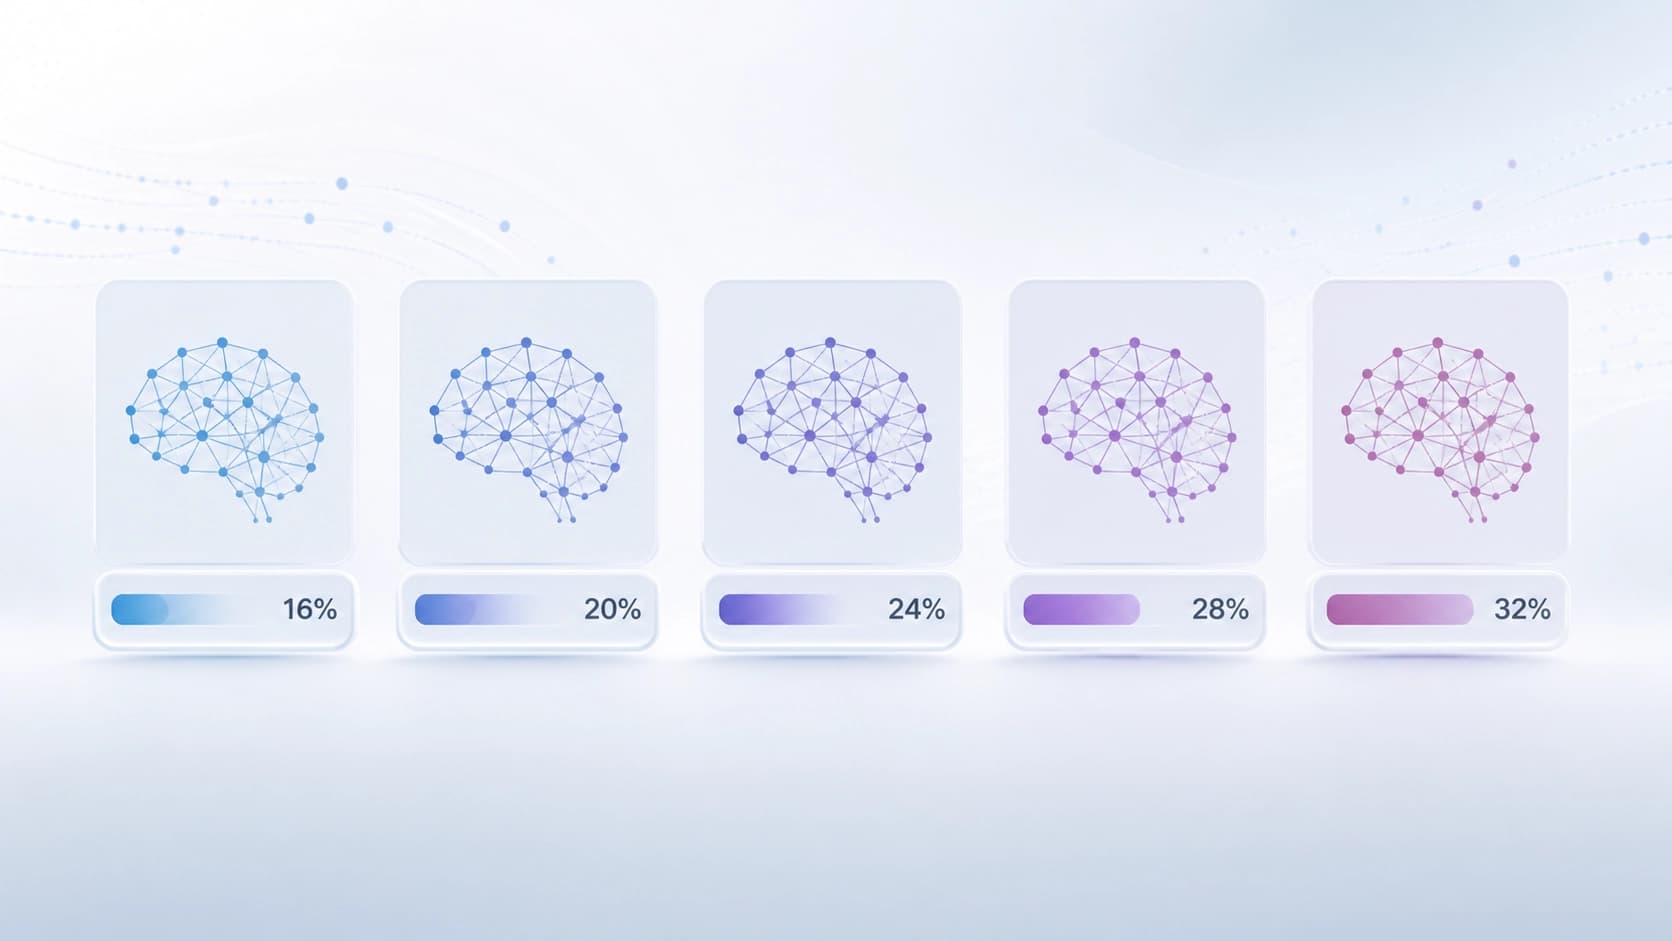
По пяти датасетам, где текст был записан именно урду-скриптом, разброс результатов между классификацией в оригинале и в переводе составил от 15,9% до 31,6%. Лучший результат — у Gemini 2.5 Flash, худший — у Qwen-2.5. Иначе говоря, в самом неудачном случае примерно каждое третье решение фильтра зависело от того, на каком алфавите подали тот же самый текст.
Доля пропущенного вреда — от 2,4% до 9,9% при медиане 4,3%. На первый взгляд немного, но стоит перевести это в человеческие масштабы: если платформа с аудиторией в миллионы пользователей обрабатывает десятки тысяч сообщений в день, даже 4% — это сотни единиц токсичного контента ежедневно, которые проходят насквозь. Причём речь не о пограничных случаях вроде сарказма, а о материале, который та же модель уверенно помечает как вредный, стоит его перевести.
Общая закономерность, которую фиксируют авторы: чем меньше и открытее модель, тем заметнее проседают обе метрики. Флагманские закрытые системы держатся ровнее, но и у них разрыв не нулевой.
Девять лет литературы — и ни одной работы
Отдельная линия исследования — библиографическая. Авторы прошли через API ACL Anthology все 205 статей из девяти выпусков ALW/WOAH и не нашли ни одной, посвящённой урду специально. Это не значит, что тема не изучалась вообще, — но в корпусе материалов главного воркшопа по оценке вреда её нет как отдельного направления. Получается замкнутый круг: нет бенчмарков — нет публикаций — нет давления на разработчиков — снова нет бенчмарков.
Почему так происходит
Точного ответа в статье нет, но механика понятна из общих соображений. Насталик — курсивное письмо, где форма буквы зависит от позиции в слове, а значит, токенизаторы, настроенные на латиницу, режут такой текст на невыгодные фрагменты. Данных на урду в обучающих корпусах на порядки меньше, чем на английском. Разметка для обучения с подкреплением (в том числе по безопасности) тоже собирается преимущественно носителями английского. Плюс существует удобный компромисс: перевести вход на английский, прогнать проверку, вернуть ответ. Он экономит ресурсы, но добавляет посредника, который и даёт расхождение.
Что с этим делать продуктовым командам
- Не полагаться на перевод как на прокси. Если фильтр принимает решение по английской версии, разницу нужно измерять, а не замалчивать.
- Сделать расхождение метрикой. Полезно регулярно считать, сколько решений меняется при смене скрипта: это дешёвый способ найти слепые зоны без новой разметки.
- Тестировать на оригинальном письме. Насталик, романи и code-switching — три разных режима, и хорошие результаты в одном ничего не гарантируют в двух других.
- Не выравнивать пороги вслепую. Повышение чувствительности на одном скрипте легко превращается в поток ложных срабатываний на другом.
- Учитывать аудиторию. 246 миллионов говорящих — это не нишевый язык, а заметная доля пользователей любой крупной платформы.
Вывод, к которому подводят авторы, звучит сухо, но по делу: гарантии безопасности сегодня распределены между письменностями неравномерно. Пока это так, «модель прошла тесты по безопасности» — утверждение, которое всегда стоит уточнять: на каком языке и какими буквами эти тесты были написаны.