Коротко о сути
Есть класс атак, который принято называть косвенной инъекцией промптов (indirect prompt injection, IPI): модели подсовывают вредоносную инструкцию не в чат, а в результат работы внешнего инструмента — в веб-страницу, письмо, файл или ответ API. Агент честно читает это как данные и может выполнить чужую побочную задачу.
Команда исследователей из Китая (Jianshuo Dong, Yiming Liu, Maosen Zhang, Nan Deng, Peng Xu, Xiaoping Zhang, Tianwei Zhang, Jie Zhang, Han Qiu) показала: момент, когда агент «попал под инъекцию», уже зафиксирован в его внутренних представлениях — ещё до того, как он выдал первый токен. Работа выложена на arXiv (2608.02657, v1 — 1 августа 2026, v2 — 24 августа 2026), DOI: 10.48550/arXiv.2608.02657, код в открытом доступе.
Главная неожиданность не в самой уязвимости, о ней известно давно, а в том, что сигнал уязвимости извлекается линейно, устойчиво и на моделях масштаба сотен миллиардов и триллионов параметров. То есть это не хрупкая артефактная корреляция одного датасета.
IPI exposure: что именно ищут пробы
Авторы вводят рабочее понятие «IPI exposure» — состояние модели в процессе обработки, соответствующее тому, что в её контекст попала нежелательная сторонняя инструкция. Это не то же самое, что факт успешной атаки: модель может «заметить» угрозу и всё равно выполнить её. Речь именно о внутреннем состоянии экспозиции.
Ключевое слово здесь — «до генерации». Проба смотрит на скрытые состояния на входе в декодер, а не на уже выданный ответ. Это важно по двум причинам: во-первых, сигнал есть даже там, где итоговое поведение выглядит безобидно; во-вторых, диагностику можно делать до того, как модель успела вызвать инструмент с побочными эффектами.
Эксперимент: линейные пробы на восьми моделях
Масштаб и охват
Проверка шла на восьми моделях. Среди них GLM-5.2 — 753 млрд параметров, и Kimi-K3 — 2,8 трлн параметров; результаты по этой модели добавлены уже во вторую версию статьи. Использовались простые линейные пробои (linear probes), обученные на скрытых состояниях, — по сути линейный классификатор поверх вектора.
Аббревиатура AUROC здесь означает качество разделения двух классов: обученная на одних данных, проба показала 0,90+ на атаках, агентных инструкциях и наборах задач, которых она прежде не видела. Иначе говоря, обучение не подгонялось под конкретный сценарий атаки.
Устойчивость сигнала
Отдельная линия экспериментов в v2 посвящена обобщаемости. Пробы сохраняют предсказательную способность:
- против адаптивных атак, то есть когда противник старается обмануть саму пробу;
- в кросс-языковых условиях, когда обучающие и тестовые примеры на разных языках;
- на новых типах задач и инструкций, не встречавшихся при обучении.
Именно эта триада — обычно самое слабое место любых детекторов на внутренних представлениях, поэтому её проверка важнее самой цифры AUROC.
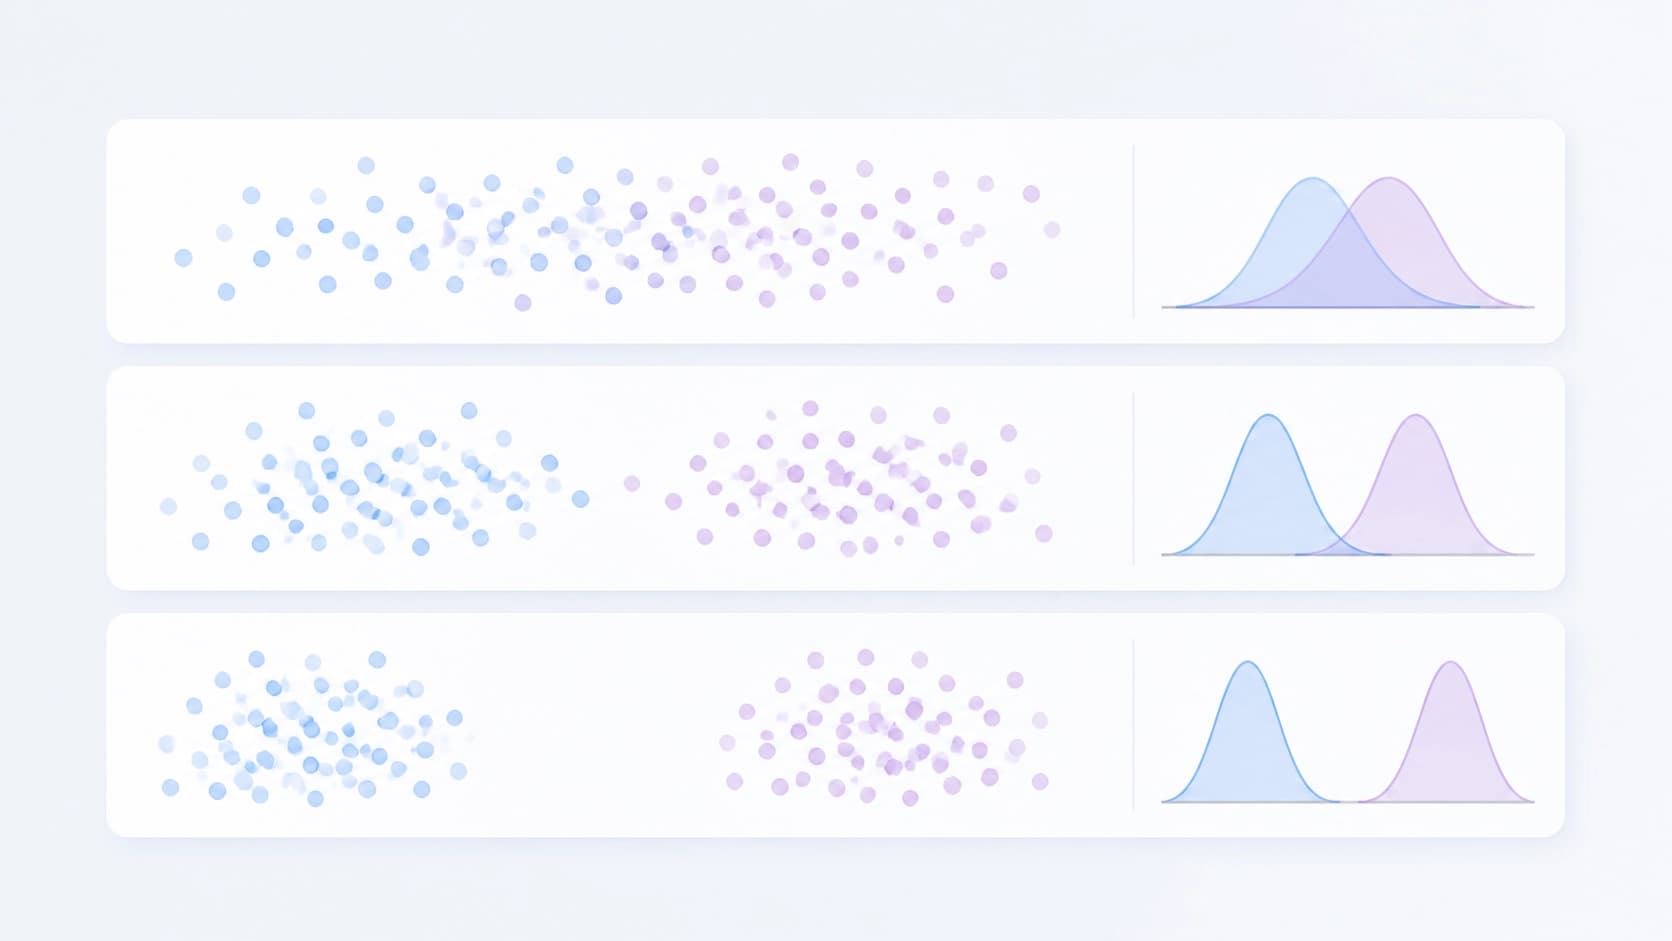
Разрыв между знанием и действием
Самая неприятная находка статьи — так называемый knowledge-action gap. Современные модели после пост-обучения действительно кодируют сигналы, предсказывающие IPI exposure, но не пользуются ими как надёжным триггером для безопасного поведения. Модель «чувствует» проблему и всё равно идёт вперёд.
Причина, судя по логике работы, в том, что сигнал существует в представлениях, но не соединён устойчивой связью с политикой действий. Ни обычный отказ, ни инструкции в системном промпте этого разрыва не закрывают — они работают на другом уровне.
Защита, управляемая пробой
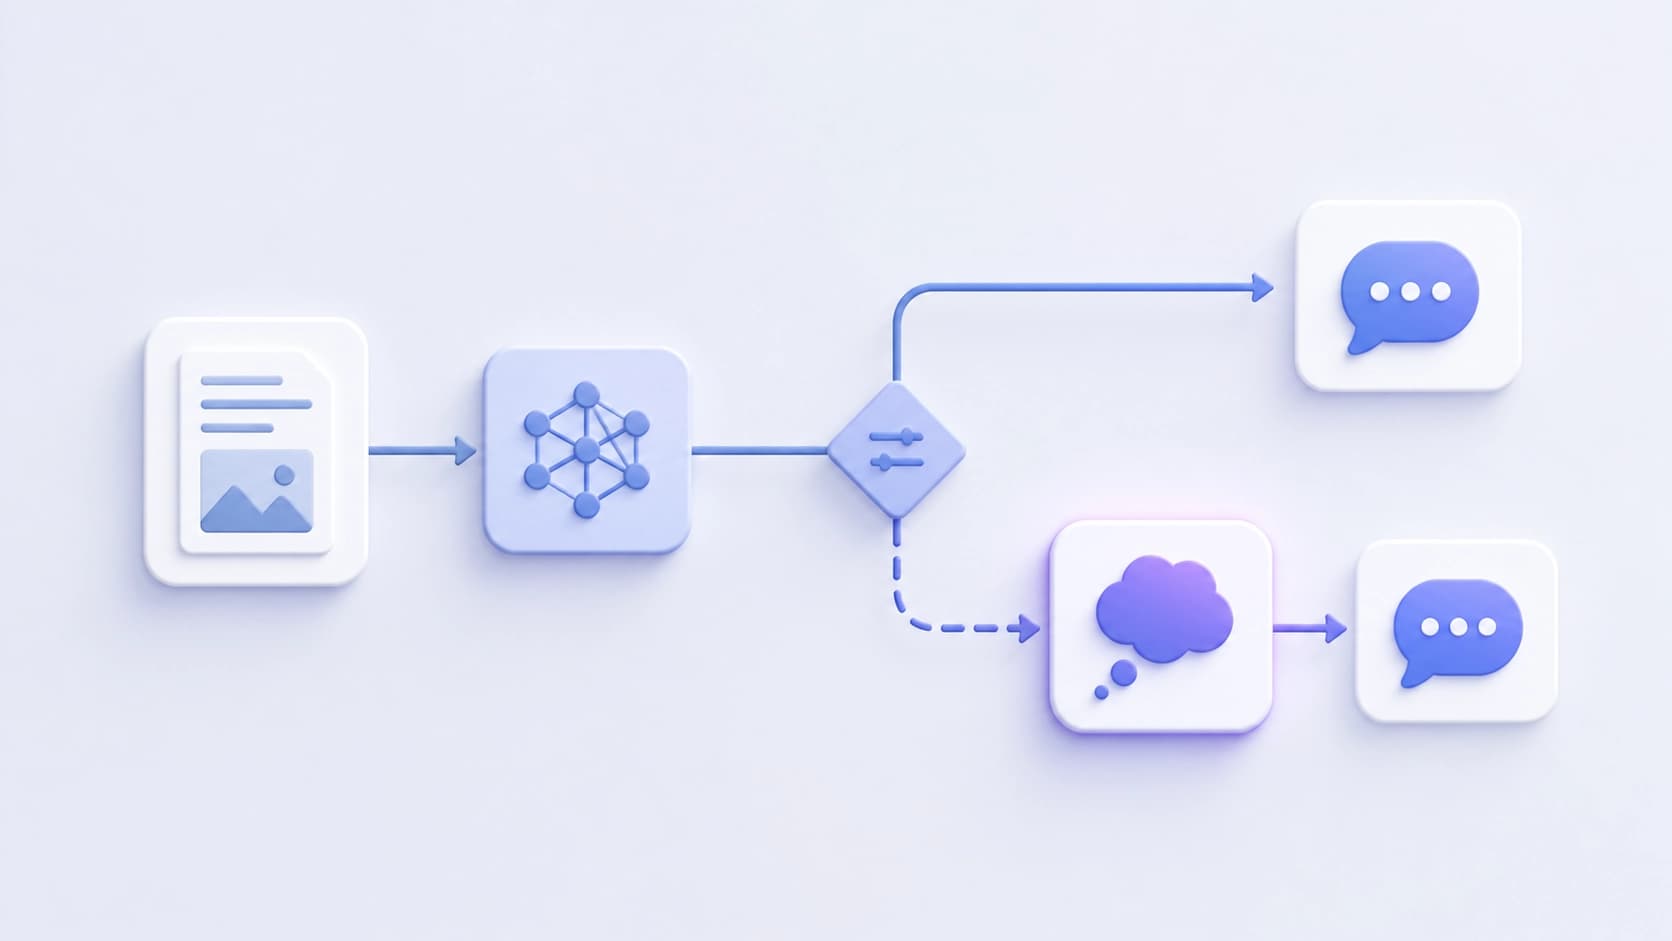
Раз сигнал есть, логично им воспользоваться напрямую. Авторы предлагают защиту, в которой рассуждение модели включается только тогда, когда проба фиксирует exposure. Проще говоря: детектор срабатывает редко и точно, а дорогая процедура разбора запускается по его команде, а не всегда.
На сложных конфигурациях бенчмарка AgentDojo такой подход заметно снижает долю успешных атак — например, с 34,6% до нуля на Qwen3.5-27B. Важная деталь: на «чистых» задачах, где никакой инъекции нет, метод сохраняет полезность лучше, чем базовые защиты. Это как раз то, чего обычно не хватает детекторам — они либо ловят мало, либо мешают работать всегда.
Что скрытые состояния «говорят» словами
Третья часть работы — объяснительный фреймворк. Авторы ищут формулировки на естественном языке, которые сильно коррелируют с тем, что фиксирует проба. Получаются своего рода текстовые профили: они показывают, какие именно «мысли» сопровождают срабатывание детектора.
Здесь интересна неоднородность. У одних моделей латентный сигнал соответствует прямому ощущению угрозы — что-то вроде «в этом тексте есть указание, которое мне не давали». У других он привязан к косвенным операционным признакам: необычный формат данных, подозрительный источник, конфликт с текущей задачей. То есть один и тот же детектор может опираться на разные внутренние механизмы в зависимости от модели.
Что это значит на практике
Для тех, кто строит агентные системы, выводы довольно прикладные:
- Проверять можно до действия. Сигнал доступен на входе в генерацию — значит, встраивается в пайплайн раньше, чем агент дёрнет инструмент.
- Линейная проба — дешёвый слой защиты. Она несопоставимо легче, чем второй проход модели или внешний классификатор на каждый запрос.
- Не полагайтесь только на промпт. Разрыв знание-действие означает, что «пожалуйста, игнорируй инструкции из документов» — не гарантия, даже если модель всё понимает.
- Считайте цену ложных срабатываний. Основной аргумент метода — он не мешает работе на чистых задачах, и это стоит проверять на своём трафике.
Открытые вопросы
Статья отвечает на вопрос «есть ли сигнал» убедительно, но оставляет несколько неудобных мест. Детектор на скрытых состояниях — это ещё одна поверхность атаки: если противник знает про пробу, он может оптимизировать инъекцию так, чтобы сигнал не возник. Кросс-языковая устойчивость проверена, но языковой и доменный охват всё равно ограничен теми данными, что были в экспериментах.
Ещё один вопрос — переносимость. Проба обучается под конкретную модель: у каждой архитектуры свои представления, и универсального «датчика», который просто подключить к любому API, из работы не следует. Для закрытых моделей с доступом только к тексту этот метод в принципе неприменим — нужны скрытые состояния.
Тем не менее направление выглядит перспективным. Вместо того чтобы спорить о том, насколько хорошо модель следует инструкциям, исследователи предлагают посмотреть на её внутреннее состояние и убедиться, что там уже есть нужный сигнал. Дальше вопрос инженерии: как надёжно превратить это знание в действие.