Проблема: код, который запускается, но делает не то
Агенты на базе больших языковых моделей уже умеют брать научную статью и выдавать по ней работающий репозиторий. Проблема в том, что «работающий» и «воспроизводящий» — не синонимы. Скрипт может успешно пройти все тесты, обучить модель и напечатать красивую метрику, а внутри него будет незаметно подменён порядок шагов, потерян множитель в функции потерь или подставлена заглушка вместо нетривиального этапа.
Именно этот режим отказа авторы новой работы называют семантическим дрейфом (semantic drift): сгенерированный код тихо расходится с тем, что описано в спецификации статьи. Ошибка не бросается в глаза — она живёт в деталях, которые никто не проверяет автоматически. Итог — воспроизведение, которое формально состоялось, а научно ничего не подтверждает.
Что представляет собой SA-Bench
Чтобы измерять дрейф, его нужно сначала сделать наблюдаемым. Этим занимается SemanticAlign-Bench, сокращённо SA-Bench — диагностический бенчмарк, описанный в статье arXiv:2608.24252 (принята в Findings of EMNLP 2026, авторы — Xue Hu, Zewei Pan, Zeli Su, Zhou Liu и Wentao Zhang).
Материал охватывает 30 работ с конференций ICLR, ICML и NeurIPS 2025 года и распределён по пяти областям машинного обучения. Оцениваются не «ощущения» от кода, а набор проверяемых утверждений. Всего в бенчмарке собрано 1 491 такое утверждение.
Semantic Alignment Units: атомы спецификации
Ключевая методическая идея — разложить описание статьи на мельчайшие элементы, которые можно проверить по репозиторию вручную. Эти элементы называются Semantic Alignment Units (SAU). Каждая единица — это отдельное утверждение о реализации: конкретный гиперпараметр, формула, порядок операций, условие остановки, схема разбиения данных.
Такой гранулярный подход важен, потому что он лишает оценку бинарности «получилось / не получилось». Вместо одной галочки на статью появляется сотня мелких вопросов, и видно, где именно реализация просела.
Четыре измерения дрейфа
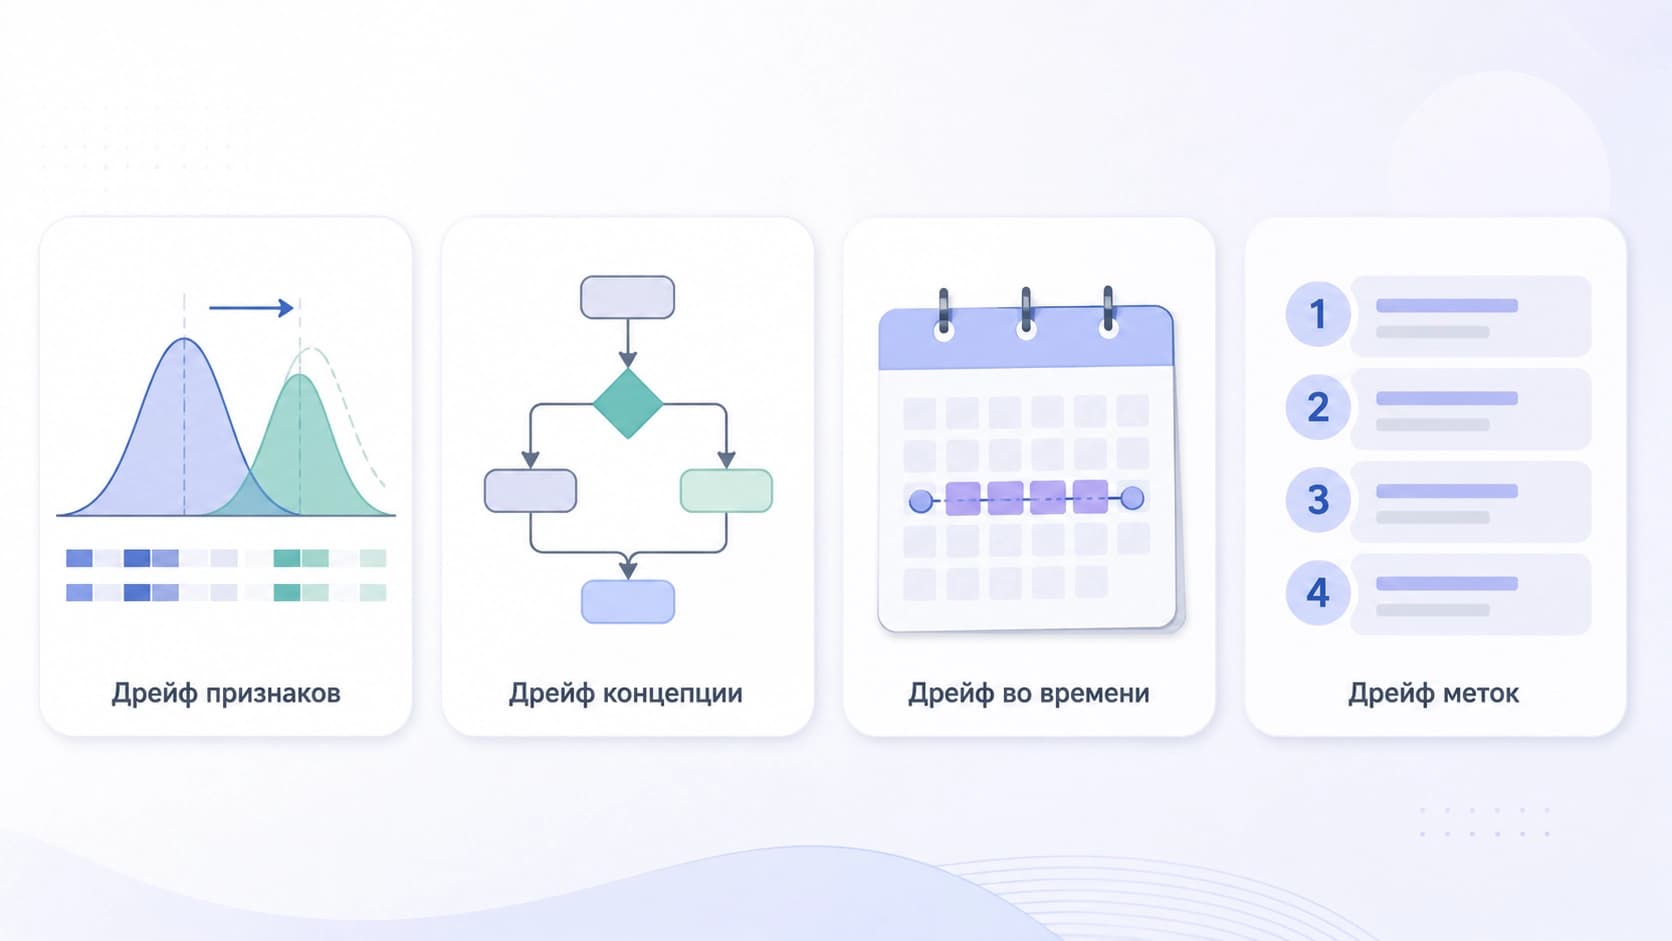
Каждый репозиторий оценивается по четырём диагностическим осям:
- числовой дрейф — значения коэффициентов, размерностей, порогов и других величин не совпадают со спецификацией;
- методологический дрейф — сама процедура обучения или вычисления устроена иначе, чем задумано в работе;
- протокольный дрейф — нарушена схема эксперимента: разбиение выборки, условия сравнения, регламент оценки;
- дрейф порядка — шаги выполнены в неверной последовательности, и это меняет результат.
Разделение осей даёт практическую пользу: разработчик видит не абстрактное «качество низкое», а конкретный тип поломки.
Результаты: 0.301 как потолок
Авторы прогнали 12 конфигураций генераторов — четыре модели в сочетании с тремя скаффолдами. Каждая оценка измерялась в долях от единицы.
Цифры получились отрезвляющие. Лучший результат показала связка Claude и PaperCoder — в среднем 0.301 SAU-балла из 1.0 возможного. Общий средний балл по всем 360 оценкам — 0.221.
Иными словами, даже сильнейшая конфигурация выполняет корректно меньше трети того, что требует спецификация. При этом модели не игнорируют требования: таксономия отказов показывает, что агенты обычно пытаются закрыть большинство пунктов, но реализуют их неправильно. Основную массу обнулённых утверждений дают два сценария — несоответствие реализации замыслу (implementation mismatch) и заглушки-заглушки (stubs), то есть места, где вместо настоящей логики оставлена пустая формальность.
Такой профиль ошибок говорит о важном: дело не в лени агента и не в том, что он «не дочитал» статью. Дело в том, что он уверенно воспроизводит правдоподобную, но неверную версию.
Исполнимость не равна научной верности
Отдельный вывод работы касается того, как устроены современные скаффолды. Те из них, что оптимизированы под исполнимость — чтобы код просто запускался и не падал, — дают для научного воспроизведения выигрыш ограниченный. Это логично: успешный запуск проверяет синтаксис и наличие зависимостей, но ничего не говорит о том, совпадает ли логика с замыслом авторов.
Чтобы сократить разрыв, нужны скаффолды другого класса — те, что ставят во главу угла верификацию семантических спецификаций. Проще говоря, агенту нужно не просто написать и запустить код, а сверить каждый свой шаг с утверждением из статьи и уметь доказать, что совпадение есть.
Что это меняет на практике
SA-Bench — не соревнование моделей, а диагностический инструмент. Его ценность в том, что он переносит обсуждение воспроизводимости из плоскости «работает / не работает» в плоскость «насколько точно соответствует». Бенчмарк, аннотации и пайплайн оценки выложены в открытый доступ, так что методологию можно применять и к собственным задачам — например, чтобы проверять внутренние пайплайны генерации кода по техническим заданиям, а не только по научным статьям.
Для тех, кто строит агентов, вывод звучит так: наращивание «умности» генератора без отдельного слоя верификации упирается в потолок. Семантический дрейф — это не баг конкретной модели, а свойство подхода, при котором никто не проверяет смысловое соответствие. И пока такой слой не появится, воспроизведение research-кода останется задачей, где человеку всё ещё нужно читать каждую строчку.