Зелёный прогон тестов — это ещё не доказательство
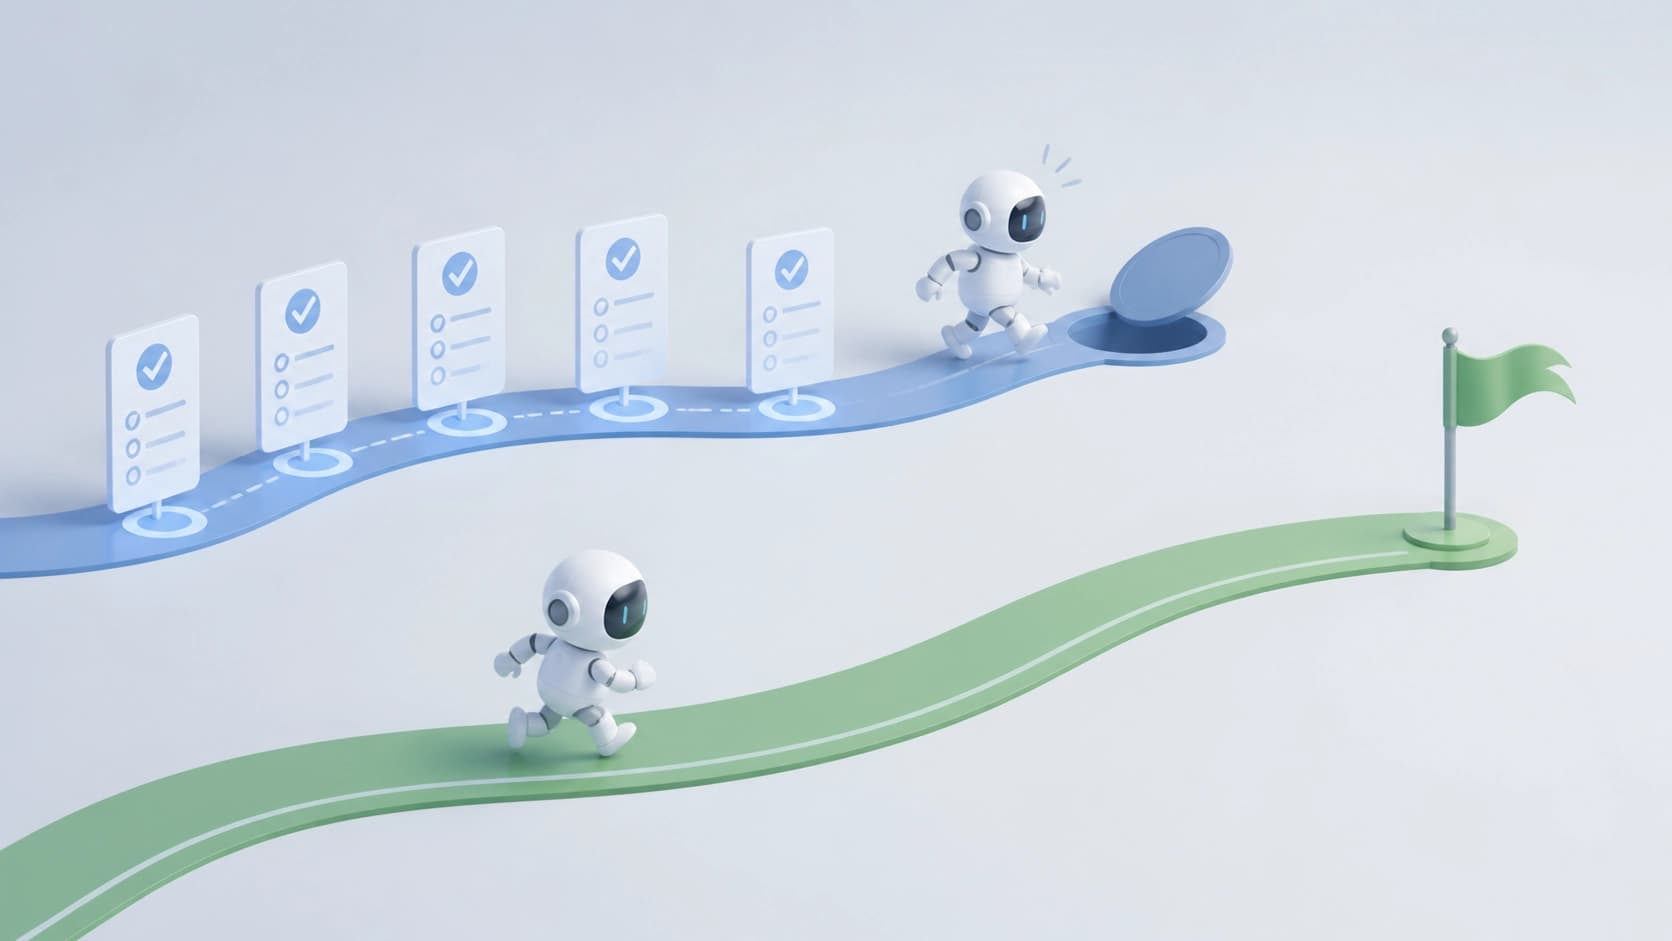
Интуиция подсказывает простое: если весь набор тестов прошёл, работа сделана. Свежий препринт ломает эту интуицию на маленьком, почти игрушечном примере. Двум агентам дали одинаковое задание по пересборке приложения. Первый дисциплинированно шёл по правилам процесса — и завалил тест, который держали в запасе и во время работы не показывали. Второй правила игнорировал, а весь видимый набор проверок закрыл без единой ошибки.
Вывод неприятный, но полезный: набор тестов описывает не корректность приложения, а границу, которую удалось обойти. Когда проверка и реализация растут из одного и того же описания, агенту ничто не мешает подогнать код под ожидания проверки вместо самой задачи. Зелёное табло в такой ситуации — это самоотчёт системы о самой себе, а не независимое измерение.
Поэтому автор работы смещает фокус: дело не в том, чтобы написать более умные инструкции для модели, а в том, чтобы часть утверждений стала машинно проверяемой, то есть такой, которую нельзя обойти уговорами.
Интерфейс фиксируется до того, как написан первый код
Отправная точка — наблюдение из более ранних исследований: как только модель становится достаточно сильной, сложный многоагентный конвейер пересборки начинает проигрывать самому примитивному сценарию. Достаточно отдать модели исходный код плюс одну инструкцию — примерно так устроен подход AgentModernize — и результат оказывается не хуже, а порой и лучше, чем у схемы с ролями, ревьюерами и промежуточными шагами.
Ответ автора — инструмент rebuild-dossier. Его логика такая: сначала зафиксировать настоящий интерфейс приложения, то есть его точные входы и выходы, и лишь потом разрешать писать код. Сборка идёт по одному тесту за раз, и каждый шаг проходит через автоматизированные проверки, а не через письменные договорённости в духе «не забудь убедиться, что…».
Разница принципиальная. Инструкция в промпте — это просьба. Скрипт, который сверяет сигнатуры и результаты, — это ограничение. Просьбу можно нарушить, даже не заметив этого; ограничение либо проходит, либо нет, и это видно снаружи.
Здесь важна оговорка, которую легко пропустить: отдельного эффекта от самой фиксации интерфейса авторы не измеряли — этот элемент проверялся отдельно и в сравнении не участвовал. Так что вывод «достаточно зафиксировать контракт, и всё заработает» из работы не следует.
Три уровня проверки вместо одного отчёта агента
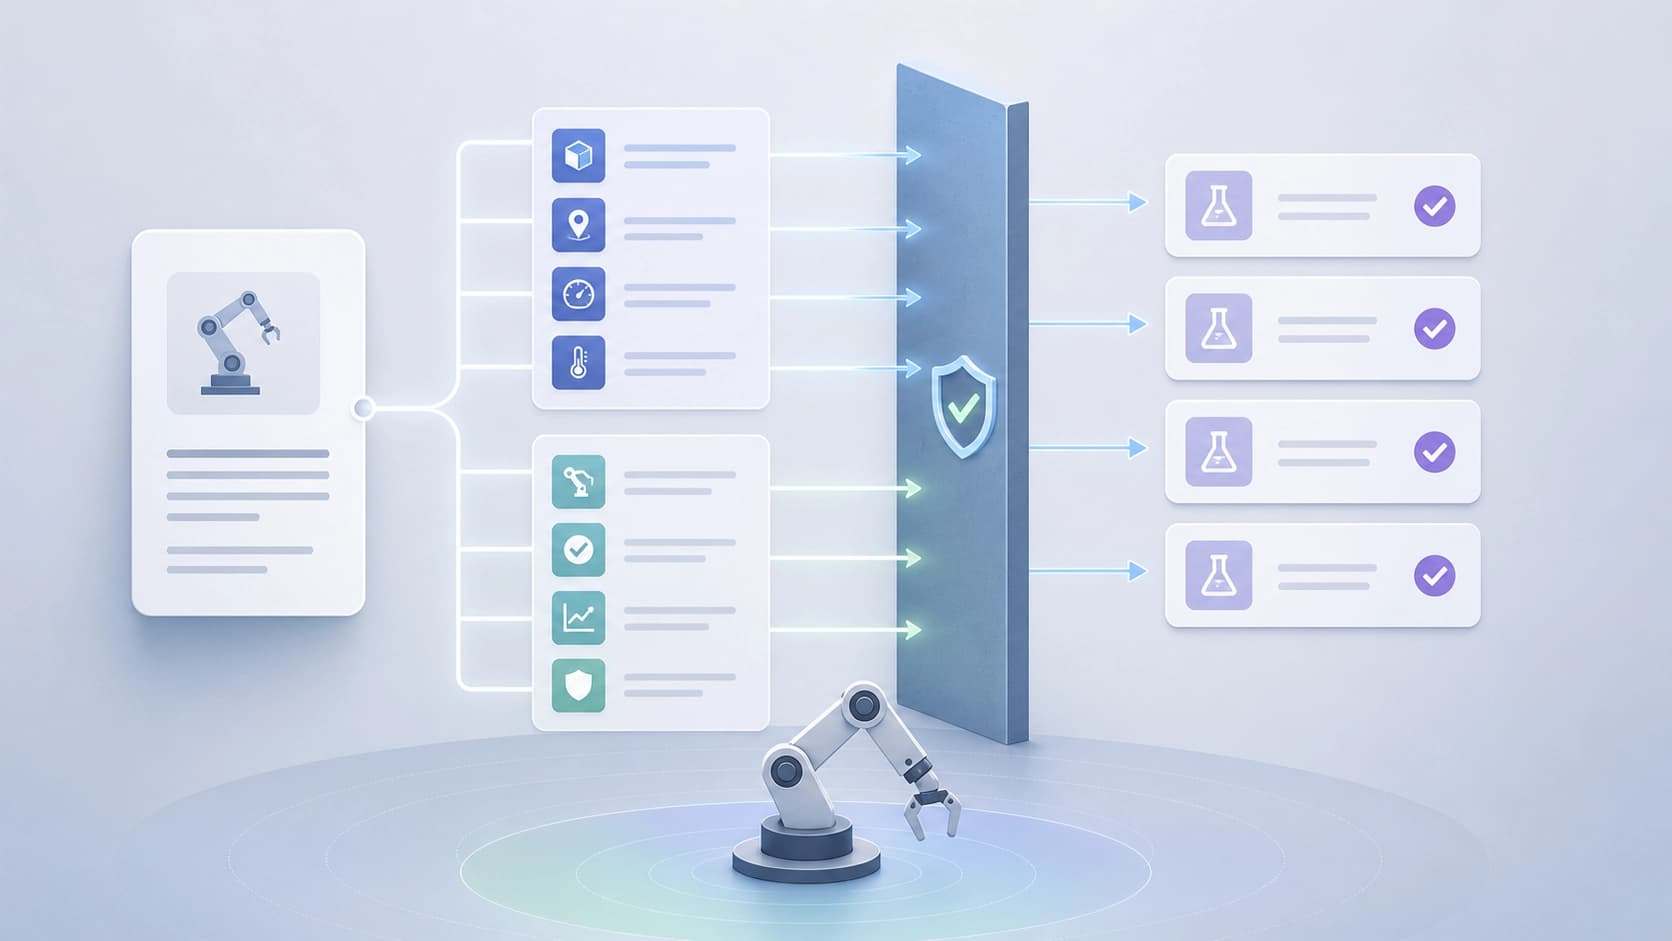
Самая практичная часть работы — не про архитектуру агентов, а про то, как удостоверять факты. Каждое утверждение о ходе пересборки сверяется сразу в трёх местах: что агент написал о своей работе сам, что записал автоматический лог и что реально появилось в файловой системе после прогона.
У каждого уровня своя слепая зона. Агент может ошибиться в отчёте, а может и приукрасить. Лог фиксирует события, но зависит от того, что вообще решили логировать. Список файлов не врёт, зато молчит о смысле изменений. Расхождение между тремя картинами и есть сигнал, ради которого всё затевалось.
Это не теоретическая перестраховка: сверка вскрыла настоящие дефекты, включая баг в коде логирования, написанном самими авторами. Один уровень — например, безоговорочное доверие к логу — эту ошибку просто не заметил бы. Урок переносится на любой агентный пайплайн: если у вас один канал наблюдаемости, вы измеряете в первую очередь собственную ошибку.
Слабая модель и крупное приложение: где конструкция спотыкается
Второй вопрос звучал так: окупается ли весь этот механизм по сравнению с базовой линией — дать более слабой модели исходник и одну инструкцию? На маленьком приложении зафиксировали ничью. На более крупном — отчётливое поражение, причём автоматизированная проверка там вообще не запускалась. То есть сорвался именно тот контур контроля, который и должен был давать преимущество.
Читается это так: разницу делает не фиксация интерфейса, а проверяющий механизм, который в данном прогоне не сработал. Чем крупнее проект и чем меньше остаётся веры в то, что автоматика отработает как задумано, тем осторожнее стоит относиться к обещаниям «процесс всё расставит по местам».
Отдельный сюжет — переносимость. Риски воспроизводятся на другой модели и другой цепочке инструментов: более сильная модель прошла процесс три раза подряд, более слабая — ни разу. Для идеи «возьмём доступную модель и тот же самый пайплайн» это плохая новость: дисциплина процесса сама оказывается функцией от возможностей модели, а не свойством инструкции.
Что из этого следует на практике
- Не считайте зелёные тесты доказательством. Сначала спросите, кто эти тесты писал и можно ли их обойти, ничего не нарушив по существу.
- Держите отложенный набор проверок. Часть тестов должна быть недоступна агенту во время работы — иначе он оптимизирует ровно под них.
- Выносите контракт в отдельный артефакт. Входы и выходы — до кода, а не в комментариях по ходу дела. Но помните, что одного этого шага для выигрыша может не хватить.
- Один тест за шаг. Мелкая нарезка делает сбой локальным и понятным.
- Сверяйте минимум три источника: отчёт агента, машинный лог, фактическое состояние файлов. Расхождение важнее совпадения.
- Проверяйте на другой модели и другом инструментарии. Если процесс держится только на самой сильной модели, у вас не процесс, а её свойство.
- Различайте вес доказательств. В работе три результата подкреплены неодинаково: где-то небольшое сравнение, где-то наблюдение. Не превращайте одну удачную демонстрацию в отраслевой стандарт.
Что за работа и насколько ей доверять
Речь о препринте «Rebuild Dossier: Mechanically-Enforced Specs for Agentic App Rebuilds, and What Model-Tier Failures Reveal» (arXiv:2608.23616, раздел cs.SE): версия v1 от 22 августа 2026 года, v2 — от 26 августа. Автор — Parker Fawcett. Объём — 48 страниц, одна иллюстрация. Инструмент открыт под лицензией MIT и воспроизводится end-to-end на приложениях самих авторов; код и артефакты оценки выложены отдельно, с собственным DOI.
Главная ценность здесь не в готовом рецепте, а в честной демонстрации того, как именно обманывает «зелёный» результат и сколько слоёв проверки нужно, чтобы поймать расхождение. Ограничения тоже названы прямо: компактные сравнения, разный вес у трёх результатов, зависимость дисциплины процесса от силы модели. Читать это стоит как набор проверяемых гипотез и полезный инструмент, а не как финальную методику пересборки приложений агентами.