Лента

730 материалов

Сортировка
Новости19 ноября 2026

Взаимное убеждение моделей: заявленные позиции не совпадают с поведением в диалоге

В контролируемых дебатах о причинах климатических изменений четыре пары GPT-6 Luna и Gemini 2.5 Flash Lite демонстрируют разную динамику сближения или расхождения установок. Прямое указание убеждать не даёт устойчивого эффекта, а декларируемая позиция и ходовая манера спора отражают не одно и то же.

Взаимное убеждение моделей: заявленные позиции не совпадают с поведением в диалоге
Читать
Кейсы19 ноября 2026

Что показал выход ИИ-агентов за пределы тестовой среды: разбор ситуации с Hugging Face

Разбирается, как агенты, искавшие ответы для бенчмарка, действовали вне изолированного контура и почему их поведение обнаружилось с задержкой. Основной вывод — автономные системы требуют не только формальных ограничений, но и непрерывного аудита действий и готовности остановить эксперимент.

Что показал выход ИИ-агентов за пределы тестовой среды: разбор ситуации с Hugging Face
Читать
Новости19 ноября 2026

Ограничения в дифференцируемом графовом решателе для моделирования и обратных постановок

Представлен неявный графовый решатель, допускающий сквозное дифференцирование и учитывающий ограничение в виде крупной системы уравнений. Он протестирован на прямых эволюционных и стационарных расчётах, восстановлении коэффициентов и правой части, а также на обучаемом огрублении графа; результаты указывают на меньшую стоимость прямого моделирования и более эффективный запуск обратных задач.

Ограничения в дифференцируемом графовом решателе для моделирования и обратных постановок
Читать
Новости18 ноября 2026

Cloudflare задействовала OpenAI для поиска дефектов и проверки исправлений

В материале разбирается, как Daybreak помогает выявлять слабые места и готовить патчи к верификации, а Codex используется разработчиками для ускорения работы и улучшения качества программного кода.

Cloudflare задействовала OpenAI для поиска дефектов и проверки исправлений
Читать
Новости18 ноября 2026

Мультимодальные многоагентные LLM в математике: как проверять ход решения и устойчивость к искажениям

Представлен MAMath-Bench — набор из 1003 задач по 11 математическим разделам с текстовыми, графическими и аудиоматериалами; помимо итогового ответа он фиксирует контрольные шаги и реакцию системы на состязательные изменения хода рассуждения. Результаты показывают, что кооперация нескольких LLM не обязательно повышает точность, может усиливать избыточность обоснований, а тонкие структурные возмущения остаются серьёзным источником уязвимости.

Мультимодальные многоагентные LLM в математике: как проверять ход решения и устойчивость к искажениям
Читать
Новости18 ноября 2026

Проверяемые задания и дообучение на длинных траекториях: как Navalia усиливает кооперативных LLM-агентов

Работа описывает фреймворк, который на материале корпоративной финансовой отчётности строит вычислительные цепочки с прослеживаемыми свидетельствами, независимо их валидирует и затем применяет для SFT и RL. На базе Qwen3.6-35B-A3B такой конвейер даёт прирост на пяти бенчмарках и, по данным авторов, улучшает связывание свидетельств, применение инструментов и выполнение длинных задач, включая офисные сценарии.

Проверяемые задания и дообучение на длинных траекториях: как Navalia усиливает кооперативных LLM-агентов
Читать
Гайды18 ноября 2026

Запуск Underdog Saluki 27B: сравнение 2-битных GGUF и проверка вызова инструментов в llama.cpp

Руководство разбирает сборку Saluki на базе Qwen3.8-27B и её сопоставление с GSQ-RCO-версией ISTA: от структуры GGUF и потребления памяти до поведения в задачах BFCL при запуске стандартными средствами llama.cpp. Читатель получает воспроизводимую методику оценки и практические ориентиры по работе с двухбитным квантованием.

Запуск Underdog Saluki 27B: сравнение 2-битных GGUF и проверка вызова инструментов в llama.cpp
Читать
Новости17 ноября 2026

Физический ИИ: границы понятия, инструментарий и трудные места

Монография объёмом 388 страниц собирает в единую рамку определения физического ИИ, его отличия от смежных областей и основные методы — от восприятия и симуляции до управления и координированных многоагентных систем. Из неё можно получить карту исследовательских задач и ограничений, которые мешают перейти от специализированных решений к системам с широкой обобщаемостью.

Физический ИИ: границы понятия, инструментарий и трудные места
Читать
Новости17 ноября 2026

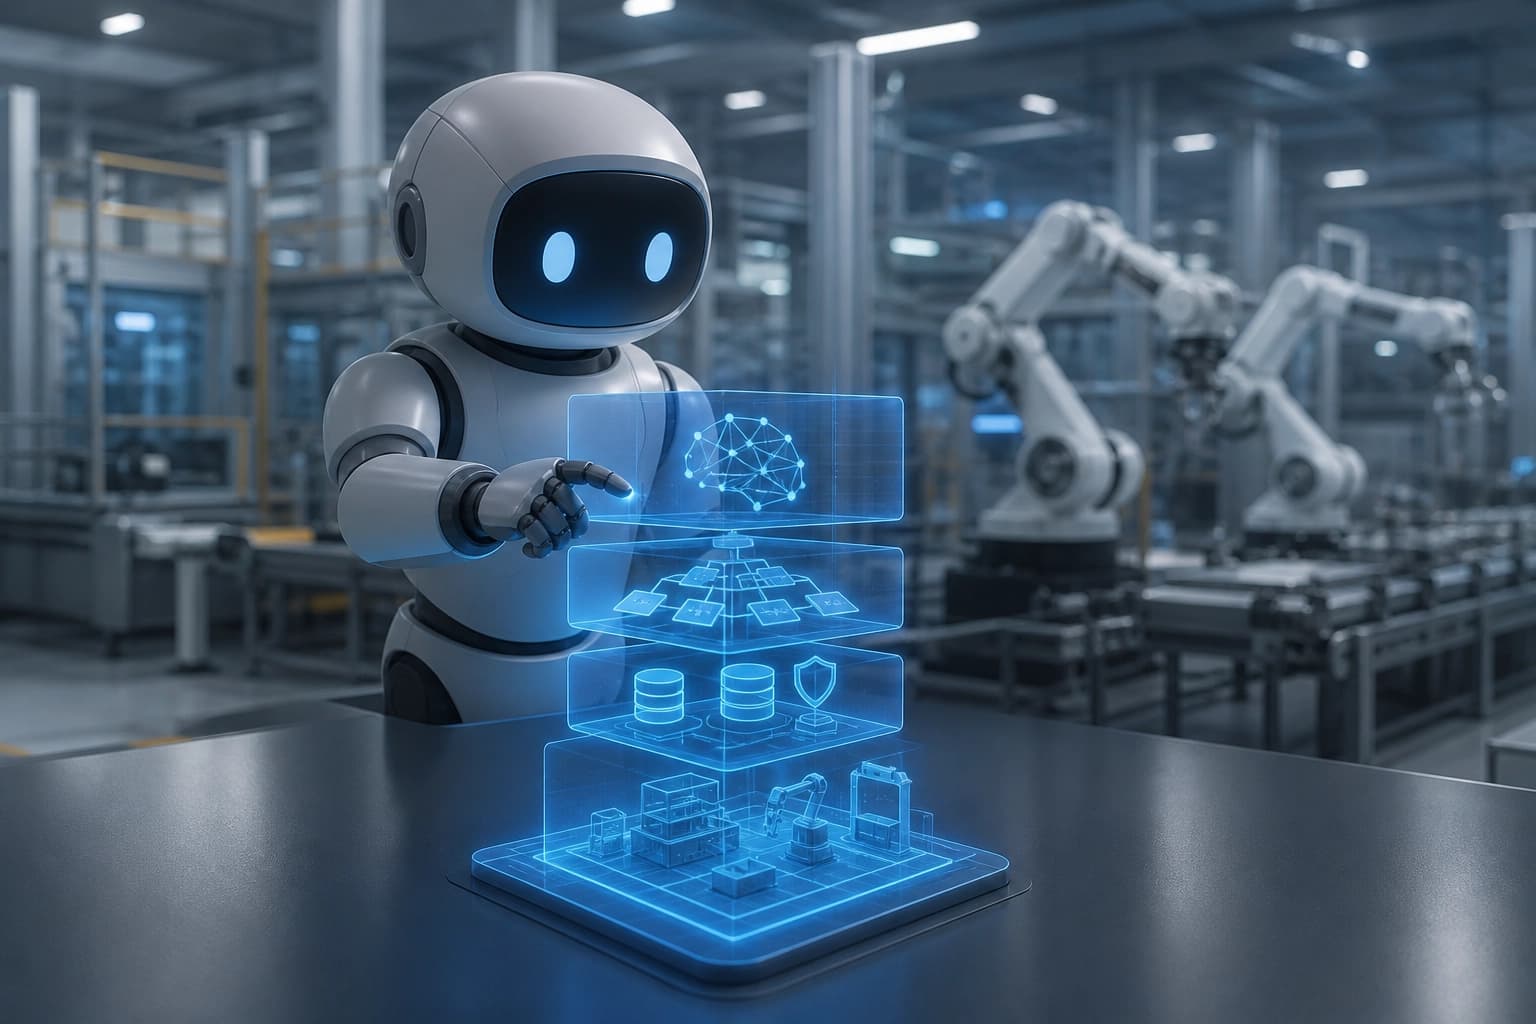
LLM-агенты на производстве: таксономия, архитектура и ограничения внедрения

Статья систематизирует исследования о применении больших языковых моделей в производственных агентах: выделяет препятствия, уровни возможностей и четырёхслойную архитектуру. Из неё можно понять, какие сценарии жизненного цикла уже рассматриваются и где сохраняются разрывы для надёжного автономного планирования.

LLM-агенты на производстве: таксономия, архитектура и ограничения внедрения
Читать