
SpecEvo: согласование лёгких и передовых LLM для удешевления эволюционного поиска
Фреймворк SpecEvo перераспределяет эволюционный поиск: рядовые кандидаты дорабатывают недорогие модели, а сильные подключаются лишь на стратегических контрольных точках с опорой на историю успехов и тупиков. В экспериментах на 176 задачах такой режим позволил не отставать от дорогих аналогов или обходить их при снижении затрат на API на 80%.
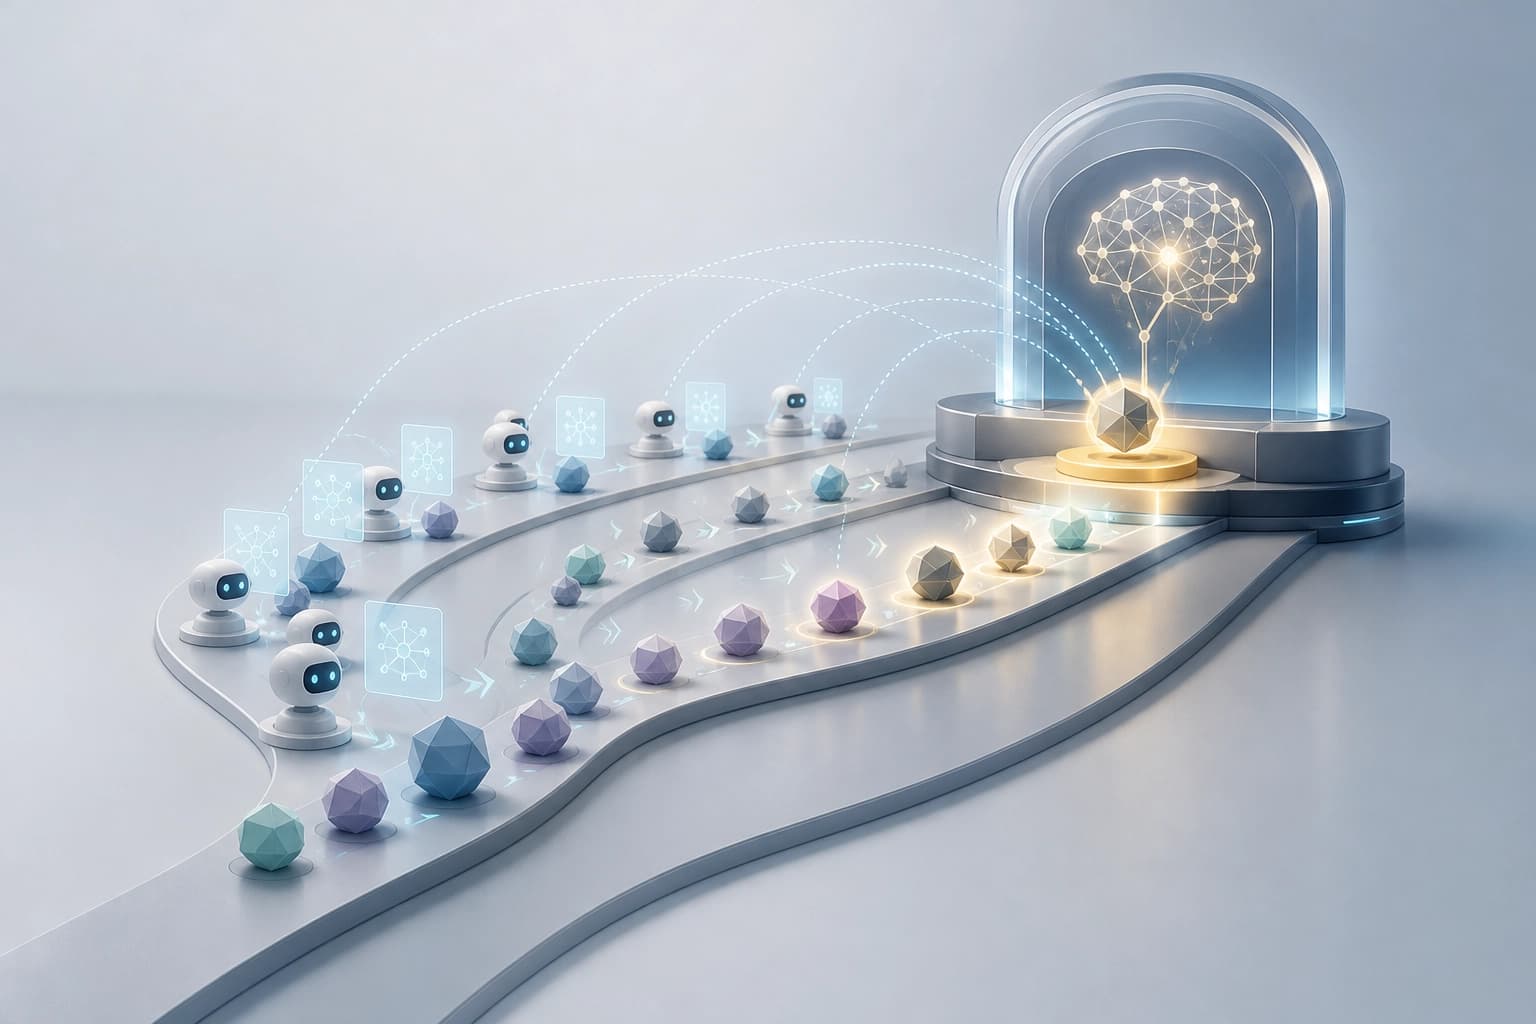
Задача и назначение
SpecEvo (Speculative Evolution) — мульти-LLM-фреймворк для научных открытий. Он координирует лёгкие и передовые модели, чтобы удешевить поиск программ-кандидатов. Статья arXiv:2610.28706 подана 20 октября 2026 года. Авторы — Ha Minh Hieu, Tongyao Zhu, Do Xuan Long и Min-Yen Kan.
Ключевые характеристики:
- тип: мульти-LLM-фреймворк;
- назначение: научные открытия и алгоритмический поиск;
- принцип: координация лёгких и передовых моделей;
- статья: arXiv:2610.28706, подана 20 октября 2026 года;
- авторы: Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan.
Практический критерий: рассматривать фреймворк для задач, где важна стоимость API и нужен поиск программ-кандидатов с редкими контрольными этапами.
Архитектура: роли лёгких и передовых моделей
SpecEvo распределяет работу между лёгкими и передовыми моделями. Лёгкие модели выполняют параллельные функции Speculators и Advisor. Передовая модель работает как Navigator на редких контрольных этапах.
| Компонент | Тип модели | Функция | Режим работы | | Speculators | лёгкие | генерируют и дорабатывают программы-кандидаты | параллельно | | Advisor | лёгкая | обобщает успехи, неудачи и насыщенные направления; превращает их в постоянные рекомендации | обобщение накопленных сведений | | Navigator | передовая | изучает развивающуюся популяцию; вмешивается через синтез, точечную доработку или смену рамки поиска | редко, на контрольных этапах |
Практический критерий: поручать обычный поиск и обобщение свидетельств лёгким моделям, а передовые модели подключать для стратегических вмешательств.
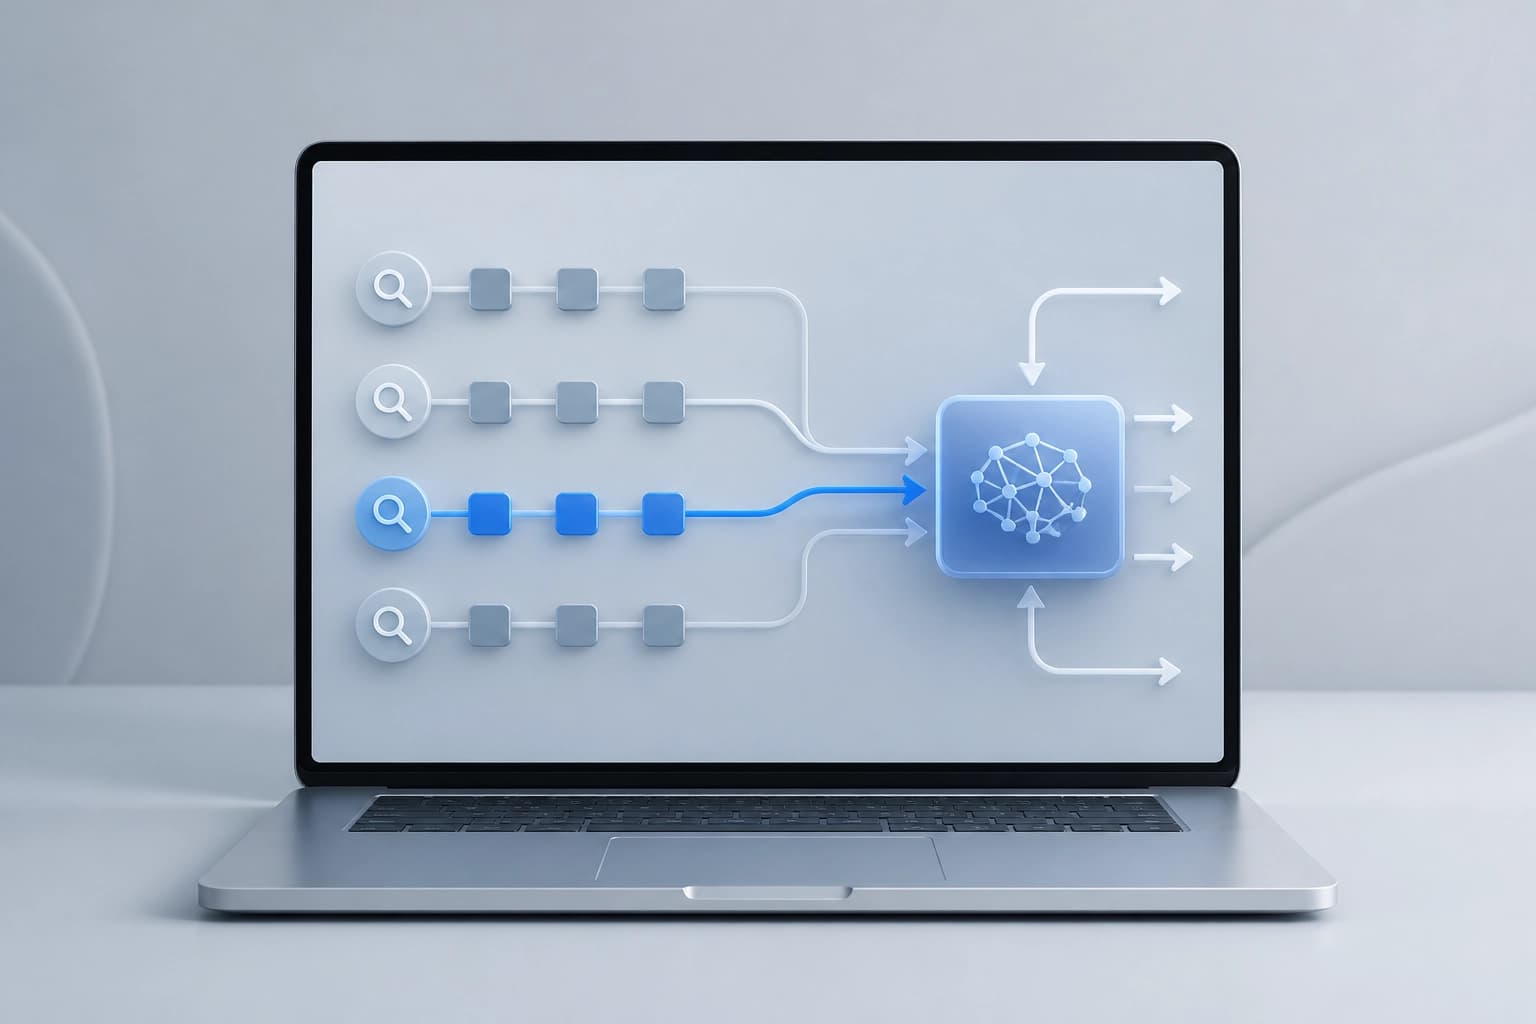
Рабочий процесс «сначала предполагать, затем консолидировать»
В SpecEvo процесс строится на передаче обычного поиска и обобщения свидетельств недорогим моделям. Передовые модели включаются для стратегических вмешательств. Их польза распространяется на многие последующие недорогие оценки.
Этапы:
- Лёгкие модели ведут обычный поиск программ-кандидатов.
- Advisor обобщает накопленные сведения об успехах, неудачах и насыщенных направлениях.
- Navigator на редком контрольном этапе изучает популяцию и выбирает вмешательство.
- Вмешательство зависит от стагнации поиска и может быть синтезом, точечной доработкой или сменой рамки.
- Недорогие модели продолжают оценки с учётом постоянных рекомендаций.
Практический критерий: схема подходит, если поиск допускает редкие контрольные точки и накопление рекомендаций между ними.
Результаты и сравнение с базовыми методами
Авторы проверили SpecEvo на 176 задачах в четырёх областях научных и алгоритмических открытий. Фреймворк показал результат на уровне базовых методов на основе передовых моделей или выше. При этом он сократил расходы на API до 80%. При поиске уравнений фреймворк показал эффективность оценки до 1,5× выше, чем у экономически эффективных базовых методов. Фреймворк превзошёл самый сильный базовый метод CO-Bench на 3,8%.
| Показатель | Результат | | Сравнение с базовыми методами на передовых моделях | сравнялся или превзошёл | | Сокращение расходов на API | до 80% | | Эффективность оценки при поиске уравнений | до 1,5× выше, чем у экономически эффективных базовых методов | | Превышение над CO-Bench | 3,8% |
Практический критерий выбора: сопоставлять качество поиска и расходы на API с базовыми методами на своих задачах. Авторы заключают, что координация моделей с учётом траектории поиска — эффективный подход к экономически эффективным научным открытиям.
Часто задаваемые вопросы
Похожие материалы
Все материалы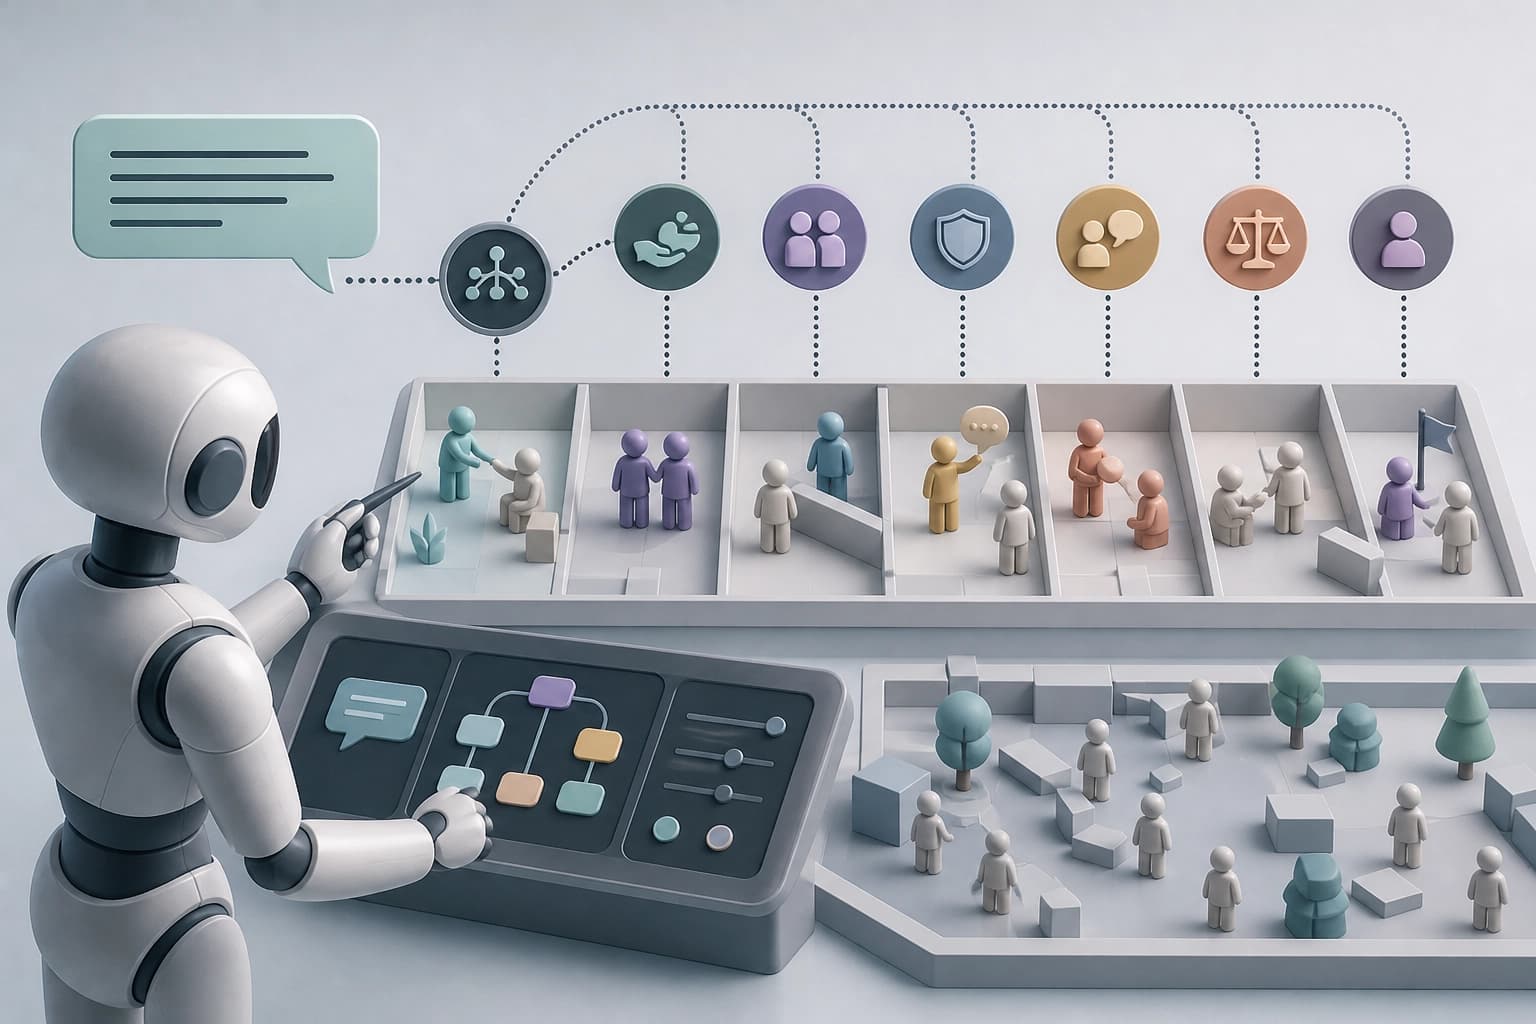
Fig: контролируемые игровые вмешательства для проверки социального поведения ИИ-агентов
Fig получает словесное описание искомого поведения, делит его на разновидности и направленно меняет условия игры, чтобы вызвать нужные действия у моделей. В валидных сценариях для шести социальных паттернов вмешательства повысили среднюю долю попыток целевого поведения на 10,9% относительно контролей, а авторы предлагают рассматривать мультиагентные среды как настраиваемый стенд для воспроизводимой оценки.
21 ноября 2026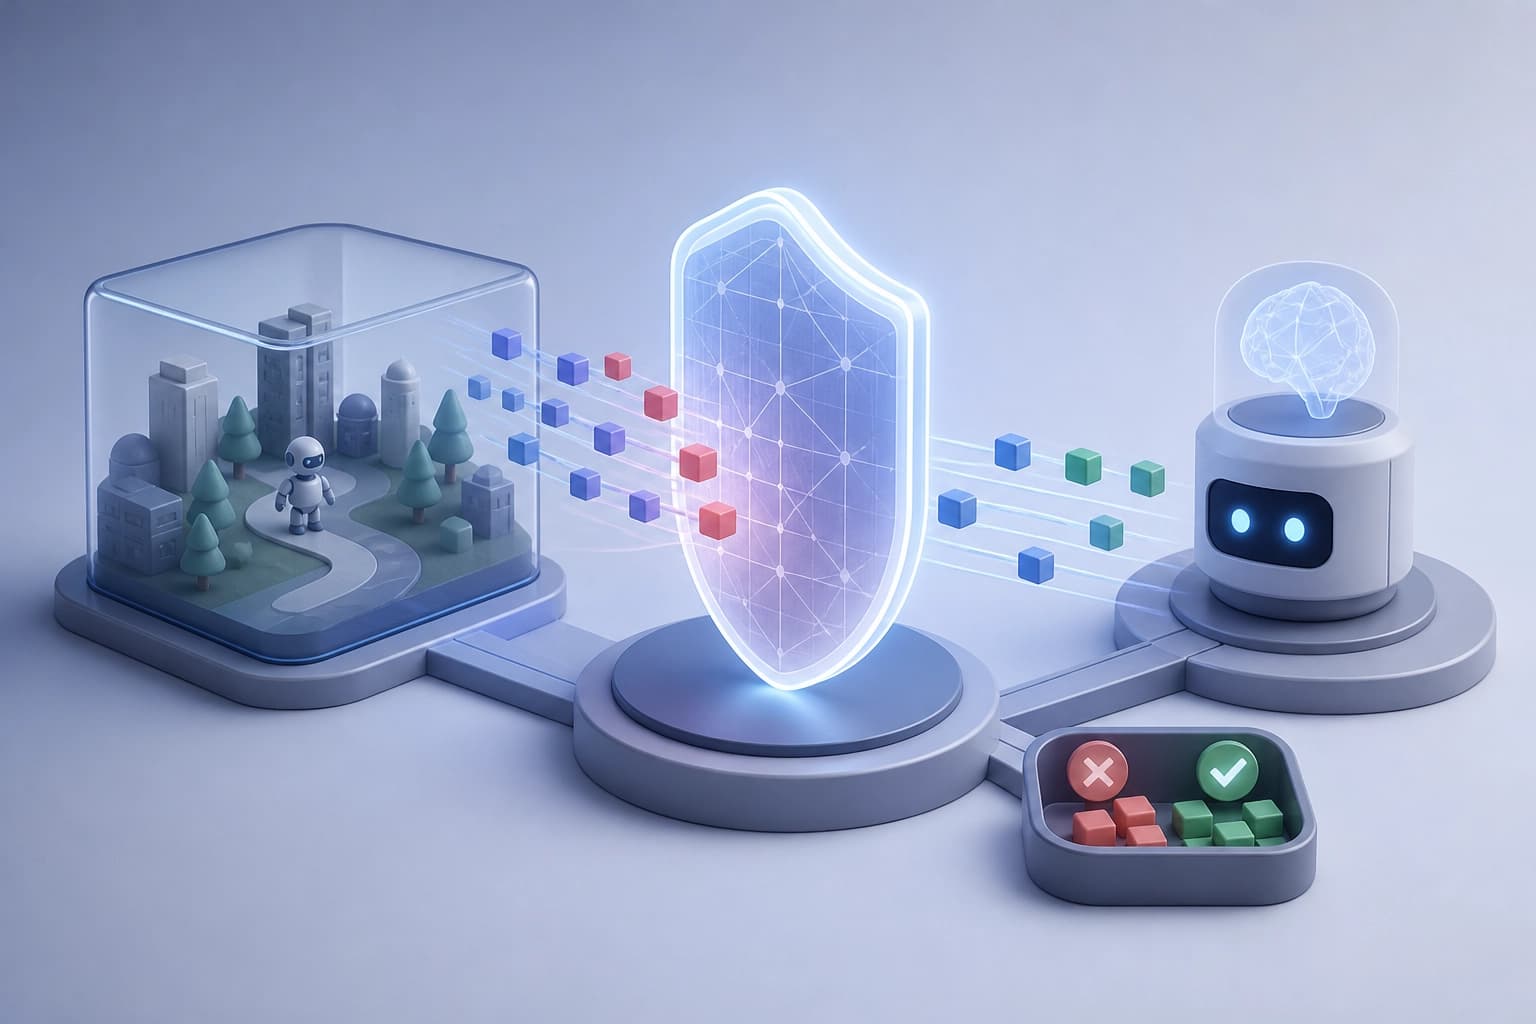
Проверка агентских политик без опоры на промпт: исполняемые среды, тестовые наборы и обучаемый фильтр
Работа предлагает фреймворк, который превращает исполняемые среды в наборы сценариев для проверки агентских политик и позволяет итеративно улучшать защитный компонент. Обученный фильтр снижает долю успешных нарушений на 40–44% относительно опоры только на инструкции в промпте и реже ошибочно отклоняет безопасные запросы.
20 ноября 2026
PerMIT: целостность долговременной памяти агентов на LLM и коллективное доверие с машинной проверкой
Авторы предлагают архитектуру PerMIT, которая ограничивает попадание недоверенных данных из среды в чувствительные действия агента через конечный интерфейс памяти; две теоремы, проверенные в Lean 4, и накопление вердиктов сообщества снижают риск отравления без роста нагрузки на отдельного пользователя. В экспериментах на Trojan Hippo и τ²-bench схема не зафиксировала успешных инъекций при лёгких верификаторах и улучшила результаты новых агентов на отложенных задачах.
20 ноября 2026