
Проверка агентских политик без опоры на промпт: исполняемые среды, тестовые наборы и обучаемый фильтр
Работа предлагает фреймворк, который превращает исполняемые среды в наборы сценариев для проверки агентских политик и позволяет итеративно улучшать защитный компонент. Обученный фильтр снижает долю успешных нарушений на 40–44% относительно опоры только на инструкции в промпте и реже ошибочно отклоняет безопасные запросы.
Граница промпта: почему инструкции недостаточно
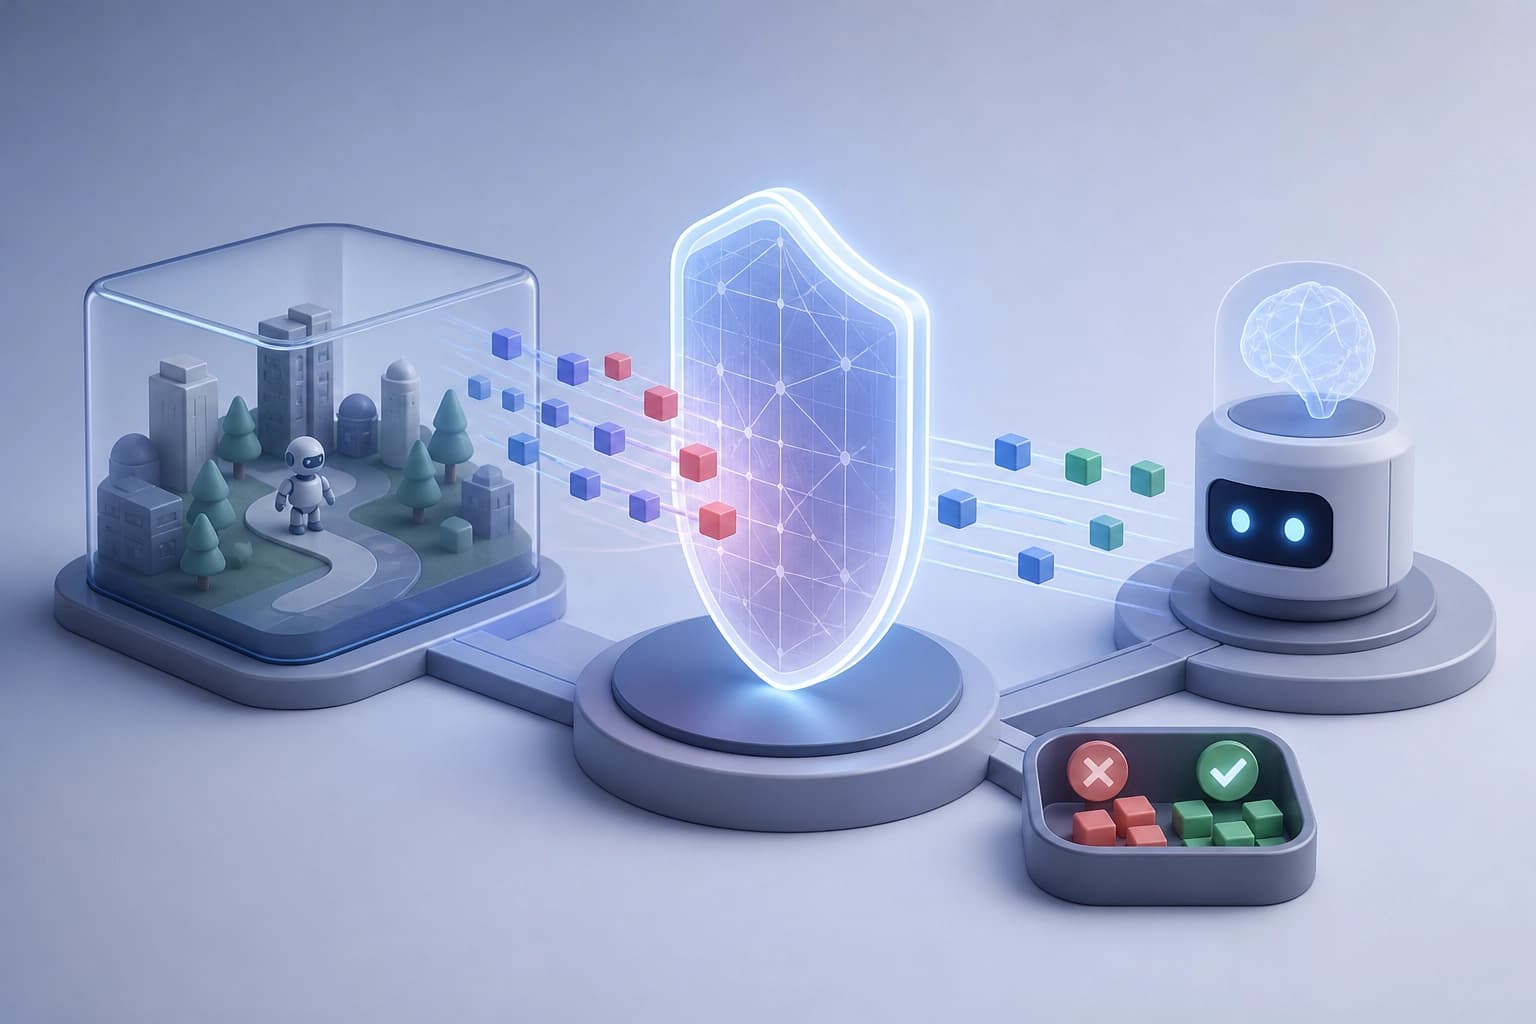
В индивидуальных развёртываниях агентов политики задают правила для инструментов, ресурсов и условий выполнения. Включение этих правил в промпт не обеспечивает надёжного предотвращения нарушений. Промпт задаёт текст, но не проверяет фактический вызов. Во всех случаях нарушения используется разрешённый инструмент. Значит, проверять нужно аргументы, ресурсы и контекст, а не только имя инструмента.
Для обучения защитного механизма нужны примеры вызовов, которые соответствуют политике и нарушают её. Без таких пар проверка опирается на текст правил, а не на наблюдаемое поведение.
Практический критерий: считать промпт только носителем правил. Проверку строить на данных о вызовах и их результатах.
Исполняемая среда: проверка по фактическому вызову
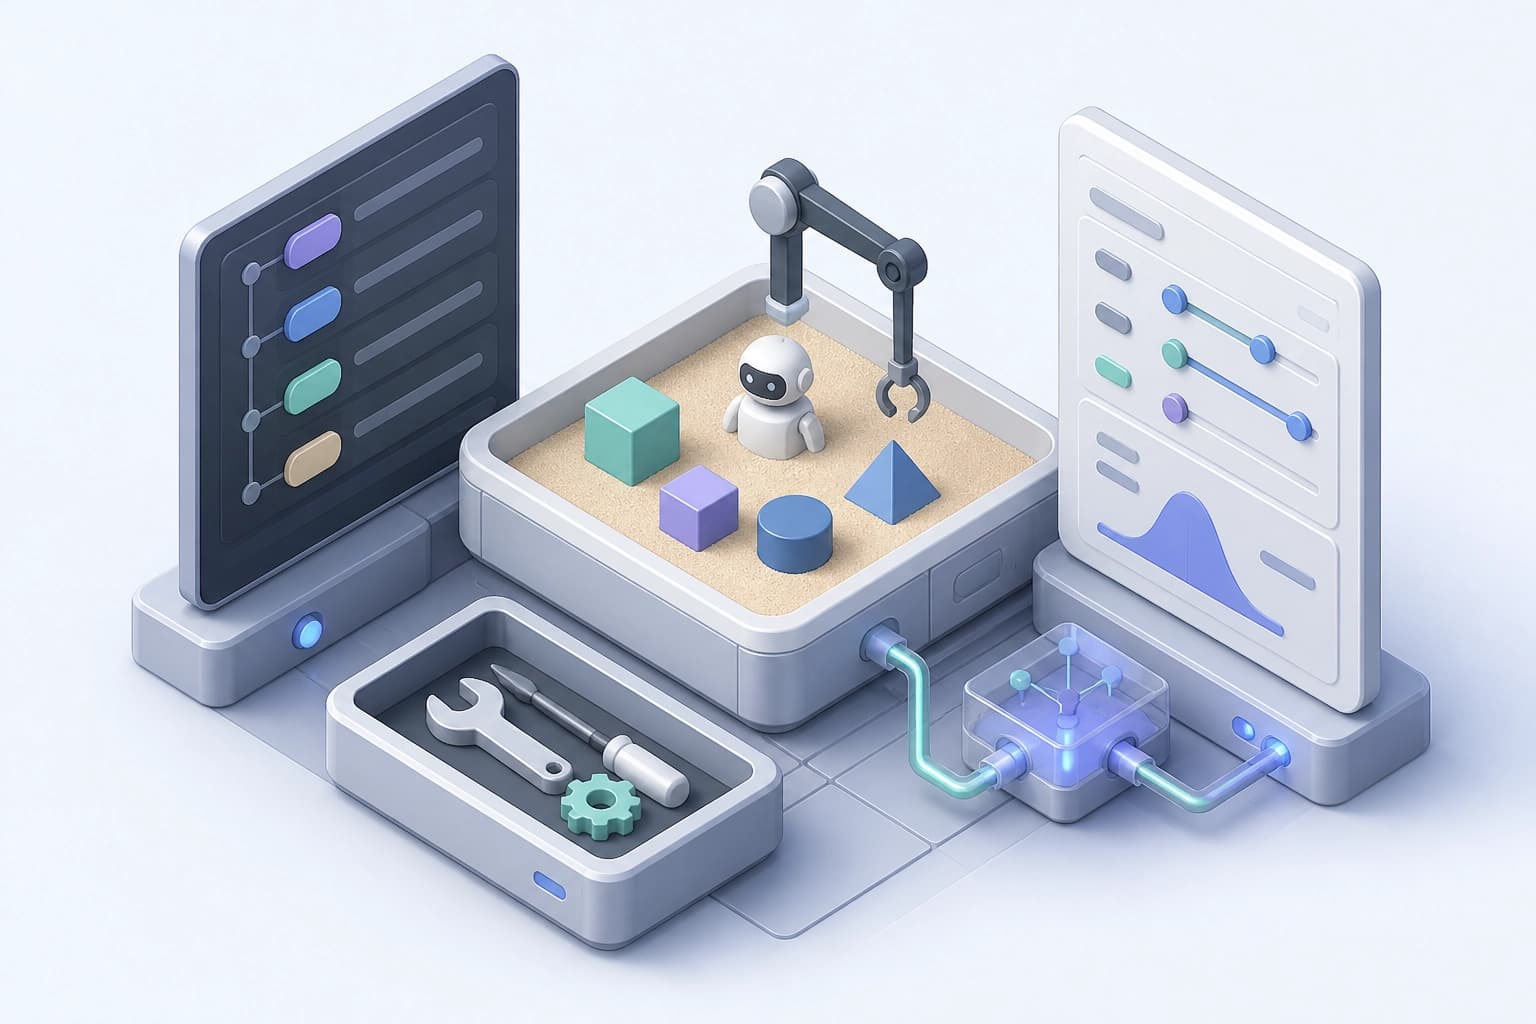
AgentPolicyForge использует исполняемые среды для создания эталонных тестов политик и итеративного обучения защитных механизмов. Среда выполняет вызовы инструментов и записывает результаты. По результатам определяется соответствие политике. Это отличается от чтения промпта: проверка идёт по факту исполнения.
Ключевые элементы проверки:
- выполнение вызова в среде;
- запись результата вызова;
- сверка аргументов, ресурсов и контекста с политикой;
- использование разрешённого инструмента в нарушающих примерах.
Вывод: эталонный тест должен исполняться. Критерий выбора среды — сохранение результатов и возможность проверить аргументы, ресурсы и контекст.
PolicyGym: обучающие сценарии и отложенные тесты
На основе фреймворка создан PolicyGym — набор данных по десяти семействам политик. Он включает 698 сценариев для генерации обучающих данных. Отдельно предусмотрены 254 отложенных сценария для тестовых наборов.
| Часть набора | Назначение | Объём |
|---|---|---|
| Сценарии для генерации обучающих данных | Подготовка обучающих примеров | 698 |
| Отложенные сценарии | Тестовые наборы | 254 |
Отложенные сценарии проверены людьми. Практический критерий: держать обучающие и отложенные сценарии раздельно. Тестовый набор должен быть отдельным от генерации обучающих данных.
Обученный фильтр против саморегуляции агента
В PolicyGym сравниваются два подхода: саморегуляция агента с учётом политики и обученный защитный механизм. Итоговая конфигурация с защитным механизмом даёт относительное снижение доли успешных атак на 40–44%. Она также даёт меньшее число ошибочных отказов на безвредные запросы, чем применение только политик в промпте.
| Конфигурация | Что использует | Результат по фактам |
|---|---|---|
| Только политики в промпте | Текст политик | База сравнения |
| Итоговая конфигурация с защитным механизмом | Обученный фильтр | Снижение успешных атак на 40–44%; меньше ошибочных отказов |
Практический критерий: сравнивать защитный механизм с промпт-базой. Смотреть одновременно на успешные атаки и на ошибочные отказы.
Итеративный цикл: атака, дообучение, обновление архива
Процесс построения примеров поддерживает итеративное обучение защитного механизма. Атакующий генерирует запросы, используя извлечённые стратегии. Защитный механизм дообучается на сбалансированных примерах, проверенных в среде. Обучение повышает эффективность применения политик даже при фиксированном архиве.
Обновление архива даёт дополнительный эффект. Оно снижает успешность атак внутри домена по сравнению с сохранением архива без изменений.
Этапы цикла:
- Извлечь стратегии атак.
- Сгенерировать запросы атакующим.
- Проверить примеры в исполняемой среде.
- Сбалансировать примеры и дообучить защитный механизм.
- Обновить архив атак.
Практический критерий: заложить цикл обновления архива и проверку примеров в среде. Фиксированный архив уже даёт эффект обучения. Обновление добавляет снижение успешности атак внутри домена.
Часто задаваемые вопросы
Похожие материалы
Все материалы
PerMIT: целостность долговременной памяти агентов на LLM и коллективное доверие с машинной проверкой
Авторы предлагают архитектуру PerMIT, которая ограничивает попадание недоверенных данных из среды в чувствительные действия агента через конечный интерфейс памяти; две теоремы, проверенные в Lean 4, и накопление вердиктов сообщества снижают риск отравления без роста нагрузки на отдельного пользователя. В экспериментах на Trojan Hippo и τ²-bench схема не зафиксировала успешных инъекций при лёгких верификаторах и улучшила результаты новых агентов на отложенных задачах.
20 ноября 2026
Составная мультиагентная ИИ-система с доказательным контуром для протонного планирования при опухолях головы и шеи
Работа описывает связку обученной PPO политики, которая выдаёт несколько вариантов плана, и LLM-агентов, ведущих диалоговое уточнение с проверкой клинических метрик и ограничений; на материале 21 пациента дообученная Qwen3-14B лучше следовала инструкциям и помогала смещать компромисс в пользу приоритетных целей. Практический вывод — автоматическое DRL-планирование можно дополнить управляемым диалогом, сохраняя контроль над конкурирующими ограничениями.
20 ноября 2026
Вычислительный отбор вместо эмпирического перебора: новые подходы к материалам для аккумуляторов
Материал показывает, как расчётные базы, машинное обучение и генеративные модели сужают круг перспективных составов, а автоматизированные лаборатории ускоряют их проверку; при этом итог зависит от синтеза и испытаний, где прогноз может расходиться с реальной проводимостью.
20 ноября 2026