Лента

275 материалов

Сортировка
Новости13 сентября 2026

Google запускает Motion Assist на Android 17: точки против укачивания добрались до Pixel

На Pixel с Android 17 через сервисы Google начали поэтапно включать функцию Motion Assist: по краям экрана появляются движущиеся точки, которые помогают снизить укачивание в транспорте. Пользователи могут активировать её вручную или настроить автозапуск при поездке.
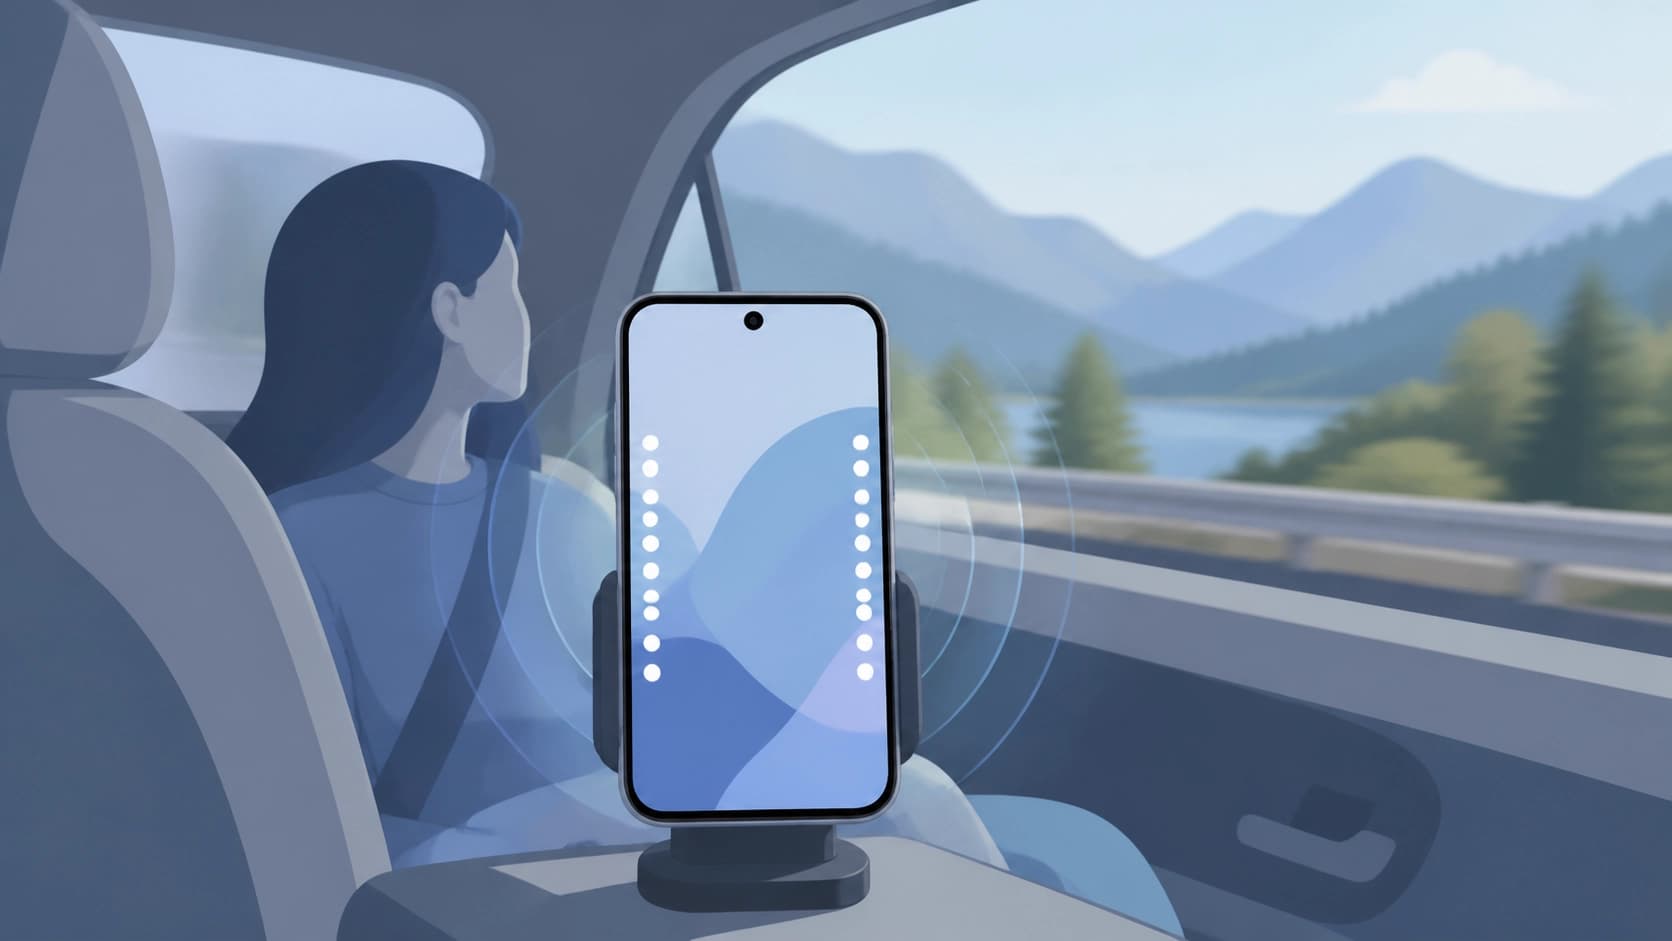
Google запускает Motion Assist на Android 17: точки против укачивания добрались до Pixel
Читать
Новости13 сентября 2026

Perplexity запустила «портативный компьютер» на NVIDIA DGX Spark: локальные агенты, OS-песочница и оплата только за облачные шаги

Новинка объединяет агентскую обвязку, планировщик, инструменты и коннекторы в единую систему на собственном GPU. Локальные задачи не тарифицируются за токен, а перед отправкой шага в облако система показывает пользователю, какие данные покинут устройство.

Perplexity запустила «портативный компьютер» на NVIDIA DGX Spark: локальные агенты, OS-песочница и оплата только за облачные шаги
Читать
Новости13 сентября 2026

DiaLLM: почему LLM понимают английские диалекты, но упорно говорят на стандартном английском

Новое исследование на трех семействах открытых моделей показало, что устойчивость к диалектам и их генерация развиваются независимо. Дополнительное выравнивание заметно меняет стиль ответов, но не всегда в сторону, которую предпочитают люди.

DiaLLM: почему LLM понимают английские диалекты, но упорно говорят на стандартном английском
Читать
Новости13 сентября 2026

SocraticPO: как «учитель» направляет рассуждения LLM в RL вместо простого бинарного вознаграждения

Исследователи представили фреймворк, который встраивает сократические текстовые подсказки прямо в роллауты обучения с подкреплением: сначала модель отвечает сама, а при ошибке получает от учителя короткую диагностику и указания. Научная работа показывает, что такой подход сокращает склонность к срезам пути и превосходит стандартные RL-методы на бенчмарках SciKnowEval уровня бакалавриата.

SocraticPO: как «учитель» направляет рассуждения LLM в RL вместо простого бинарного вознаграждения
Читать
Новости13 сентября 2026

Создатель Stable Diffusion закрыл раунд на 76 миллионов долларов

Инвесторами Stability AI выступили звукозаписывающие мейджоры и игровые компании, а общий объем привлеченных средств достиг 232 миллионов долларов. Деньги пойдут на развитие инструментов для креативной индустрии и профессиональных сервисов.

Создатель Stable Diffusion закрыл раунд на 76 миллионов долларов
Читать
Новости13 сентября 2026

Контрастивный взгляд на GRPO: почему текущая цель RLVR неидеальна и как её чинит ConSPO

В новой работе GRPO интерпретируется как разделяющий классификатор: политика учится увеличивать разницу в оценках между удачными и неудачными сэмплами. Такой взгляд обнажает два изъяна в целевой функции, а предложенный авторами метод ConSPO устраняет их с помощью нормированных логарифмических вероятностей и InfoNCE-подобного контрастивного обучения, что даёт прирост на сложных задачах рассуждений.

Контрастивный взгляд на GRPO: почему текущая цель RLVR неидеальна и как её чинит ConSPO
Читать
Новости13 сентября 2026

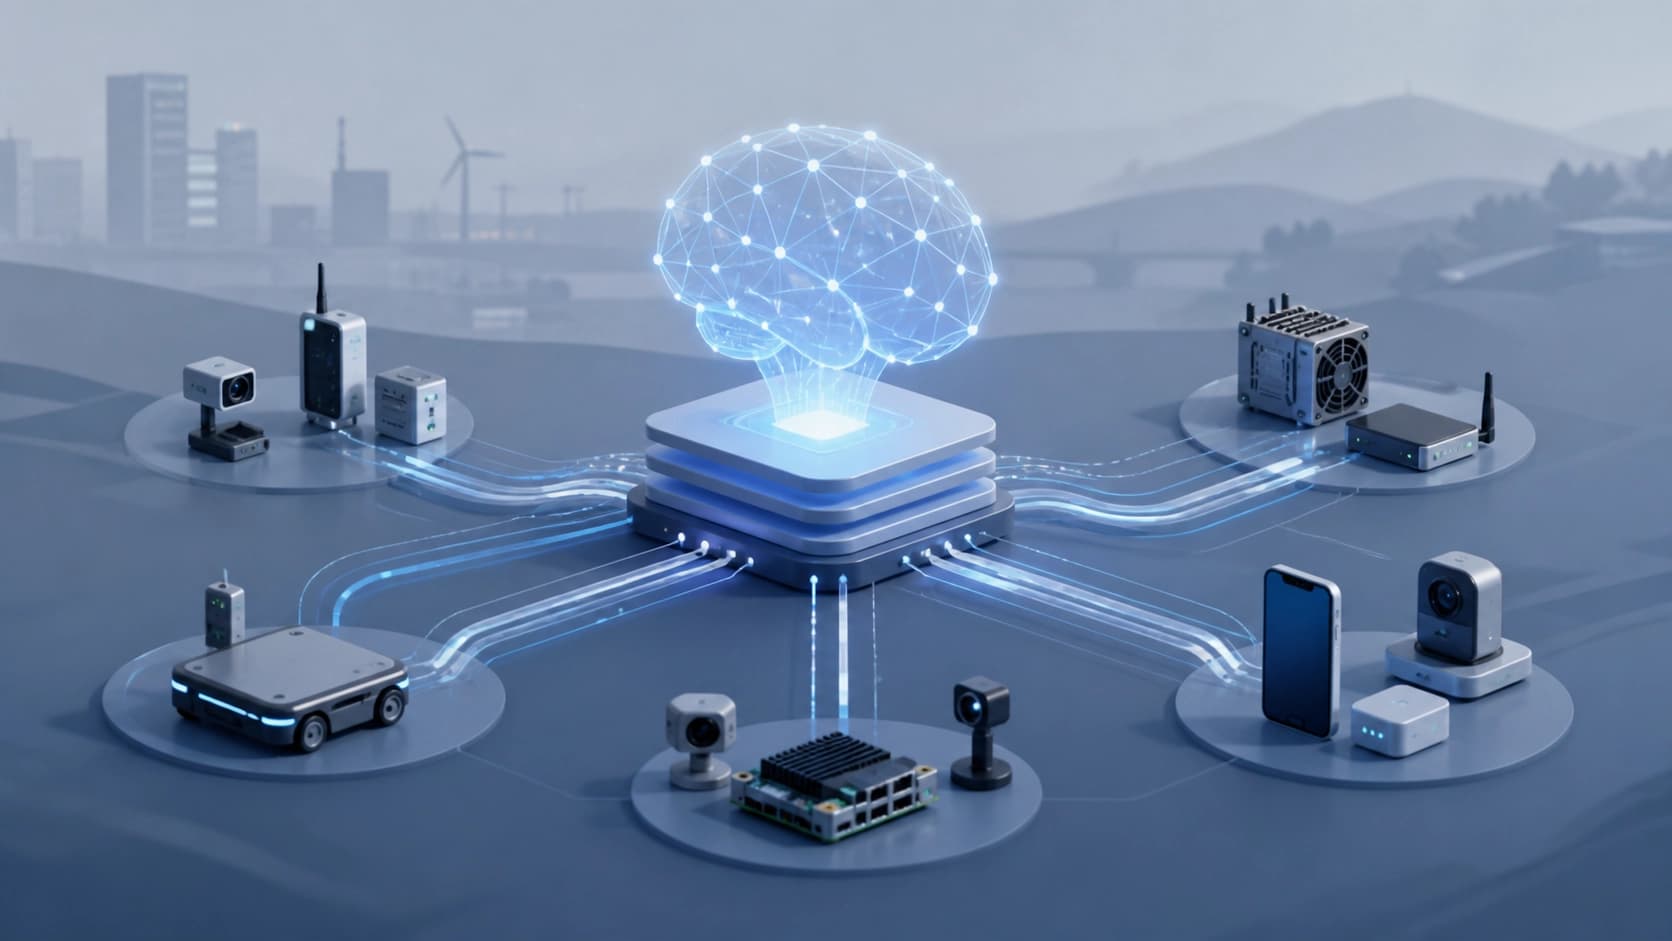
Как E2LLM разворачивает большие языковые модели на разнородных Edge/Fog-устройствах

Фреймворк объединяет слабые узлы в группы-реплики и по-разному распределяет фазы обработки токенов, чтобы эффективно использовать ограниченные ресурсы. В тестах такой подход почти вдвое сокращал среднее время ответа по сравнению с известной схемой Splitwise.

Как E2LLM разворачивает большие языковые модели на разнородных Edge/Fog-устройствах
Читать
Новости13 сентября 2026

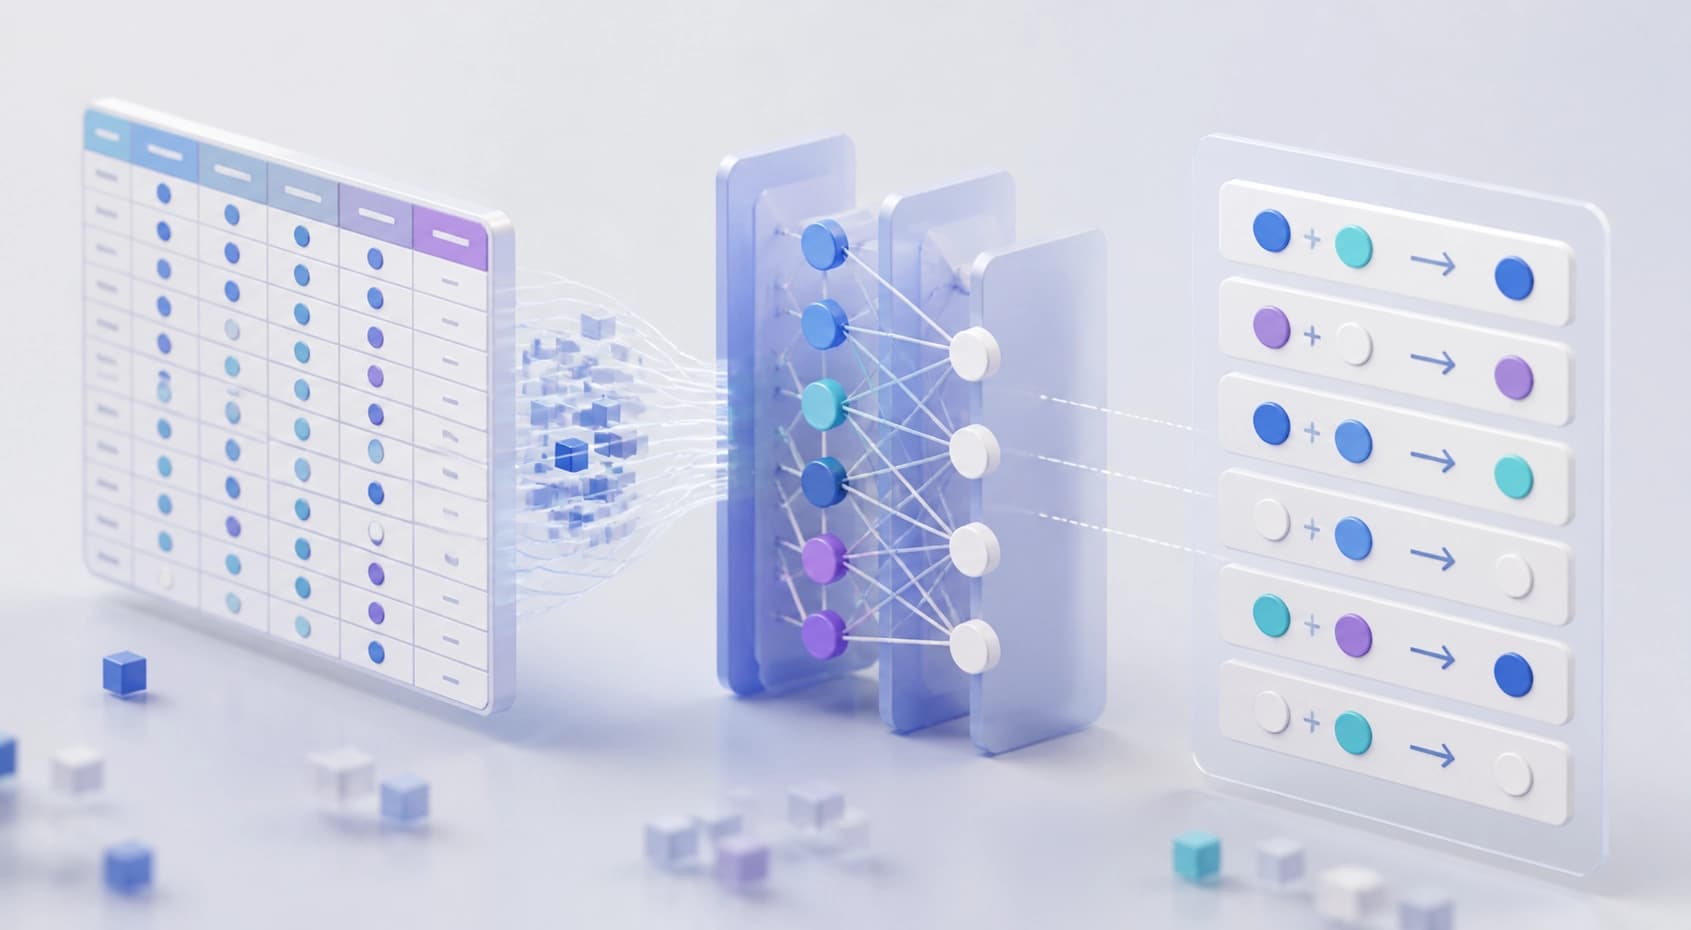
BIRDNet: нейросеть извлекает булевы правила прямо из табличных данных и остаётся прозрачной

Метод строит компактную сеть, где каждый скрытый блок соответствует одному найденному правилу связи между парой признаков. На биомедицинских данных BIRDNet почти не уступает плотным аналогам по точности, но требует кратно меньше активных параметров и позволяет читать правила без дополнительных объясняющих моделей.

BIRDNet: нейросеть извлекает булевы правила прямо из табличных данных и остаётся прозрачной
Читать
Новости13 сентября 2026

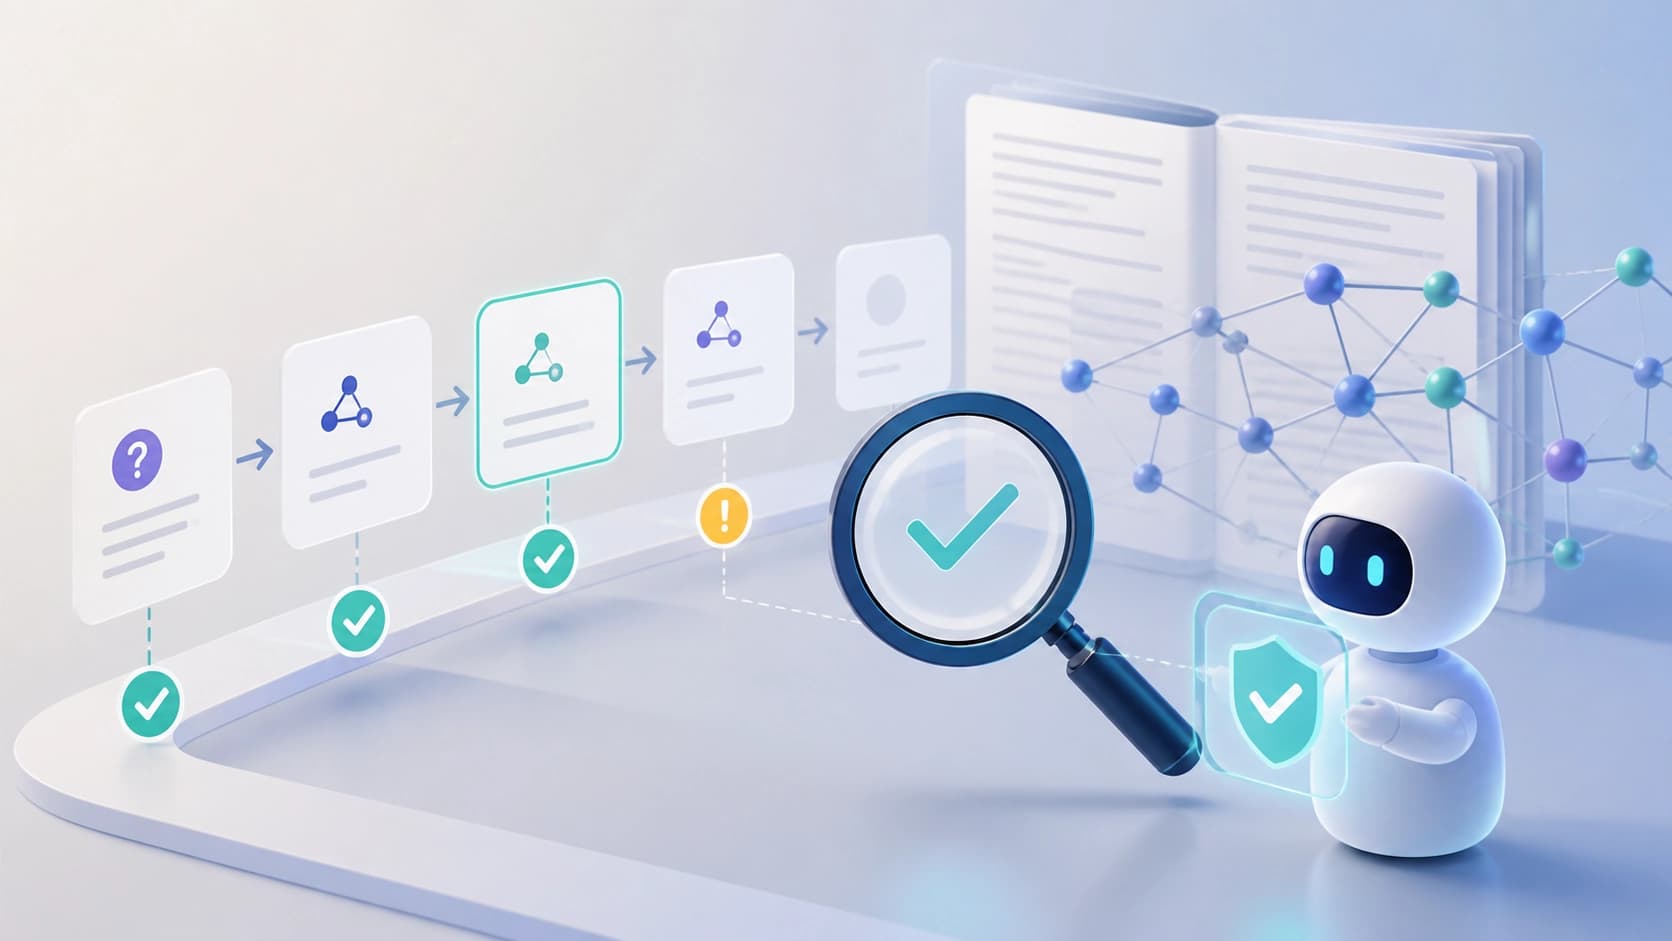
SAFE: как проверять каждое звено многошаговых рассуждений LLM на лету

Многошаговые QA-бенчмарки нередко засчитывают правильный ответ, полученный через логически неверные рассуждения. Фреймворк SAFE закрывает этот пробел: внешний LLM-верификатор сверяет каждый шаг с опорными текстами и предыдущей траекторией, а разбиение на KG-триплеты упрощает проверку. По данным авторов, на трёх бенчмарках точность выросла в среднем на 8,8 процентного пункта.

SAFE: как проверять каждое звено многошаговых рассуждений LLM на лету
Читать