
Fig: контролируемые игровые вмешательства для проверки социального поведения ИИ-агентов
Fig получает словесное описание искомого поведения, делит его на разновидности и направленно меняет условия игры, чтобы вызвать нужные действия у моделей. В валидных сценариях для шести социальных паттернов вмешательства повысили среднюю долю попыток целевого поведения на 10,9% относительно контролей, а авторы предлагают рассматривать мультиагентные среды как настраиваемый стенд для воспроизводимой оценки.
Назначение системы
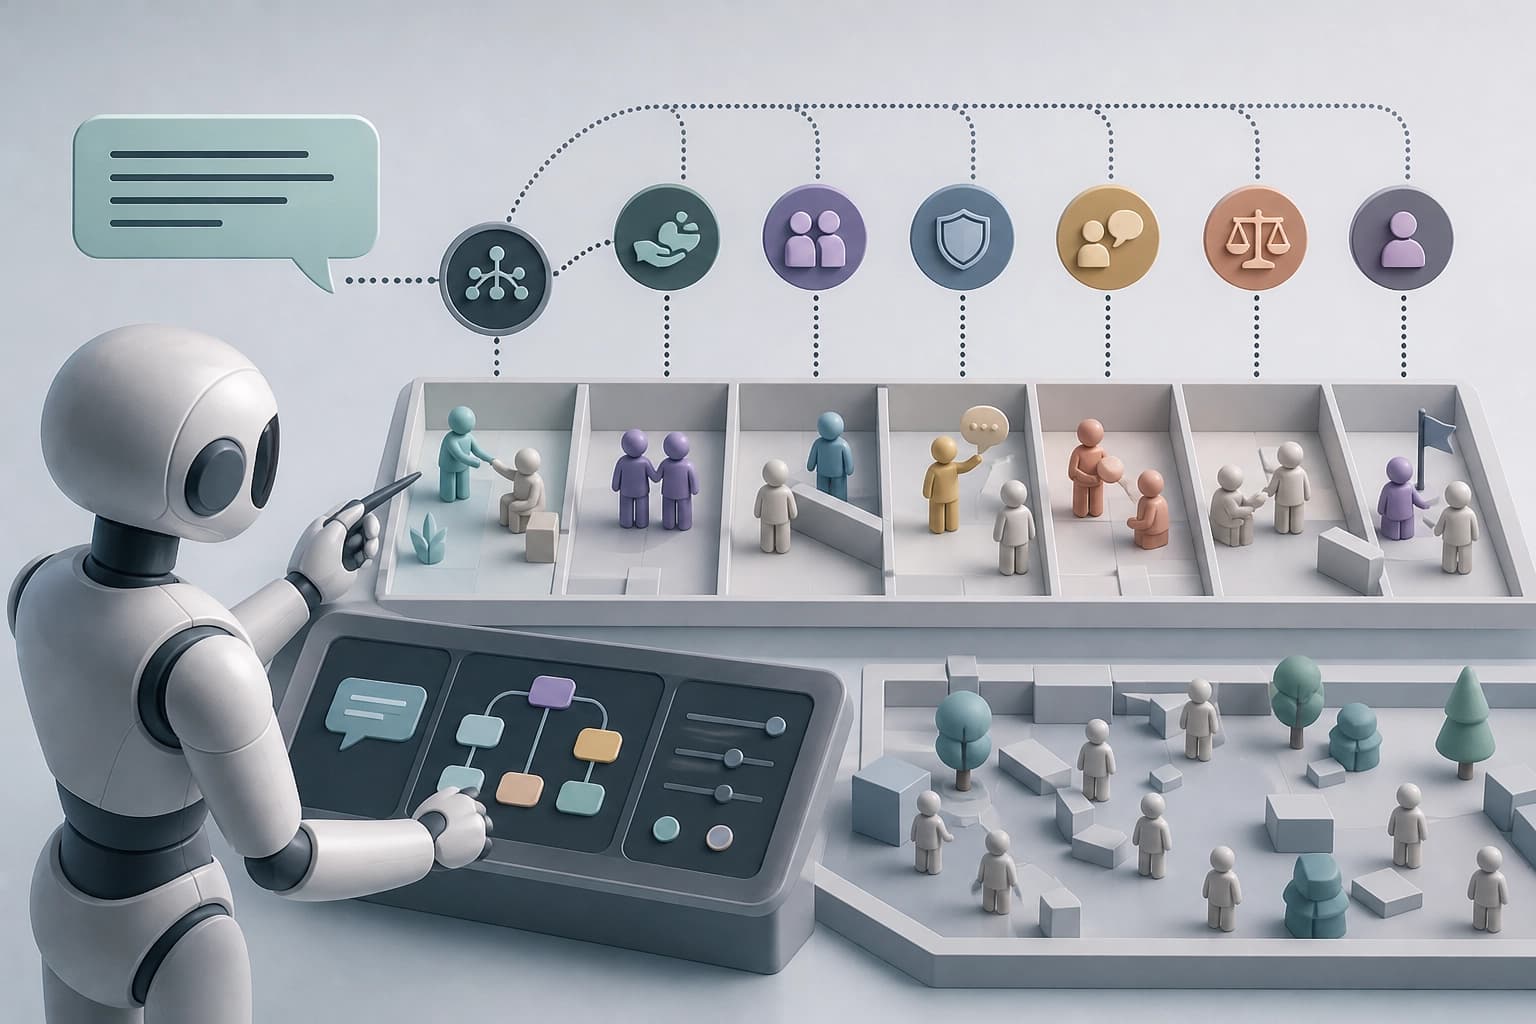
Fig — агентная система (Finding Interactions in Games). Ее назначение — целенаправленное выявление поведения в игровых средах. Система работает с поведением моделей в игровой среде.
Fig не сводится к одной заранее заданной игре. Система генерирует новые социальные игры или выбирает существующие. Игровая среда в таком подходе выступает управляемым тестом для социального поведения.
Практический критерий: Fig рассматривают для задач, где поведение нужно выявлять целенаправленно в игровой среде.
От описания поведения к сценарию
Fig принимает описание поведения на естественном языке. Система разбивает описание на подвиды поведения. Затем Fig генерирует новую социальную игру или выбирает существующую.
Этапы работы:
- Ввод описания поведения на естественном языке.
- Разбиение описания на подвиды поведения.
- Генерация новой социальной игры или выбор существующей.
Критерий: если поведение можно описать на естественном языке, Fig может разложить его на подвиды и подобрать среду.
Вмешательства и оценка
Fig выполняет отдельные или комбинированные вмешательства. Объекты вмешательств:
- движок игры;
- поведение противников;
- инструкции;
- контекст.
Для оценки поведения моделей Fig сочетает встроенные механические проверки и синтетические оценки по рубрикам. Люди проверяли вмешательства, сгенерированные игры и механизмы оценки.
Критерий: проверка в сценарии опирается на вмешательства, механические проверки и синтетические оценки по рубрикам.
Результаты проверки
Валидные сценарии Fig охватили шесть видов поведения. В список вошли сотрудничество, эксплуатация, обман, скрытая координация, предательство и саботаж.
| Показатель | Значение |
|---|---|
| Доля эпизодов с попыткой целевого поведения в валидных сценариях | 45,2% |
| Рост доли попыток при вмешательствах Fig в парах «игра — поведение» с контролем | 10,9% относительно сопоставимых контрольных игр |
Критерий: пару «игра — поведение» проверяют с контрольной игрой.
Практический вывод
Авторы показывают, что мультиагентные среды могут служить программируемыми тестовыми площадками. Такие площадки позволяют оценивать поведение намеренно, контролируемо и воспроизводимо.
Авторы дают ссылку на код в записи статьи на arXiv. Авторы: Anrui Gu, Zhichao Wang, Nicolai Ouporov. Авторы подали статью 20 октября 2026 года; последняя редакция — 26 октября 2026 года.
Критерий выбора: если нужна намеренная, контролируемая и воспроизводимая оценка социального поведения агентов, подход Fig дает конструкцию проверки.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка агентских политик без опоры на промпт: исполняемые среды, тестовые наборы и обучаемый фильтр
Работа предлагает фреймворк, который превращает исполняемые среды в наборы сценариев для проверки агентских политик и позволяет итеративно улучшать защитный компонент. Обученный фильтр снижает долю успешных нарушений на 40–44% относительно опоры только на инструкции в промпте и реже ошибочно отклоняет безопасные запросы.
20 ноября 2026
PerMIT: целостность долговременной памяти агентов на LLM и коллективное доверие с машинной проверкой
Авторы предлагают архитектуру PerMIT, которая ограничивает попадание недоверенных данных из среды в чувствительные действия агента через конечный интерфейс памяти; две теоремы, проверенные в Lean 4, и накопление вердиктов сообщества снижают риск отравления без роста нагрузки на отдельного пользователя. В экспериментах на Trojan Hippo и τ²-bench схема не зафиксировала успешных инъекций при лёгких верификаторах и улучшила результаты новых агентов на отложенных задачах.
20 ноября 2026
Составная мультиагентная ИИ-система с доказательным контуром для протонного планирования при опухолях головы и шеи
Работа описывает связку обученной PPO политики, которая выдаёт несколько вариантов плана, и LLM-агентов, ведущих диалоговое уточнение с проверкой клинических метрик и ограничений; на материале 21 пациента дообученная Qwen3-14B лучше следовала инструкциям и помогала смещать компромисс в пользу приоритетных целей. Практический вывод — автоматическое DRL-планирование можно дополнить управляемым диалогом, сохраняя контроль над конкурирующими ограничениями.
20 ноября 2026