
PerMIT: целостность долговременной памяти агентов на LLM и коллективное доверие с машинной проверкой
Авторы предлагают архитектуру PerMIT, которая ограничивает попадание недоверенных данных из среды в чувствительные действия агента через конечный интерфейс памяти; две теоремы, проверенные в Lean 4, и накопление вердиктов сообщества снижают риск отравления без роста нагрузки на отдельного пользователя. В экспериментах на Trojan Hippo и τ²-bench схема не зафиксировала успешных инъекций при лёгких верификаторах и улучшила результаты новых агентов на отложенных задачах.
PerMIT — архитектура памяти для LLM-агентов. Статья Tanqiu Jiang, Min Bai, Sadat Shahriar, Wanyu Du и Sandesh Swamy подана 20 октября 2026 года; arXiv:2610.28987.
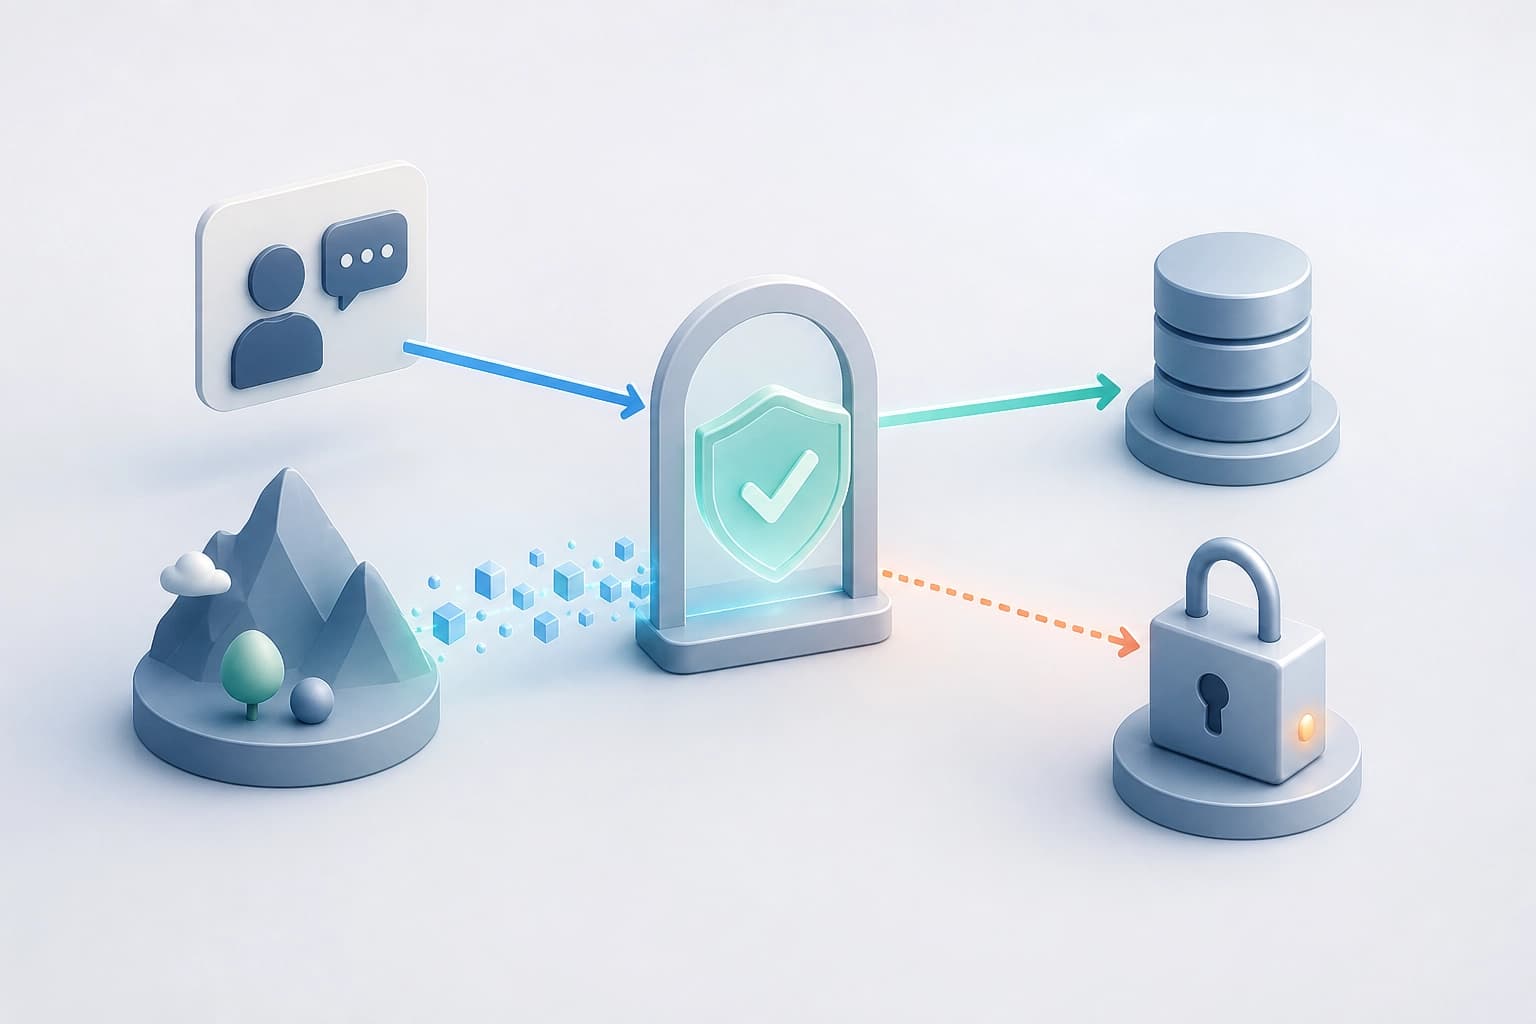
Модель доверия
PerMIT задаёт явное предположение о доверии. Доверенными считаются только введённые пользователем данные и значения, подтверждённые на gate. Все значения из среды остаются недоверенными. Архитектура регулирует их передачу и использование через конечный интерфейс памяти. Планирование агента в несколько ходов и выбор инструментов сохраняются.
Практический критерий: сценарий подходит, если пользовательский ввод считается доверенным, а данные среды — нет.
Gate и проверяемые решения
Конечный интерфейс памяти опирается на gate. Авторы доказывают для интерфейса две теоремы целостности. Теоремы проходят машинную проверку в Lean 4. Вместе они гарантируют два свойства. Память из среды достигает чувствительного действия только после подтверждения на gate. Поведение агента меняется только через то, что показывает gate.
В рамках модели угроз каждая атака сводится к одному проверяемому решению. На практике решение принимает человек, LLM-верификатор или оба.
Практический критерий: защита применима в рамках модели угроз, где атака сводится к одному проверяемому решению.
Подтверждения и коллективное доверие
Каждое подтверждение — это записанный вердикт о точном содержимом. Подтверждения накапливаются между пользователями. Достаточно поддержанные элементы становятся подтверждёнными сообществом без дальнейшей проверки.
При явных предположениях авторы доказывают свойство совместного масштабирования. Они также подтверждают его в симуляции. По мере роста сообщества снижаются риски продвижения отравленных данных и ошибочного удаления доброкачественных знаний. Усилия отдельного пользователя на проверку не растут.
| Что меняется при росте сообщества | Направление |
|---|---|
| Риск продвижения отравленных данных | Снижается |
| Риск ошибочного удаления доброкачественных знаний | Снижается |
| Усилия отдельного пользователя на проверку | Не растут |
Практический критерий: коллективный слой уместен, когда вердикты привязаны к точному содержимому и накапливаются между пользователями.
Проверки
На Trojan Hippo PerMIT показал нулевой наблюдаемый успех атак. Результат получен при самопроверке и использовании лёгких верификаторов.
На τ²-bench сообщества численностью до 90 автономных агентов создают общие базы знаний с помощью PerMIT. Ни одна прямая инъекция в память не была продвинута. Полученные знания значительно улучшают результаты новых агентов на отложенных задачах.
Практический критерий — два результата: отсутствие продвижения прямых инъекций и улучшение новых агентов на отложенных задачах.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Составная мультиагентная ИИ-система с доказательным контуром для протонного планирования при опухолях головы и шеи
Работа описывает связку обученной PPO политики, которая выдаёт несколько вариантов плана, и LLM-агентов, ведущих диалоговое уточнение с проверкой клинических метрик и ограничений; на материале 21 пациента дообученная Qwen3-14B лучше следовала инструкциям и помогала смещать компромисс в пользу приоритетных целей. Практический вывод — автоматическое DRL-планирование можно дополнить управляемым диалогом, сохраняя контроль над конкурирующими ограничениями.
20 ноября 2026
Вычислительный отбор вместо эмпирического перебора: новые подходы к материалам для аккумуляторов
Материал показывает, как расчётные базы, машинное обучение и генеративные модели сужают круг перспективных составов, а автоматизированные лаборатории ускоряют их проверку; при этом итог зависит от синтеза и испытаний, где прогноз может расходиться с реальной проводимостью.
20 ноября 2026
Эволюция агентных стендов при масштабировании пула задач: роль отбора свидетельств и последовательных гонок
Работа объясняет, почему наращивание числа задач может ухудшать эволюцию агентных стендов: причина — неудачный выбор свидетельств, а не объём данных как таковой. Предложенный Successive Scale Racing поочерёдно подбирает разнообразные комбинации задач и недорого сравнивает кандидатов; на трёх бенчмарках это повысило долю успешных прогонов при росте пула с 40 до 200, тогда как базовые методы деградировали, а проверочных запусков стало примерно на 60% меньше.
19 ноября 2026