Длинная задача кодирующего агента — это не один запрос, а десятки: вызовы модели, обращения к инструментам, правки файлов, повторные прогоны тестов. И почти на каждом таком прогоне возникает мысль: а не поменять ли модель прямо сейчас?
Почему переключение на ходу выглядит выгодным
Экономика тут простая. Сильная модель дороже за токен, но лучше рассуждает. Слабая дешевле, но буксует на сложном. Отсюда два естественных манёвра:
- Эскалация — когда дешёвая модель застряла, подключаем дорогую и мощную.
- Понижение уровня — когда трудная часть позади, возвращаемся на дешёвую, чтобы не переплачивать за рутину.
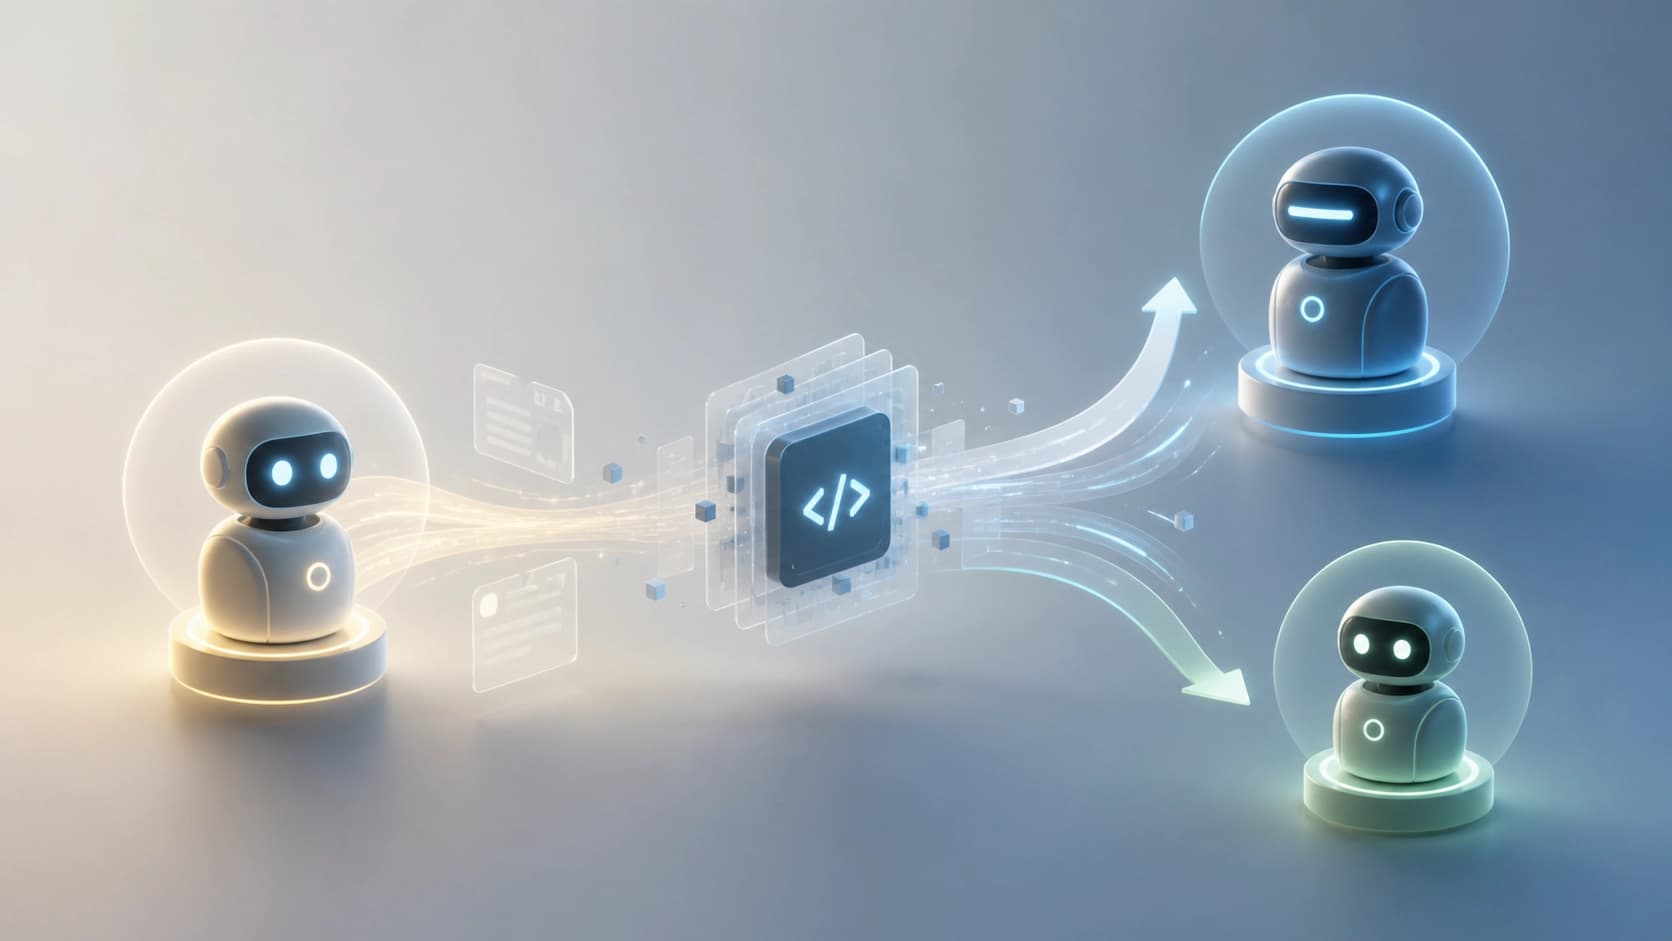
На бумаге гибридный маршрут выглядит идеально: дорогая модель оплачивается только там, где она действительно нужна. Но агент передаёт следующей модели не только файлы и состояние репозитория. Он передаёт историю: цепочку рассуждений, вывод инструментов, тупиковые попытки, промежуточные решения. Принимающая сторона продолжает траекторию, которую построила другая модель — с другим стилем, другой степенью детализации, другими привычками. Именно этот момент разбирают авторы препринта «The Handoff Tax: Continuing Non-Native Trajectories in LLM Agents» (arXiv:2608.24358, 25 августа 2026).
Как устроен эксперимент
Работа опирается на пары моделей: дешёвые и менее способные (в тексте статьи — LC, low cost) против дорогих и более сильных (HC, high cost). Пары взяты из двух семейств — Claude и GPT, то есть проверка шла не на одном вендоре, а на двух сразу, что заметно повышает ценность выводов.
Меняли три вещи:
- Направление передачи — вверх, к более сильной модели, и вниз, к более слабой.
- Момент переключения внутри длинной задачи.
- Формат передачи контекста — то, что авторы называют интерфейсом.
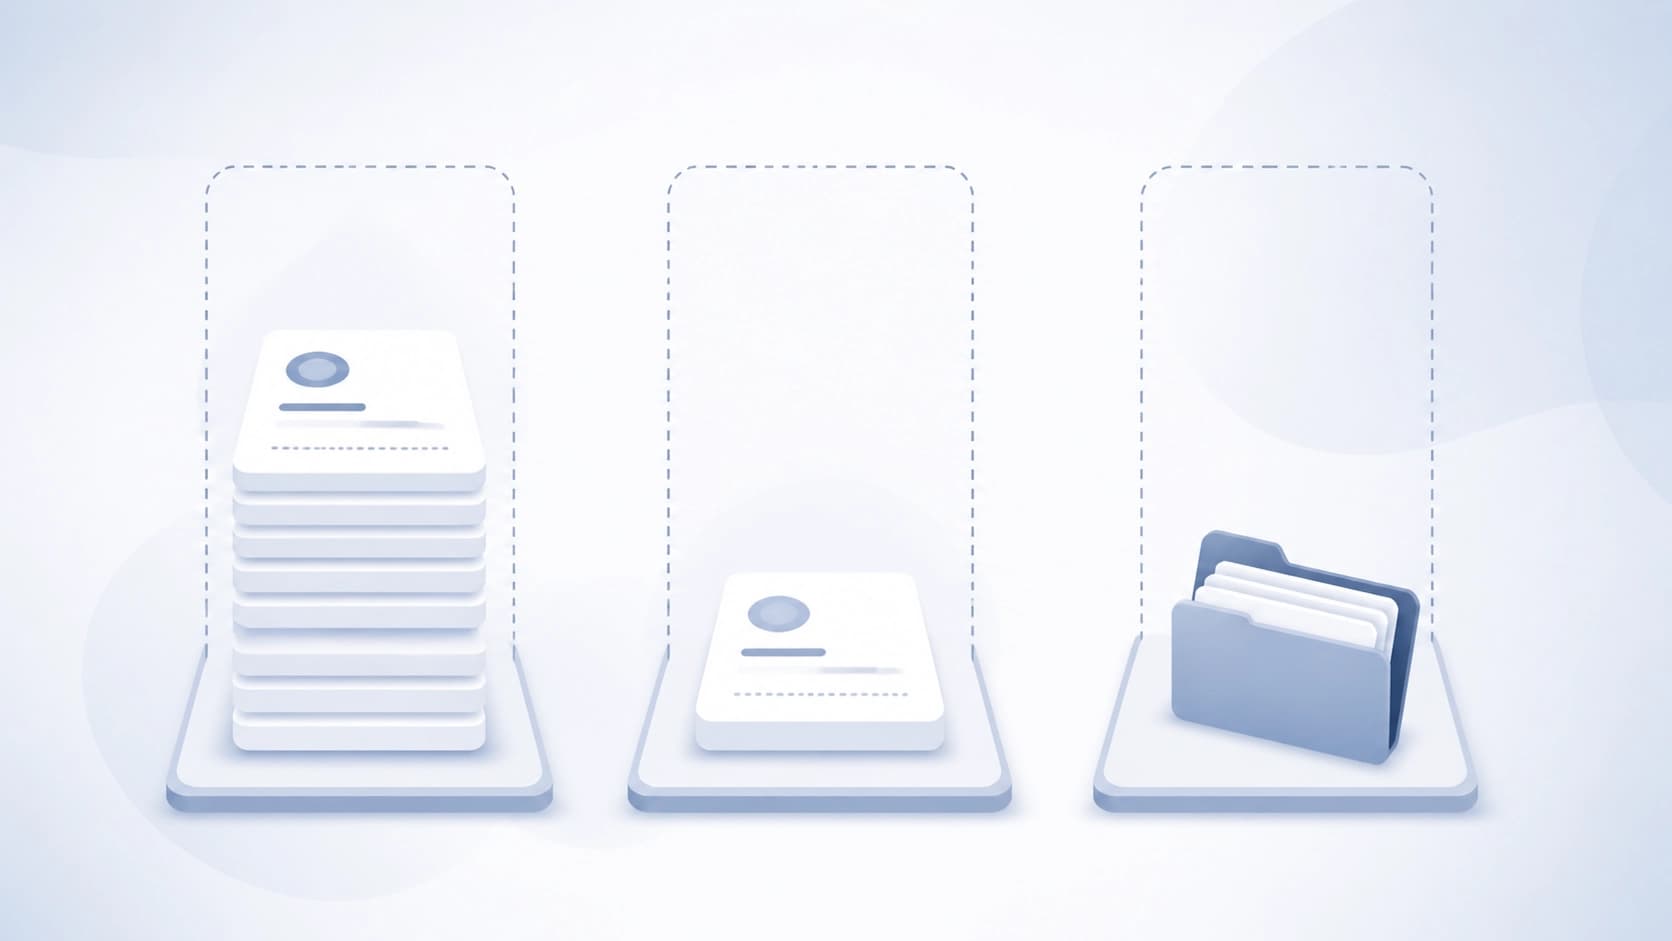
Последний пункт самый интересный. Сравнивались три варианта: полная передача всей траектории, компакция (сжатая выжимка из истории) и удаление траектории с сохранением только состояния репозитория. Иначе говоря, вопрос ставился так: сколько чужого «мышления» вообще стоит показывать новой модели?
Главный результат: налог на передачу
Вывод получился отрезвляющим. При эскалации полная передача истории закрывает меньше половины разрыва в качестве между слабой и сильной моделью — и сопровождается ощутимой надбавкой к стоимости. То есть вы платите по тарифу дорогой модели, но получаете лишь часть её преимущества. Разницу авторы и назвали handoff tax — налогом за передачу управления.
Причём это не артефакт одного вендора: картина повторилась в обоих семействах. Логичное объяснение — сильная модель тратит контекст на разбор чужого лабиринта, частично перенимает ошибочные допущения предшественника и стартует не с чистого листа, а с грузом. Часть её возможностей уходит на «чтение чужого дневника» вместо решения задачи.
Асимметрия: вниз — да, вверх — с оговорками
Самое полезное наблюдение в том, что налог не симметричен. Понижение уровня, наоборот, дало выгодную точку по соотношению цены и качества: переключение на дешёвую модель после завершения сложного рассуждения работает.
Ещё интереснее, что предпочтительный формат передачи контекста меняется на противоположный в зависимости от направления:
- При эскалации лучше помогает сокращение информации о траектории слабой модели. Меньше мусора — чище старт.
- При понижении удаление траектории сильной модели качество снижает. Здесь история работает как опора, и её стоит сохранять.
Объяснение напрашивается такое: за слабой моделью тянется след из тупиков, и сильной он только мешает. А за сильной — выверенный план и корректные решения, по которым слабая может идти как по рельсам. Это уже моя интерпретация, а не буквальный вывод статьи, но она хорошо согласуется с цифрами.
Что делать на практике
Практические выводы получаются такими:
- Переключайтесь реже, чем хочется. Каждое переключение — это не бесплатная операция, а сделка с неизвестной ценой.
- Эскалируйте на границе, а не «когда застряли». Хорошая точка — завершённый цикл с понятным провалом (например, тесты стабильно падают), а не середина размышления.
- Наверх — сжимайте, вниз — сохраняйте. Перед передачей сильной модели соберите компактную выжимку: что уже сделано, что не сработало, какие ограничения. Полную стенограмму попыток оставлять не стоит.
- Вниз можно отдавать щедро. Слабой модели полезно видеть план и правки, оставленные сильной.
- Считайте свой налог. Разница между «полная история» и «компакция» при эскалации — готовый A/B-тест, который стоит прогнать на собственных задачах: он дешёвый и быстро показывает, платите вы налог или нет.
Отдельная мысль: иногда дешевле вообще не менять модель посередине. Если сильная нужна только для планирования, логичнее развести роли заранее — план от сильной, исполнение слабой, — чем устраивать передачу управления внутри одной траектории.
Итог
Смена модели посреди задачи — не бесплатный рычаг оптимизации бюджета, а операция с собственной ценой. Передача чужой траектории съедает часть преимущества, за которое вы платите. Эскалация в этом смысле рискованнее, чем кажется; понижение уровня, наоборот, работает предсказуемо. И главный практический приём лежит не в выборе модели, а в выборе того, что именно вы этой модели показываете. Результаты получены на кодирующих агентах и конкретных парах моделей, так что переносить их один в один на все сценарии не стоит — но как рабочая гипотеза для собственных замеров они вполне годятся.