Почему оценку голосовых агентов так трудно автоматизировать
Разговорный голосовой агент — это не одна модель, а конвейер: распознавание речи, рассуждение, вызов инструментов, генерация ответа, синтез и стриминг аудио. Сбой на любой стадии не остаётся локальным — он тянется дальше по цепочке и всплывает уже в самом диалоге. Именно поэтому судить о качестве взаимодействия имеет смысл только целиком, end-to-end, а не по отдельным звеньям.
Держать штат живых оценщиков дорого и неудобно: их не масштабируешь на сотни тысяч разговоров, а их внимание проседает к концу смены. Естественный выход — отдать оценку языковой модели. Свежий препринт arXiv:2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) как раз проверяет, насколько такой выход оправдан и где он ломается.
Как авторы проверяли LLM-судей
Эксперимент построен на реальных разговорах голосовых агентов из двух отраслей — телекома и ритейла. Человеческие оценки сопоставлялись с вердиктами GPT-4.1 и GPT-5, причём не по одной обобщённой шкале, а по десяти метрикам: часть описывает качество самого разговора, часть — безопасность.
Три конфигурации вместо одной
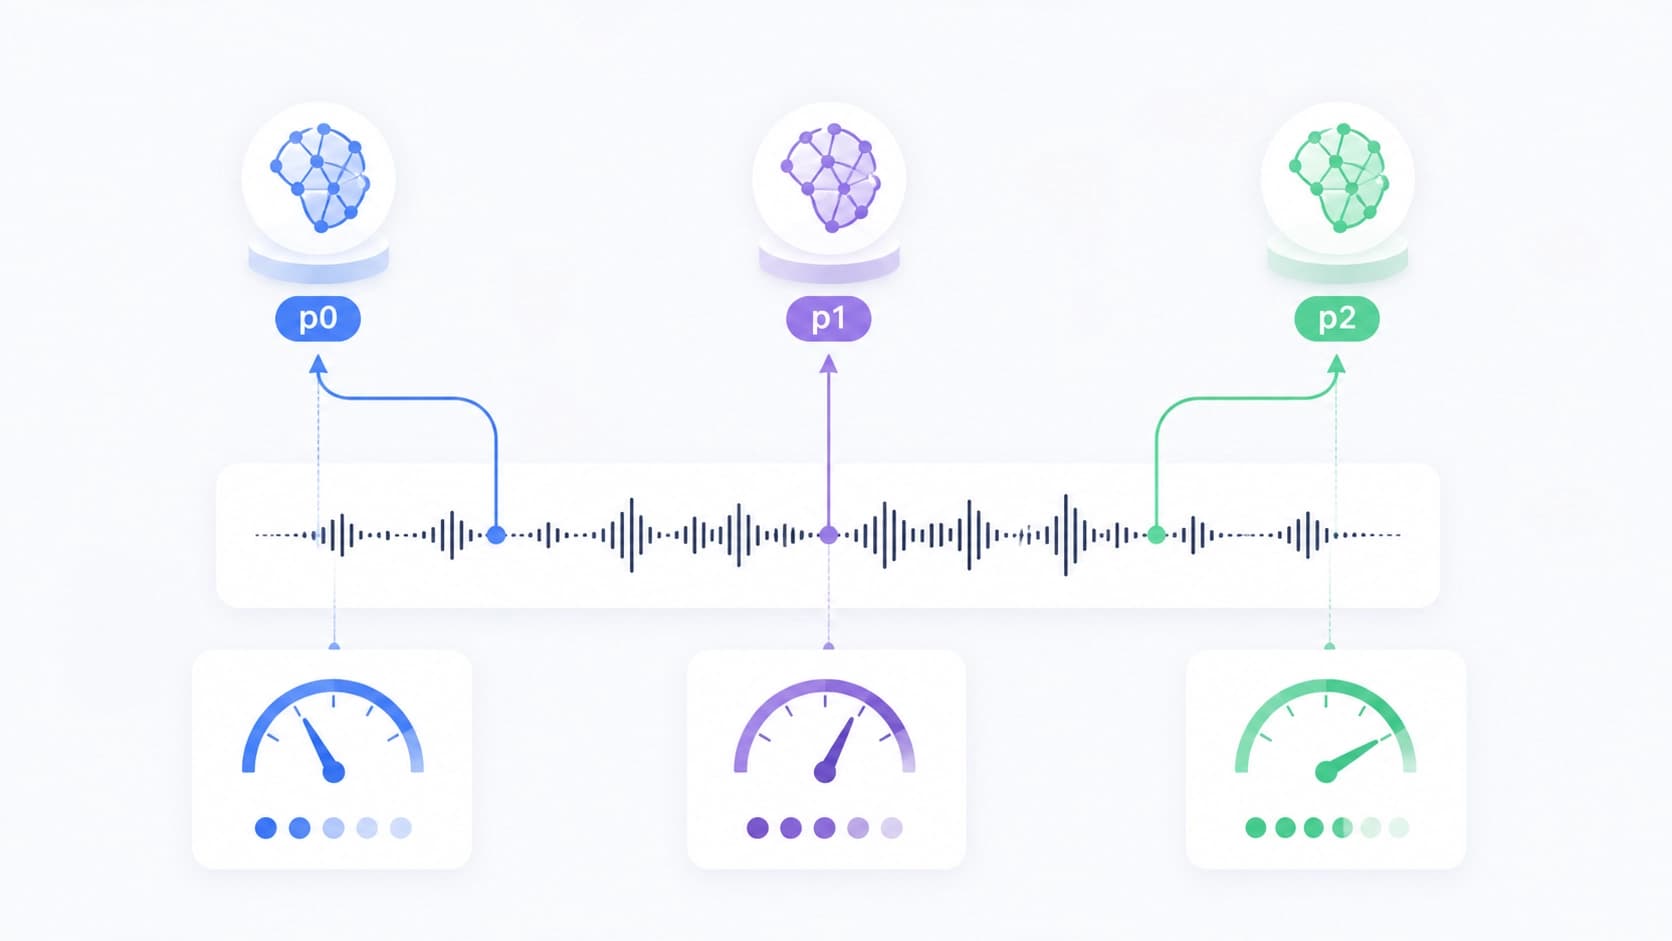
Одни и те же диалоги прогонялись через три схемы оценки — p0, p1 и p2. Смысл упражнения простой: если вердикт меняется от того, как составлена рубрика, значит судья измеряет не качество разговора, а форму инструкции. Любая метрика, которая «плывёт» между конфигурациями, для автоматизации не годится — по крайней мере без оговорок.
Что именно сравнивали
Агрегированное согласие — процент совпадений между человеком и моделью — это лишь верхний слой. Авторы копают глубже: смотрят корреляции по каждой метрике отдельно, проверяют, насколько устойчивы оценки внутри группы людей, и разбирают систематические расхождения между человеком и LLM. Такой разрез позволяет понять, какие атрибуты разговора поддаются автоматической оценке, а какие упираются в контекст и интерпретацию.
Где LLM-судья ошибается
Ключевой вывод звучит скорее как предостережение, чем как реклама метода: надёжность автоматической оценки не одинакова — она зависит от конкретной метрики и от конфигурации. Одни и те же модели-судьи дают крепкие результаты на одних шкалах и заметно проседают на других.
Recovery Turn Count
Эта метрика считает, сколько ходов понадобилось агенту, чтобы вытащить разговор из сбоя. Автоматическая оценка здесь ненадёжна: судья не всегда различает осмысленное восстановление и случайно удачную формулировку. Диалог, который человек назовёт спасённым, модель легко запишет в провал — и наоборот.
Метрики безопасности по полноте
Safety-recall — второй проблемный участок. Логика ошибки предсказуема: судья видит диалог, где агент не сказал ничего опасного, и ставит высокий балл, не задаваясь вопросом, была ли вообще возможность нарушить политику. Пропущенное нарушение — самый дорогой тип ошибки, и именно там автоматика слабее всего.
Домен меняет калибровку
Надёжность судей различается между телекомом и ритейлом. Практический вывод: пороги и рубрики нельзя механически переносить из одной отрасли в другую — то, что откалибровано на одном домене, на другом поедет.
Калибровка важнее процента совпадения
Единая цифра согласия усыпляет бдительность. Модель может совпадать с людьми в среднем по большим числам, но систематически быть мягче на пограничных случаях — и это смещение не видно за общим процентом. Поэтому корреляционный анализ калибровки и разбор расхождений по каждому классу случаев полезнее одной сводной метрики: он показывает не «насколько мы близки», а «в какую сторону и на чём мы врём».
Как встроить это в реальный пайплайн
Авторы не предлагают отказаться от автоматизации — они предлагают гибридную схему. LLM-судья берёт на себя массовую оценку, люди остаются там, где нужен контекст и высокая уверенность в вердикте. Рабочие правила выглядят так:
- прогоняйте рубрику минимум в двух-трёх конфигурациях и сравнивайте результаты, а не только финальный балл;
- считайте согласие по каждой метрике отдельно, а не одним числом на весь датасет;
- держите человека на safety-recall и на метриках восстановления после сбоя;
- проверяйте калибровку на своём домене перед тем, как ставить автоматические пороги;
- сохраняйте случаи расхождения человек/модель — это готовый материал для дообучения рубрики.
Что в сухом остатке
LLM-судья — рабочий инструмент крупномасштабной оценки голосовых агентов, но не замена оценщику. Его надёжность распределена неравномерно: часть метрик можно смело отдавать автоматике, часть требует человеческого взгляда. Полезность исследования в том, что оно даёт эмпирическую рамку для такого разделения труда — и напоминает, что вопрос «доверять ли модели оценку» некорректен, пока не уточнено, по какой именно метрике и в каком домене.