Рабочая память там, где важна не цифра, а величина
Удерживать в уме непрерывную переменную — угол поворота, скорость, положение курсора, силу нажатия — и плавно её подправлять: это, пожалуй, самый честный тест на рабочую память. Запомнить «семёрку» несложно, а вот сохранять величину без естественных границ, способную сместиться на сколь угодно малую долю, — задача совсем другого класса.
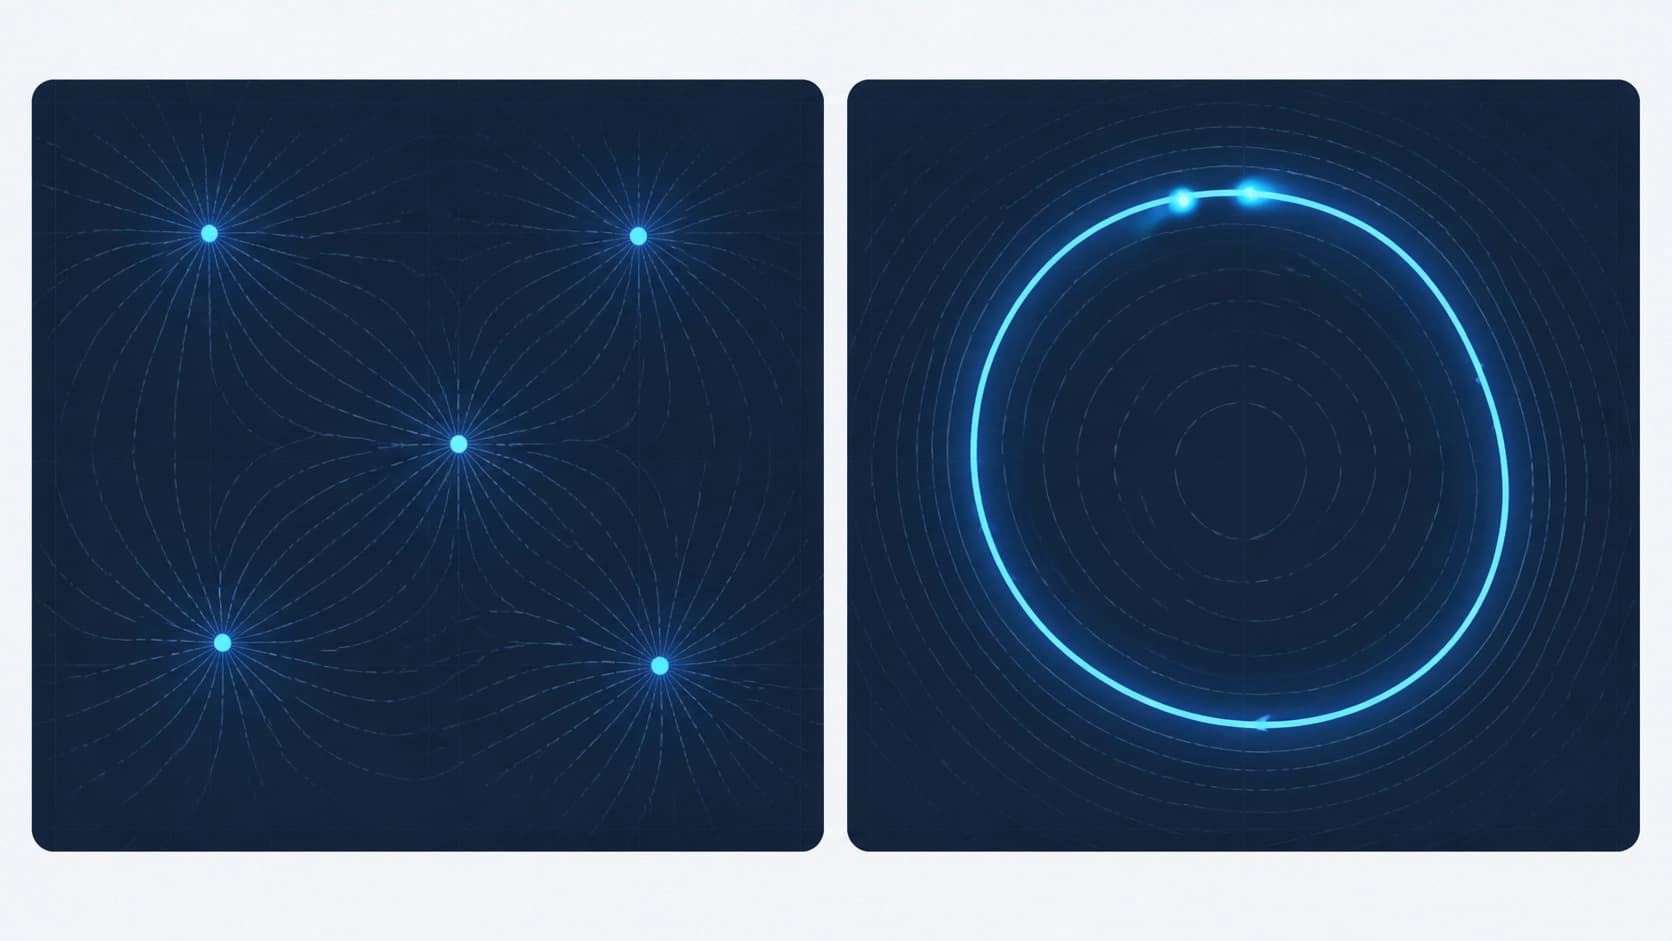
С ней у искусственных сетей отношения исторически натянутые. Модели с непрерывными аттракторами — то есть с устойчивыми состояниями, образующими не горстку изолированных точек, а гладкую поверхность — держатся на честном слове: чуть сдвинь параметры, и поведение рассыпается.
Почему привычные рекуррентные архитектуры «квантуют» состояние
Стандартные рекуррентные решения, включая GRU и LSTM, обычно так и не выучивают непрерывные многообразия. Вместо континуума они дробят пространство состояний на дискретные точечные аттракторы: сеть как бы округляет вход до ближайшей «полочки». Для классификации это удобно, для количественной оценки — приговор.
Команда исследователей (Zhaotian Gu, Jie Su, Weiwei Wang, Chang Liu, Tianyi Qian, Dahui Wang) предложила лечить это не усложнением архитектуры, а одним конкретным вычислительным приёмом. Работа опубликована в Transactions on Machine Learning Research (август 2026), препринт доступен как arXiv:2608.01947 в разделах q-bio.NC, cs.AI и cs.NE.
Деление вместо вычитания: минимальная модель
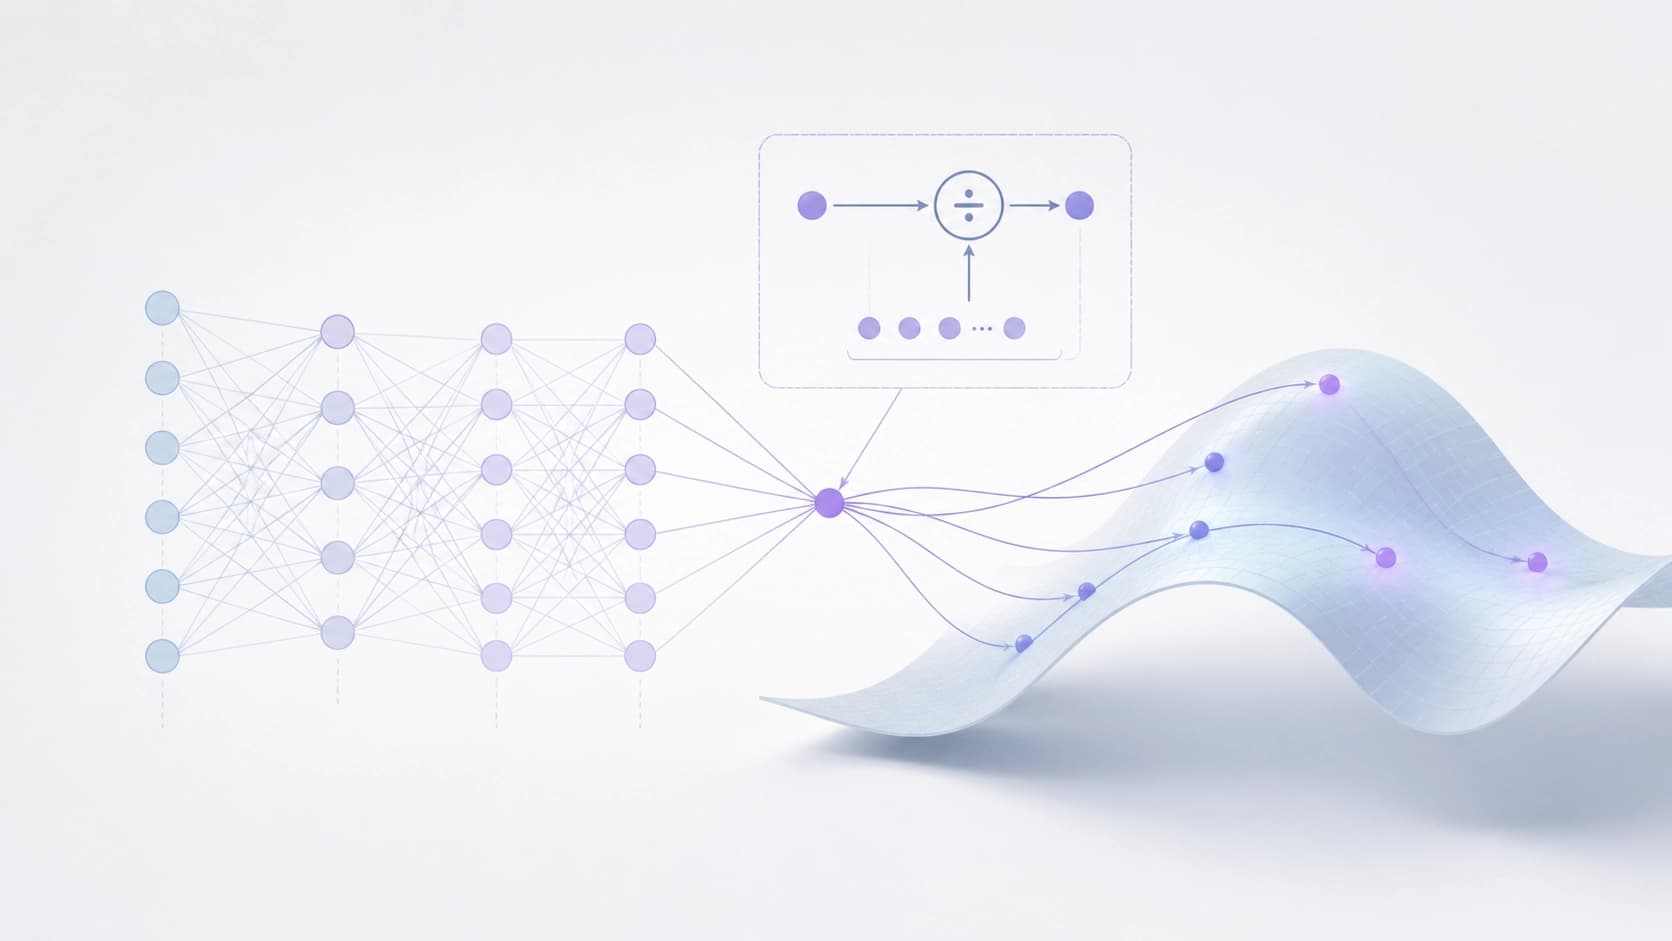
Идея пришла из нейробиологии. Деление (divisive normalization) — каноническая операция, которую наблюдают в кортикальных контурах повсеместно, и авторы построили вокруг неё минимальную, алгебраически изолированную рекуррентную сеть — Recurrent Divisive Normalization Network, сокращённо RDNN. Внутри нет ничего лишнего: только динамика деления и то, что к ней прилагается.
Дальше — стандартный для вычислительной нейробиологии ход: анализ динамических систем на классических задачах рабочей памяти. И здесь биофизическое ограничение неожиданно оборачивается преимуществом. Сеть сходится к устойчивым медленным многообразиям, причём высокой точности: траектории не разбегаются, а ложатся на узкую поверхность и спокойно по ней двигаются.
Что происходит с градиентом
Отдельный сюжет работы — разбор обучения через обратное распространение во времени (BPTT). Деление вносит локальное масштабирование градиента, зависящее от текущей активности: чем сильнее возбуждён блок, тем скромнее достаётся ему обновление параметров. Получается встроенный тормоз, который включается ровно там, где он нужен.
Эффект наблюдаемый: эффективный ранг сети заметно самосжимается, и рекуррентная динамика оказывается заперта в тесном низкоразмерном подпространстве. При этом авторы подчёркивают разницу с явной низкоранговой факторизацией — там подобное ограничение часто приводит к оптимизационным патологиям, а здесь оно возникает само, как побочный эффект активности.
Аблации: без деления многообразие рассыпается
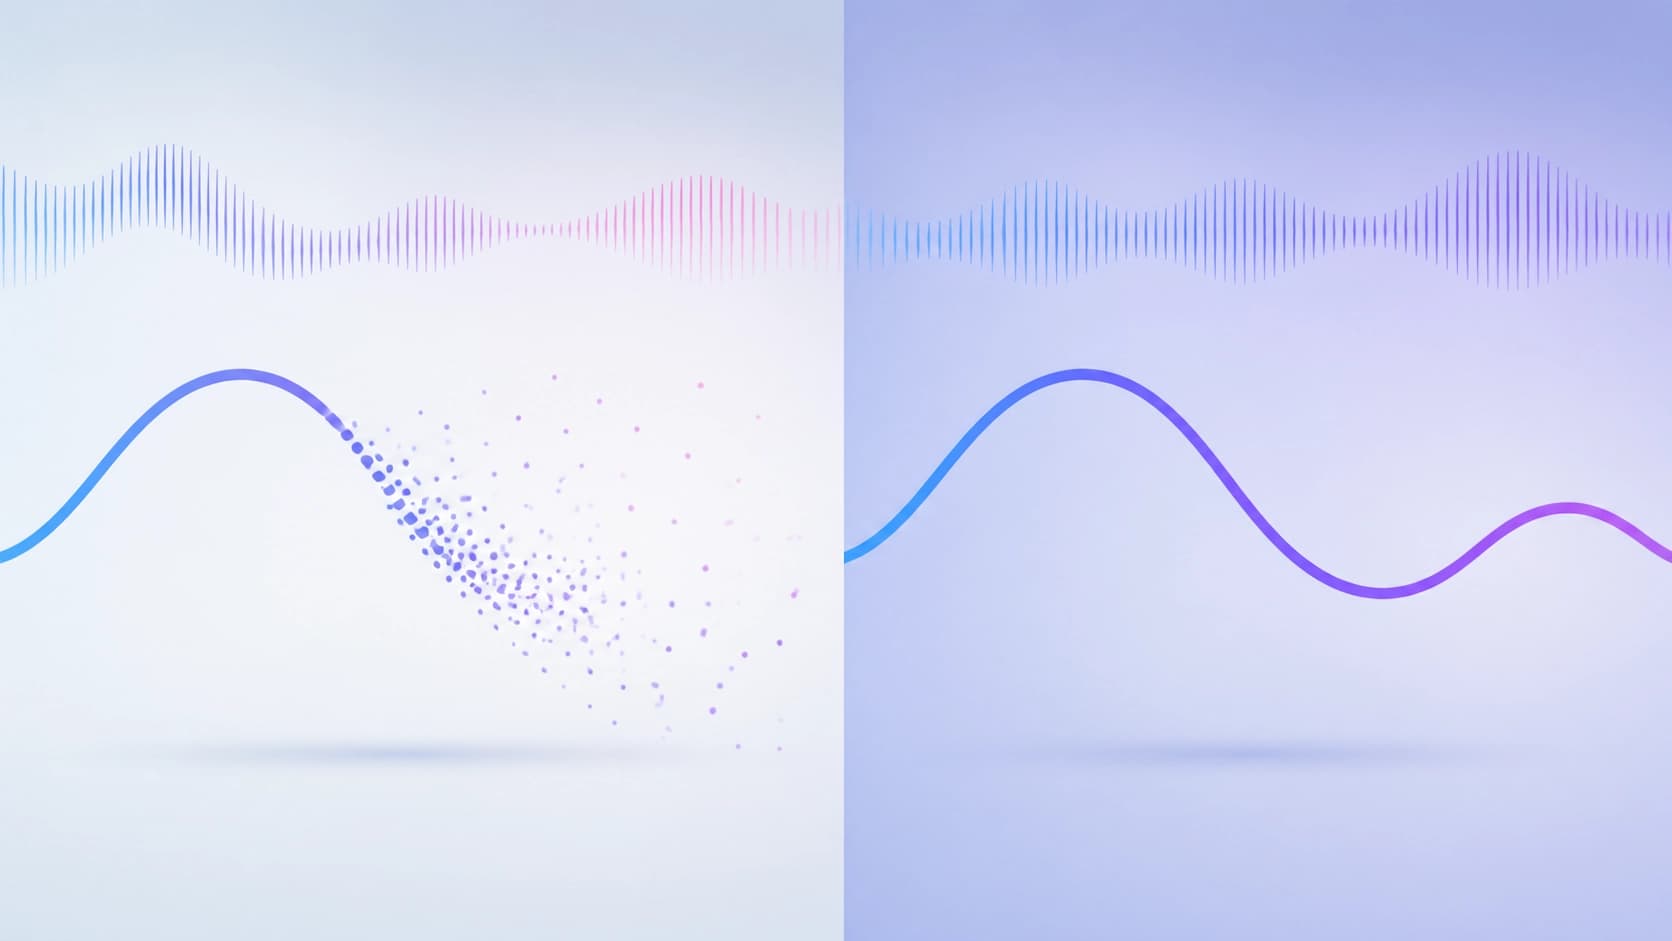
Самая говорящая часть — сравнение с вычитающим торможением. Такая замена статические воспоминания удерживать умеет: неподвижную точку сохранить не проблема. Но стоит входным сигналам начать меняться во времени, и многообразие «разбивается» (manifold shattering) — непрерывность исчезает именно там, где она нужнее всего.
Отсюда вывод, который стоит держать в голове: деление — не биологический курьёз, доставшийся в наследство от коры, а работающий вычислительный механизм. Он нужен, чтобы сеть научилась высокоточным непрерывным представлениям, а не только аккуратной дискретизации.
Что с этим делать на практике
Практический смысл не в том, чтобы срочно переписать все рекуррентные модели. Скорее это напоминание: нормализация — не только про стабильность обучения и не только про регуляризацию. Это способ задать геометрию внутреннего пространства состояний, и у деления здесь явное преимущество перед вычитанием.
Если задача требует держать непрерывную величину и плавно её обновлять — при управлении, в трекинге, в любых системах со «сколько» вместо «какое из» — имеет смысл присмотреться к схемам с мультипликативной нормализацией. Цена минимальна, а взамен сеть перестаёт округлять то, что округлять не следовало.