Спайковые нейросети обычно обсуждают в контексте энергоэффективности: вместо плотных умножений — редкие события, вместо постоянного такта — разреженная активность. Но у этого класса моделей есть второй ресурс, который почти всегда остаётся невостребованным: мембранный потенциал, непрерывно меняющийся во времени. Свежая работа предлагает смотреть на него не как на промежуточную переменную, а как на полноценное состояние убеждения — и строить на нём решения о том, что рассматривать дальше.
Проблема: облако точек сканируют одним и тем же маршрутом
Когда спайковую сеть применяют к 3D-данным, фрагменты сцены обычно перебираются в заранее заданном порядке — одинаковом для всех входов. Порядок обхода не зависит от того, что именно лежит в облаке точек. Получается странная асимметрия: самая характерная черта спайковых вычислений, временная эволюция мембранного потенциала, никак не влияет на то, какие данные сеть увидит и когда она остановится. Решение принимается «снаружи» динамики, а не внутри неё.
Active Spiking Perception: мембрана отвечает за выбор
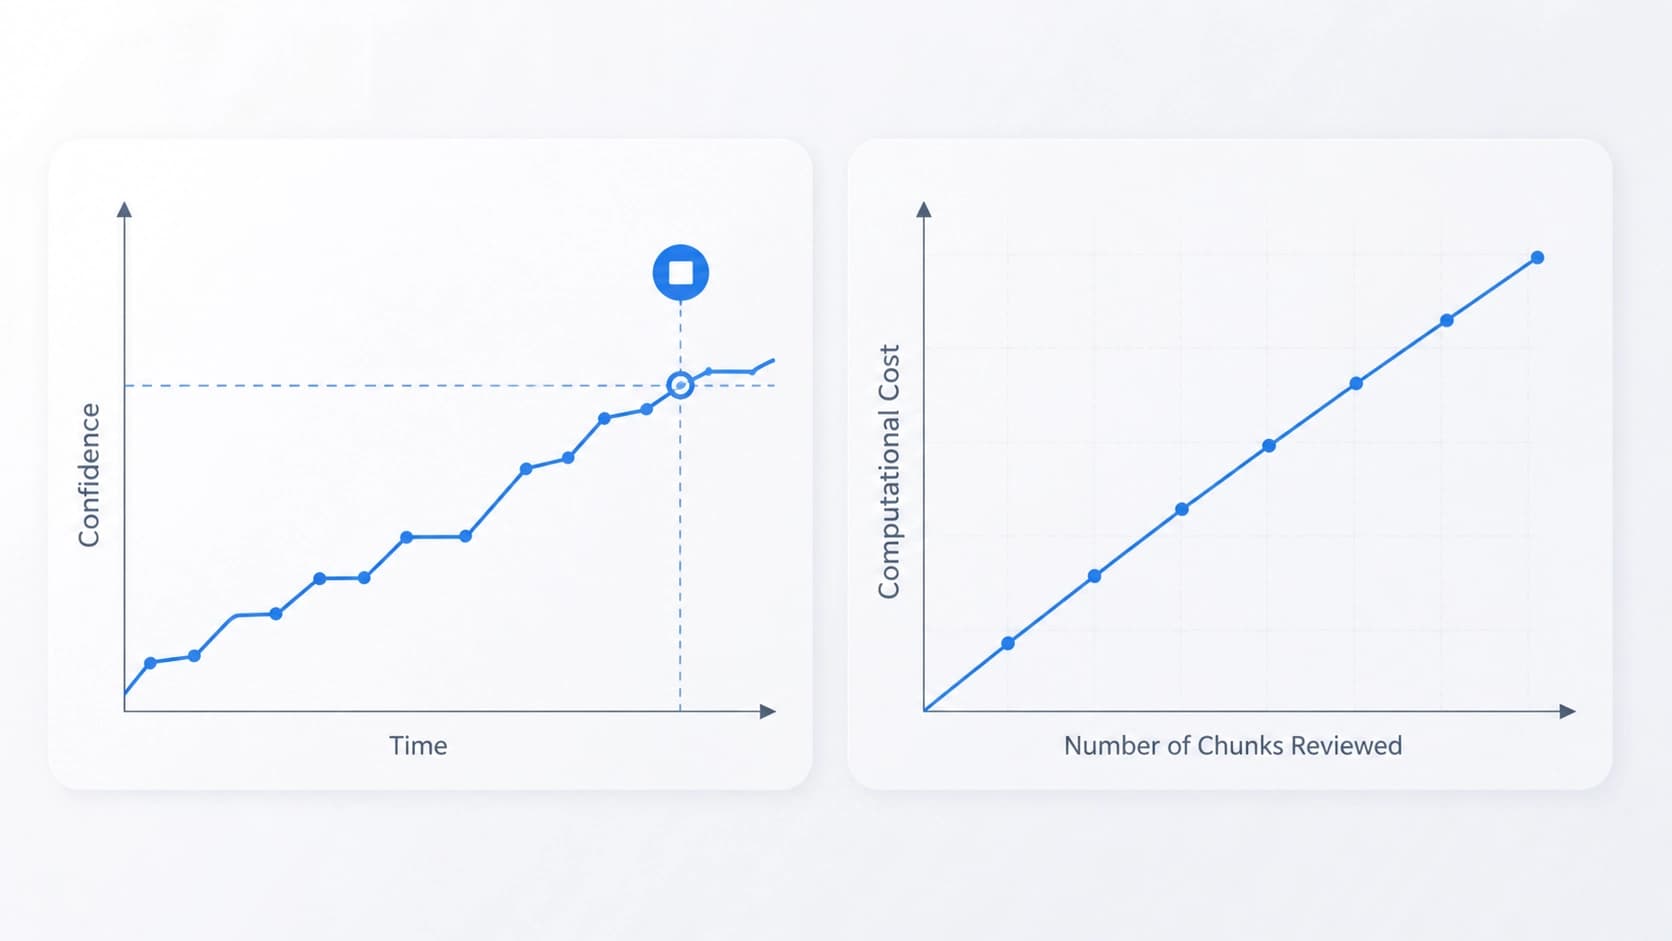
Метод Active Spiking Perception (ASP) разворачивает распознавание в итеративный цикл. Сеть наблюдает один фрагмент, обновляет состояние LIF-нейронов (leaky integrate-and-fire) и считывает свой мембранный потенциал как текущую гипотезу о классе — running belief. Именно эта гипотеза определяет, какой фрагмент попадёт в поле зрения следующим, а заметный отрыв лидера по margin служит сигналом к досрочной остановке.
Идея проста, но меняет роль потенциала: он перестаёт быть служебной величиной между слоями и становится интерфейсом, через который сеть «объясняет» сама себе, чего ей не хватает для ответа.
Как устроена политика выбора
За выбор отвечает лёгкий модуль Slice-Selection Policy. Кандидаты на следующий просмотр берутся из farthest-point sampling, а оцениваются по двум вещам: текущему состоянию мембраны и предвычисленным геометрическим дескрипторам. Обучение идёт end-to-end через straight-through Gumbel-Softmax, а на инференсе схема вырождается в обычный argmax. Накладные расходы скромные — порядка 2% от числа параметров бэкбона.
Почему это не просто эвристика
Авторы подводят под конструкцию теоретическую базу. Первое: механику leaky integration можно рассматривать как рекурсивное обновление логарифма апостериорной вероятности в байесовском фильтре — то есть накопление потенциала эквивалентно накоплению свидетельств. Второе: правило остановки обеспечивает распределённо-свободный селективный риск, причём без штрафа за множественные сравнения в момент, когда сеть решает прекратить наблюдение. Третье: перенос потокового состояния между шагами эквивалентен пересчёту с нуля по префиксу наблюдений — при условии ограниченного дрейфа конечной точности.
Что показали эксперименты
На ModelNet40 метод даёт 90.62%, на ModelNet10 — 93.28%. Это на 1.7 процентного пункта ниже сильнейшего спайкового бейзлайна, причём бейзлайн использует более крупный бэкбон. Так что пиковая точность — не главный аргумент работы. Аргумент в другом: ASP добавляет сертифицированный anytime-интерфейс, которого не предоставляет ни один из сравниваемых подходов.
Механизм масштабируется и на плотные предсказания: 83.21 instance mIoU на ShapeNetPart и 48.50 mIoU на S3DIS Area 5. Последний результат авторы называют первым спайковым на этом наборе.
Отдельный сюжет — переносимость. Если заменить обучаемый выбор фрагментов на фиксированный, та же логика продолжает работать на фовеированном не-спайковом трансформере. Значит, политика не является свойством конкретной спайковой архитектуры, а представляет собой самостоятельный приём.
Порог как ручка для вычислений
Стоимость инференса растёт строго линейно по числу наблюдений — это следствие того, что сеть обрабатывает фрагменты по одному. Порог уверенности превращается в измеримый регулятор: поднимая его, можно заставить модель смотреть дольше и точнее, опуская — получить ответ быстрее. Авторы оценивают выигрыш диапазоном от 2.8x до 1.35x меньшего энергопотребления относительно сопоставимых вариантов. Практический смысл очевиден: одно и то же решение подходит и для серверного сценария, где важна точность, и для бортового, где важнее бюджет.
Ограничения и куда двигаться дальше
Честно заявлено как минимум одно узкое место: один из классов в S3DIS не удаётся распознать при используемом размере кропа. Авторы не прячут это, а приводят предсказание, которое проблему сняло бы — по сути, подсказку для следующей итерации работы.
Итог
Главная ценность работы не в цифрах на бенчмарках, а в смене рамки. Мембранный потенциал здесь — не побочный продукт интегрирования, а состояние убеждения, из которого выводятся и выбор действия, и критерий остановки. Из этого вырастают три следствия: появляется anytime-режим с сертифицированными гарантиями, стоимость становится линейной и управляемой одним параметром, а сама политика выбора оказывается переносимой на другие архитектуры, включая не-спайковые.
Иными словами, у спайковых моделей обнаружился не только энергетический, но и «решенческий» ресурс. И пользоваться им можно, не переписывая бэкбон с нуля.
Технические детали изложены в препринте arXiv:2608.19232 (cs.NE, cs.AI, cs.LG; ACM I.2.10, I.5.1, I.2.6), версия v1 от 4 августа 2026 года, v2 — от 22 августа. Объём — 28 страниц, 9 рисунков, 17 таблиц и приложения A–J.