
Молекулярный вектор как инфраструктура
В вычислительной химии эмбеддинг молекулы давно перестал быть технической деталью. Это переиспользуемая инфраструктура: одно и то же векторное представление обслуживает и предсказание свойств соединения, и виртуальный скрининг, и поиск похожих молекул. Посчитали один раз — применяете в десятке сценариев, от ранжирования библиотек до отбора кандидатов в лабораторию.
Тупик одного представления
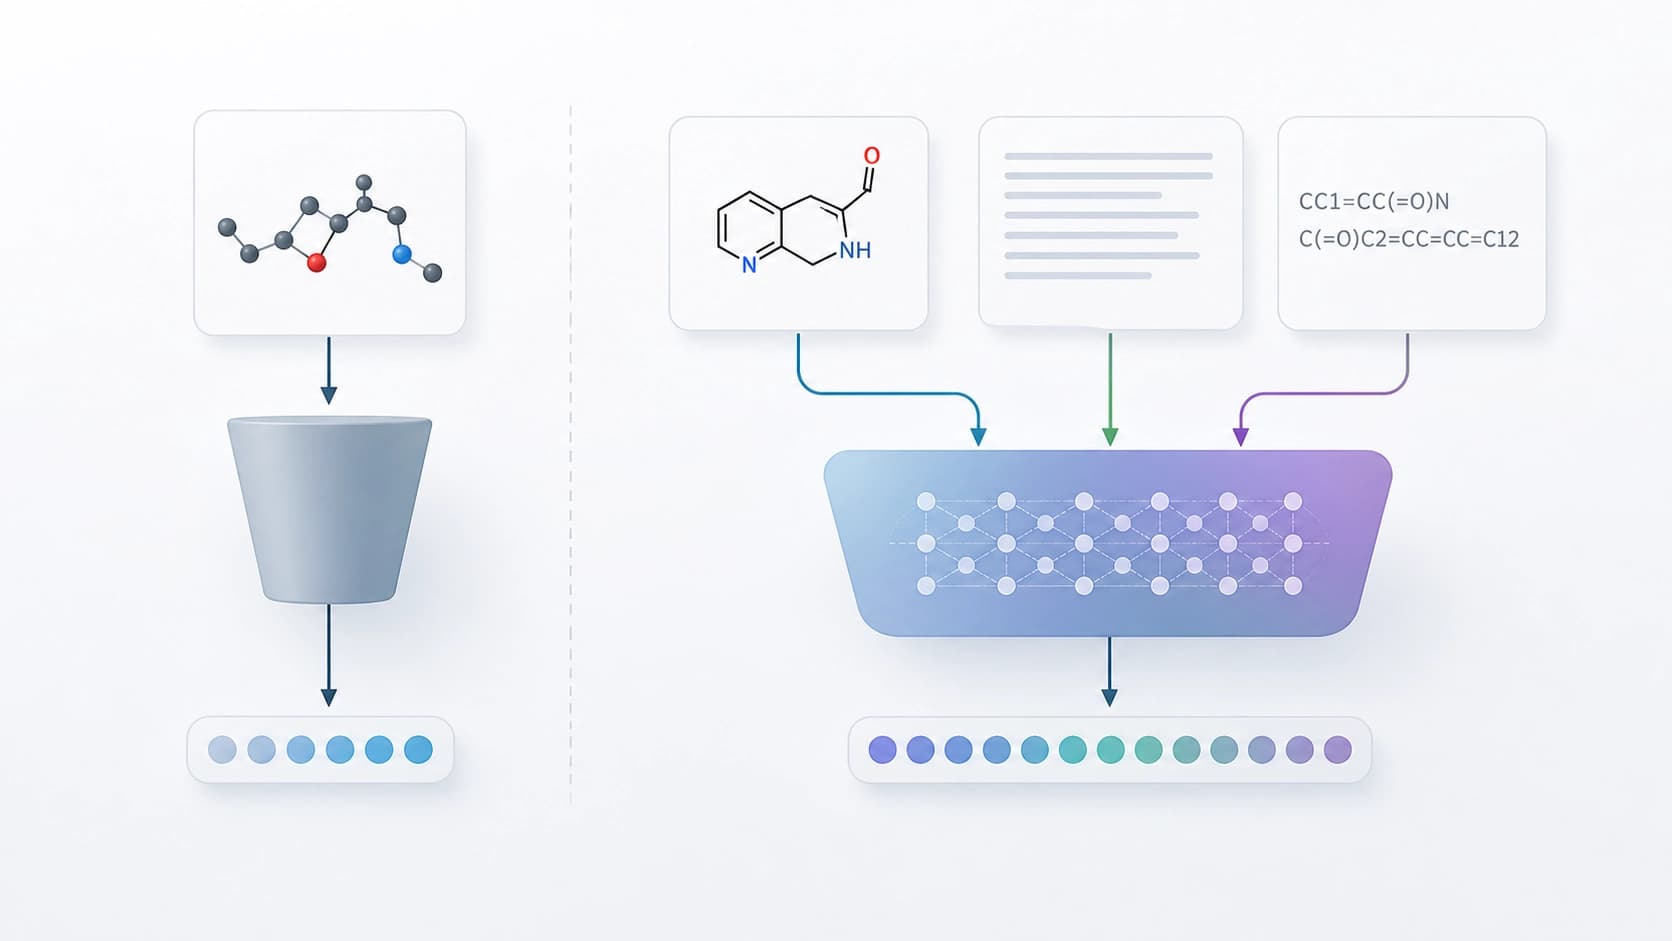
Почти все молекулярные энкодеры устроены по одной схеме: выбирается единственная модальность — граф атомов, строка SMILES, набор физико-химических дескрипторов или 3D-конформация — и модель обучается строго на ней. Вектор на выходе получается безусловным. К нему нет интерфейса, через который можно было бы уточнить запрос: «нужен аналог по механизму действия, а не по углеродному скелету» или «похожее соединение, но с прицелом на растворимость».
Отсюда следует неприятный эффект. Одну и ту же молекулу разные модели видят по-разному, а сравнивать их представления напрямую нельзя — пространства не согласованы. Химик при этом вынужден держать в голове, какой энкодер под какую задачу подходит, вместо того чтобы просто формулировать задачу словами.
Вопрос, который поставили авторы
Работа Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai и Tianshu Yu (arXiv:2608.23646, 24 августа 2026; представлена на воркшопе FM4LS в рамках ICML 2026, non-archival) начинается именно с этой неудовлетворённости. Исследователи задаются вопросом: а зачем вообще строить отдельный энкодер под каждое представление молекулы, если мультимодальные LLM уже умеют нативно работать с изображениями, текстом и символьными записями?
Логика простая. Если модель и так «видит» картинку структурной формулы, читает описание и разбирает SMILES, её можно превратить не в помощника-консультанта, а в генератор векторов. Причём векторов обусловленных — зависящих не только от самой молекулы, но и от того, что о ней спрашивают на естественном языке.
Как устроен фреймворк
MolEmb — это лёгкая надстройка, а не новая большая модель. Она адаптирует уже существующую MLLM так, чтобы молекулярные профили и их текстовые описания оказывались в одном общем пространстве эмбеддингов. Ключевой элемент — двунаправленная контрастивная цель: она подтягивает друг к другу пары «молекула — текст» и одновременно расталкивает несовпадающие пары.
Почему это важнее, чем кажется
Контрастивное обучение здесь решает сразу две задачи. Во-первых, оно задаёт общую систему координат: вектор молекулы и вектор её описания становятся сопоставимыми. Во-вторых, оно даёт кросс-модальный поиск в обе стороны — по молекуле найти текст, по тексту найти молекулу, причём внутри одного и того же пространства, без промежуточных переводчиков между модальностями.
Заявленный результат скромнее, чем «побили все бенчмарки», и от этого правдоподобнее: полученные представления конкурентоспособны в предсказании молекулярных свойств и при этом поддерживают поиск между модальностями. То есть языковой интерфейс не куплен ценой деградации классических задач.
Язык как рычаг управления
Главное отличие от традиционных энкодеров — в обусловленности. Специализированная модель выдаёт по молекуле один фиксированный вектор. Фреймворк же позволяет формулировать условие словами и получать представление, сдвинутое в сторону этого условия. Одна и та же молекула может быть представлена по-разному в зависимости от того, интересует вас токсичность, растворимость или близость к конкретному классу соединений.
Молекулярный поиск, который зависит от контекста
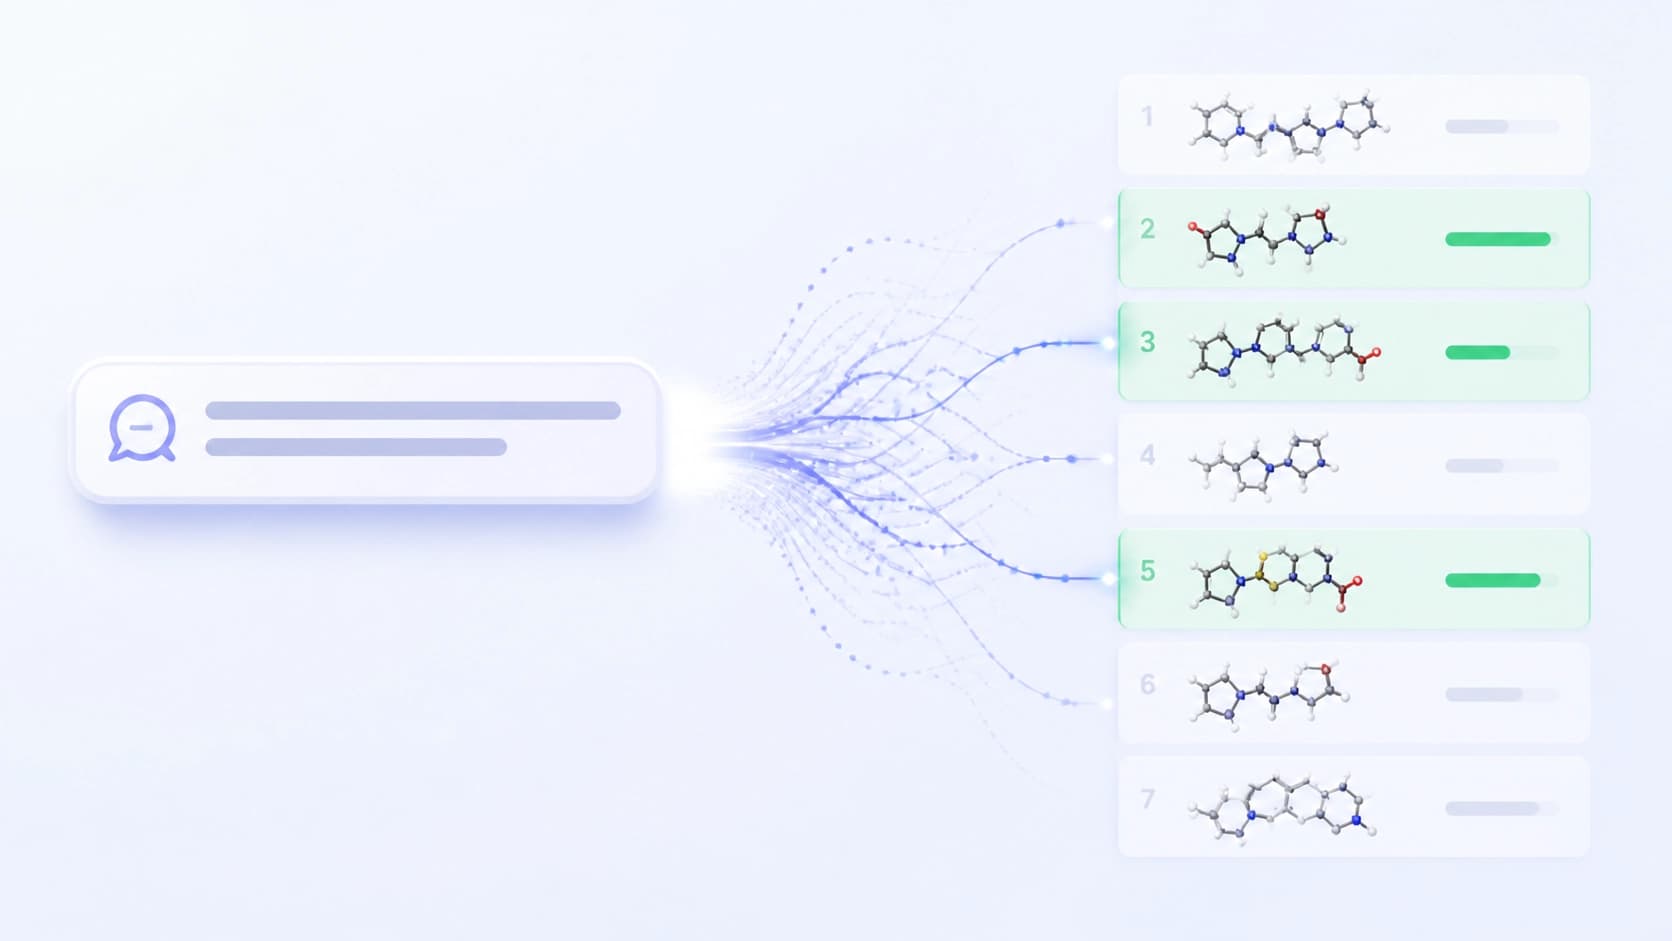
Отдельная часть работы — диагностический бенчмарк MolCAR. Он создан, чтобы проверять контекстно-зависимый поиск, то есть ситуации, когда правильный ответ меняется в зависимости от формулировки запроса. Это принципиально сложнее классического поиска похожих структур: там эталон один, здесь он зависит от постановки задачи.
Самый интересный вывод
Пожалуй, самое ценное наблюдение авторов звучит почти буднично: контекстно-зависимый молекулярный эмбеддинг — это прежде всего свойство данных супервизии, а не архитектурный трюк. Иными словами, модель начинает различать контексты не потому, что в неё встроили хитрый модуль, а потому что её научили на парах, где контекст действительно различается.
Вывод отрезвляющий и полезный одновременно. Он смещает фокус с гонки архитектур на качество и структуру обучающих данных: если описания молекул в датасете однотипны, никакая мультимодальность не подарит модели чувствительность к нюансам запроса.
Что это меняет на практике
Если такой подход масштабируется, выигрыш выглядит так:
- Единая инфраструктура вместо зоопарка энкодеров. Одна модель закрывает и свойства, и поиск, и кросс-модальные запросы.
- Запрос словами вместо выбора модели. Пользователю не нужно знать, какой энкодер лучше под его случай.
- Совместимые пространства. Векторы молекул и текстов живут вместе, а значит, их можно сравнивать и комбинировать.
- Переиспользование готовых MLLM. Фреймворк адаптирует существующую модель, а не обучает с нуля.
Границы и открытые вопросы
Работа помечена как non-archival, а значит, перед нами скорее направление, чем готовый продукт. Остаётся немало вопросов: насколько подход устойчив за пределами проверенных наборов данных, как он ведёт себя на редких классах соединений, не начинает ли языковая часть доминировать над химической и не превращает ли это вектор в пересказ текста, а не в физически осмысленное представление.
Тем не менее главная мысль формулируется чётко. Мультимодальные LLM — не только химические ассистенты и не только генераторы ответов. Они претендуют на роль общего механизма молекулярных эмбеддингов: расширяемого, управляемого словами и открытого к дообучению под новые задачи.


