
Протокол, который никто не выполняет дословно
Лабораторный протокол редко выполняют буквально. Между публикацией и реальным экспериментом почти всегда стоит адаптация: другая клеточная линия, заменённый реагент, меньше образцов, чужой прибор, урезанный бюджет. Для человека с мокрым столом это рутина, но рутина коварная — любая правка тянет за собой цепочку последствий. Меняешь объём реагента на раннем шаге, и надо вспомнить, чем это обернётся на этапе промывки и как согласуется с тем, что уже было сделано раньше. Именно эту способность — держать в голове весь протокол целиком и менять его осмысленно — и проверяет новый набор задач.
Исследование вышло под названием BenchBench-Protocol в препринте arXiv:2608.23898v1 (cs.AI), поданном 24 августа 2026 года. Авторы — Aditya Sivakumar, Ashu Singhal, Nicholas Larus-Stone и Nithin Parsan. Это 21 страница и 15 рисунков, то есть материал скорее методический, чем рекламный.
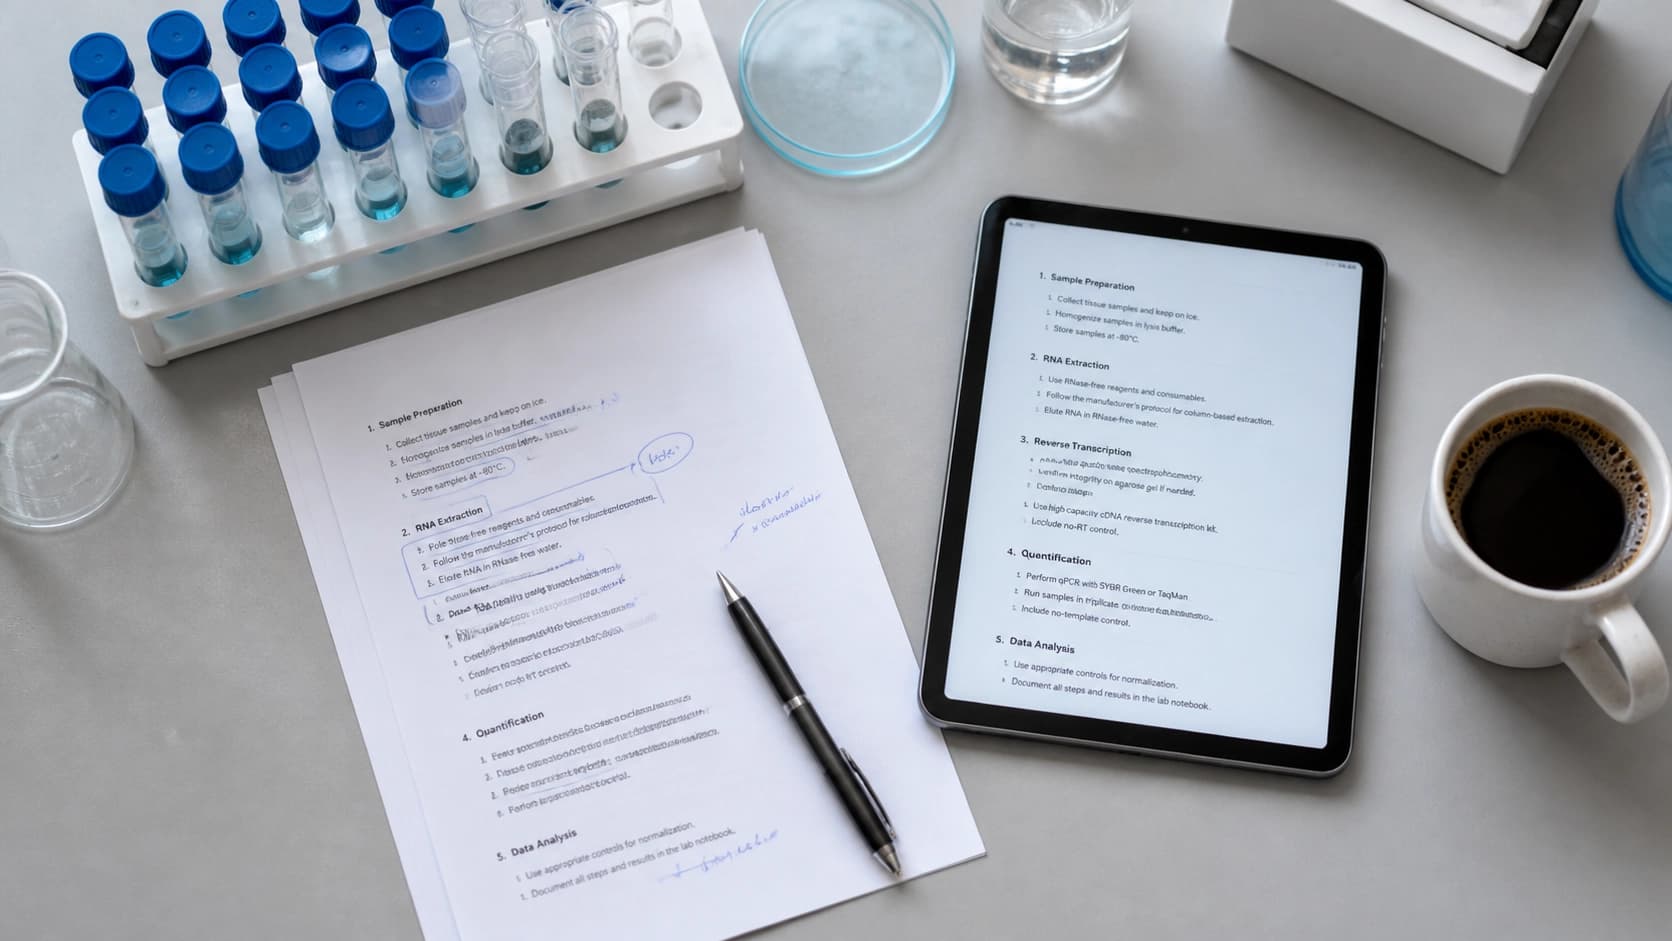
Как из черновых правок собрали 149 задач
Механика BenchBench-Protocol устроена необычно. Авторы не садились писать вопросы — они взяли уже существующий след работы. У каждого опубликованного протокола нашлась версия, которую учёный правил под свой конкретный эксперимент. Разница между этими двумя документами и стала задачей: модели показывают исходный протокол и условия нового эксперимента, а она должна предложить корректную модификацию.
Из такого подхода сразу вытекает важная деталь: у задачи есть не абстрактный «правильный ответ», а взвешенная рубрика. Потому что правка, которую внёс живой исследователь, известна — её можно разложить на элементы и оценивать, насколько предложение модели совпадает с реальным решением по смыслу, а не по формулировке. Это снимает вечную проблему биомедицинских тестов, где модель может дать разумный, но не совпадающий с эталоном ответ и получить ноль.
Основа получилась солидная: 96 исходных протоколов из девяти областей биологии мокрого лабораторного эксперимента. В финальный набор попали только те задачи, которые прошли экспертную проверку с высокими оценками, — остальное отсеяли. Итог и есть те самые 149 заданий.
Почему это не очередной набор вопросов от экспертов
Авторы отдельно проговаривают контекст. В последние годы биомедицинские бенчмарки действительно сместились в сторону открытых задач с оценкой по рубрикам — это прогресс. Но сами задания по-прежнему чаще всего придумывают эксперты: садятся и пишут вопросы на основе своего опыта. Такой подход ограничен тем, что эксперт отвечает на вопрос, который сам же и сформулировал, то есть неявно подстраивается под собственное представление о трудности.
Здесь логика обратная. Задача возникает там, где реальный человек уже уперся в реальную проблему и потратил время на её решение. Это не гарантирует идеальной чистоты данных, но гарантирует, что задачка не выдумана ради красивой формулировки.
Кто справился, а кто нет
В тестировании участвовали девять моделей — и закрытых, и открытых. Разброс оказался заметным, хотя и не драматичным.
Лучший результат показал Claude Opus 5 — 59,2% нормализованного балла по рубрике. Остальные модели уложились в диапазон от 34,1% до 47,1%. Проще говоря, до лидера никто не дотянулся, но и провала в полтора раза нет: все модели что-то да умеют, просто делают это по-разному и не всегда до конца.
Отдельная строка отчёта — проверка на насыщение. Авторы дали моделям по десять попыток и выбирали лучшую из них (best-of-10). Даже при такой щедрой схеме бенчмарк не «схлопнулся»: потолок не достигнут. Для оценки это хорошая новость — значит, набор задач не устареет после выхода следующего поколения моделей.
Что из этого следует на практике
Первый вывод — прикладной и слегка отрезвляющий. Полностью доверять языковой модели адаптацию протокола пока нельзя. Даже лучший результат в 59,2% означает, что примерно в четырёх случаях из десяти предложение требует вмешательства человека. Модель годится как черновик, как генератор вариантов, как способ быстро свериться с тем, что ты, возможно, упустил. Но финальную ответственность за пробирку она не несёт.
Второй вывод — методологический, и он интереснее первого. Авторы рассматривают свою работу не только как оценку рассуждений в мокрой лаборатории, но и как доказательство более общей идеи: реальные эксперименты — недооценённый источник задач для бенчмарков. Если в лаборатории уже есть история правок, значит, есть и материал для проверки моделей — причём материал, который невозможно придумать за письменным столом.
Третий вывод касается того, куда двигаться дальше. Разница между 59,2% и 47,1% не выглядит как пропасть на фоне сложности самой задачи. Это скорее намёк, что узкое место — не в объёме знаний модели о биологии, а в умении выстраивать цепочку: учитывать предыдущие решения и предсказывать, к чему они приведут на следующих шагах. Именно этому качеству, а не запоминанию фактов, и посвящён набор из 149 правок.


