
Коротко: где именно болит
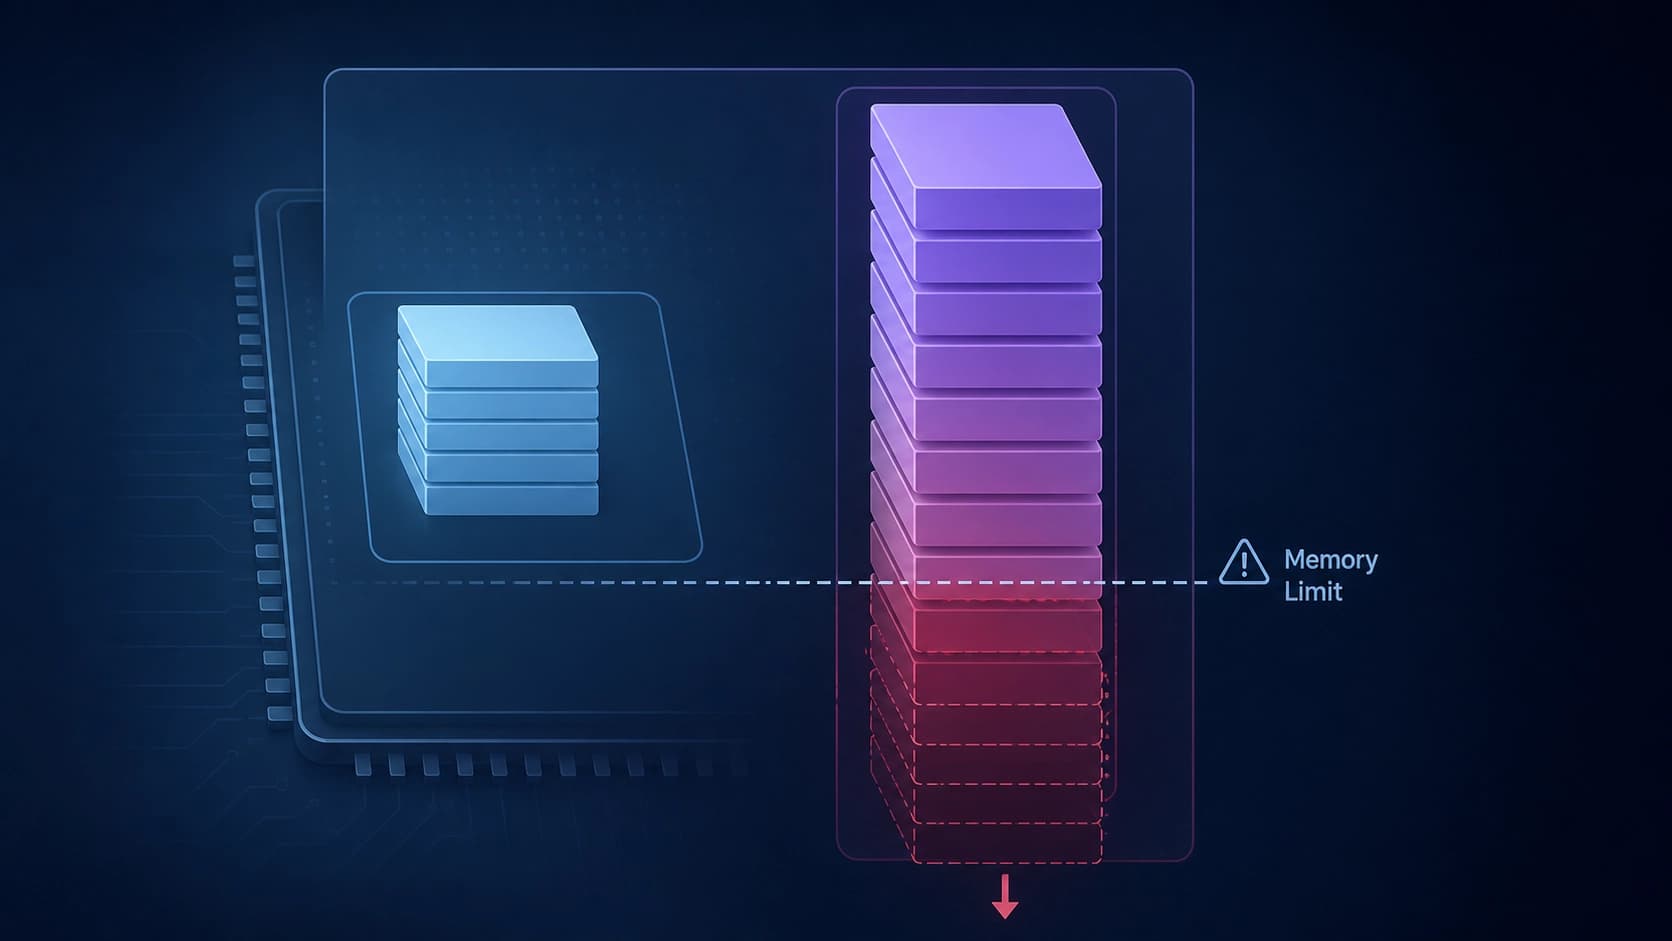
Когда модель с длинным контекстом обслуживает запрос, основные расходы уходят не на веса, а на KV-кэш — сохранённые ключи и значения для всех уже прочитанных токенов. Чем длиннее документ или диалог, тем больше тензоров приходится держать в памяти и тем больше данных перечитывать на каждом шаге генерации. Отсюда и типичная дилемма: либо обрезать контекст, либо платить за него памятью и скоростью вывода.
Существующие решения обычно выбирают одну из двух крайностей. Либо сжимают всё состояние целиком, рискуя потерять свежую информацию, которая как раз нужна для следующего ответа, либо оставляют всё в исходной точности и упираются в ёмкость ускорителя.
Именно в эту развилку и пытается вмешаться работа, о которой речь ниже.
Что предлагают авторы
Статья «Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» подана на arXiv 24 августа 2026 года под номером 2608.23834, рубрика cs.AI, 13 страниц и 3 рисунка, DOI 10.48550/arXiv.2608.23834. Авторы — Sergii Kozyrev и Davyd Maiboroda из Minima AI, Inc. Любопытная деталь: в блоке ссылки на PDF на странице препринта подпись указывает на первого автора «и ещё двух», хотя в библиографическом описании перечислены только двое. Мелочь, но она напоминает, что метаданные препринтов стоит сверять.
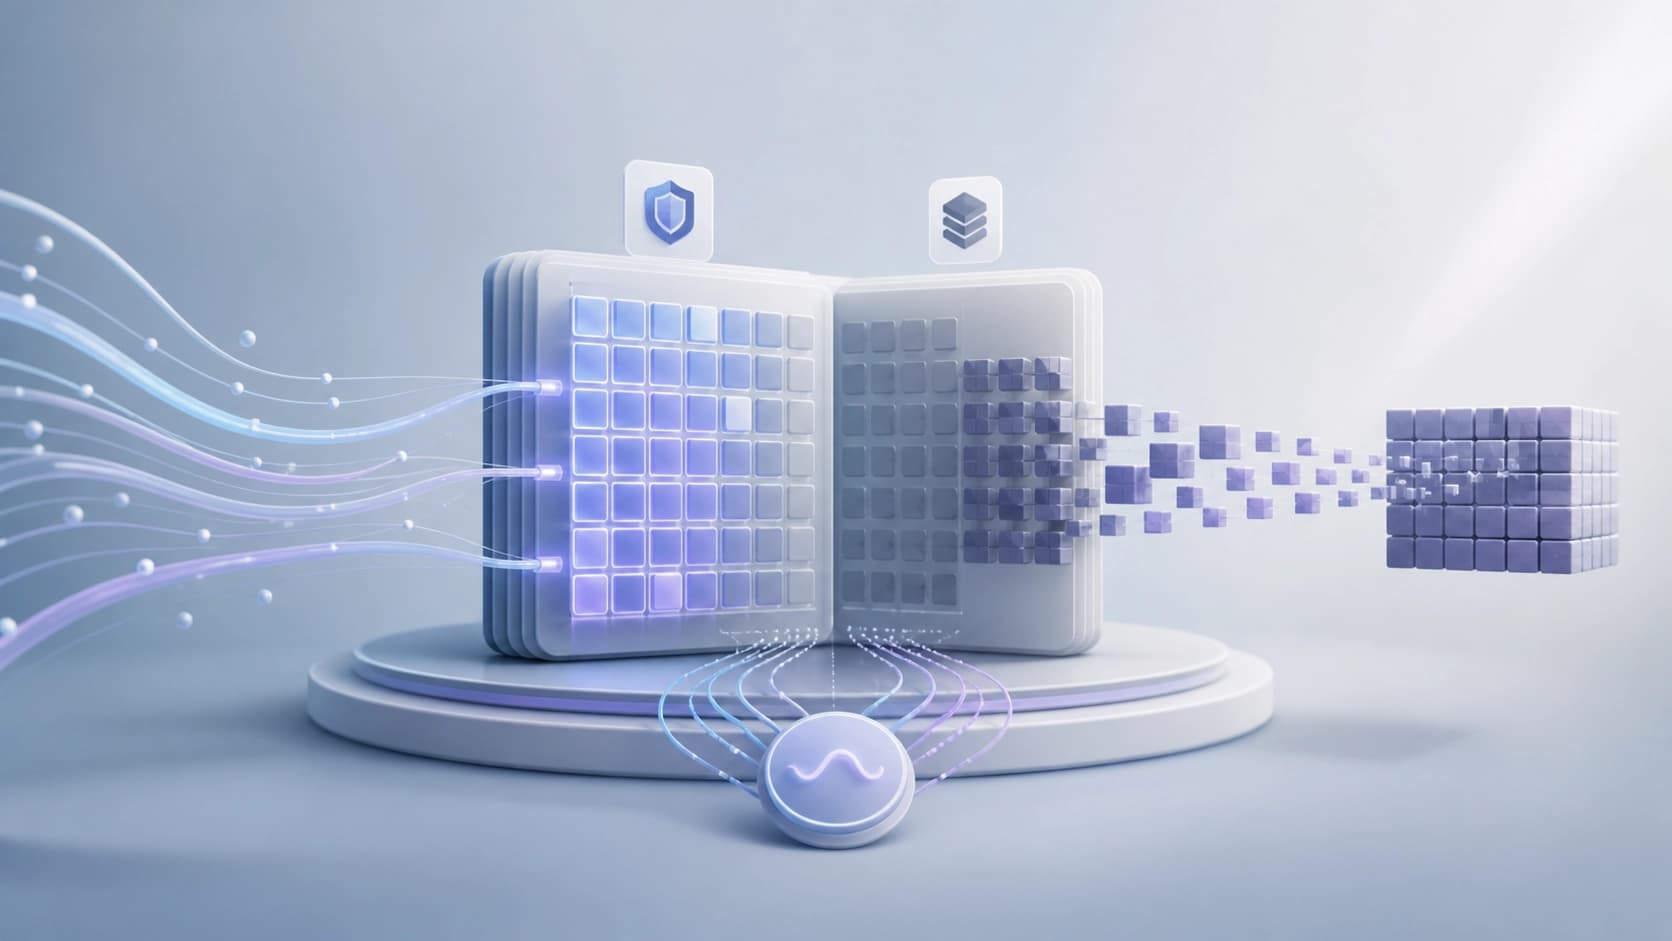
Суть предложения Minima-KV — иерархия страниц KV-кэша, где разные страницы хранятся в разных числовых форматах. Ключевое слово в названии — retention-preserving, то есть «сохраняющий удержание»: состояние свежих запросов никуда не вытесняется.
Якоря в FP8, архив в TQ3
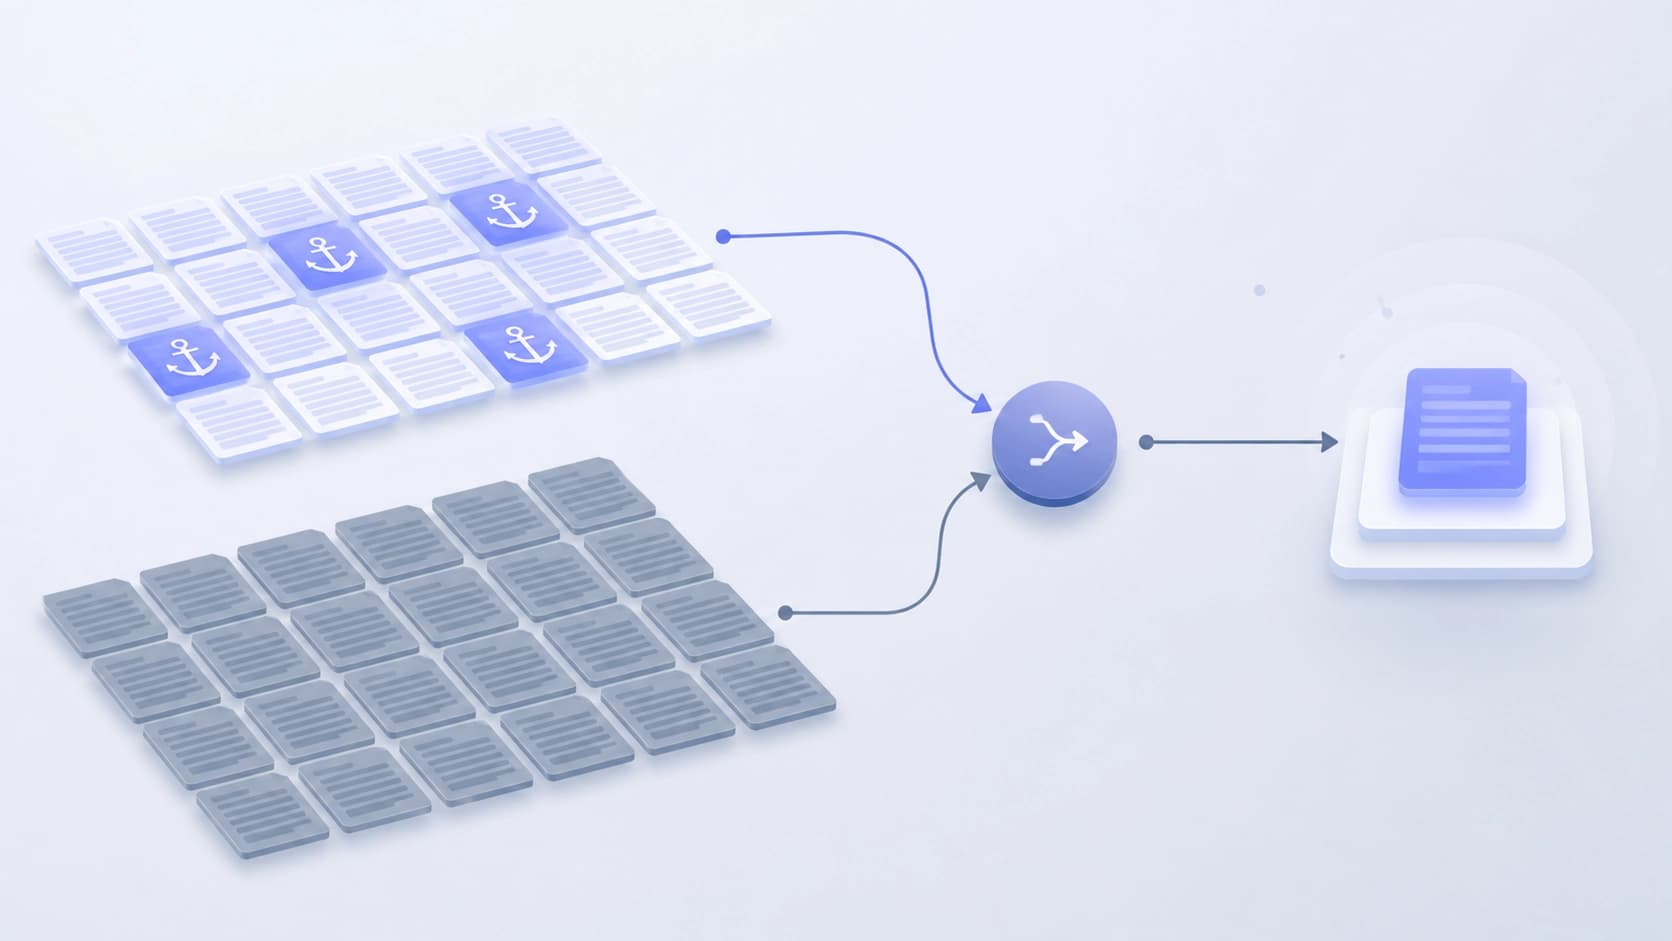
Логика разделения простая. Страницы, которые недавно использовались и помечены как защищённые (anchor), остаются в FP8. Более старые страницы, не попавшие в якорные, переводятся в packed TQ3 — более плотный упакованный формат. При этом каждую страницу живого запроса по-прежнему можно адресовать напрямую: ничего не выбрасывается из адресного пространства и не подменяется приблизительной копией.
Как склеиваются частичные результаты
Самое интересное — арифметика. Отдельные ядра под каждый формат считают свои частичные состояния внимания, а затем объединяются через глобально нормализованный online-softmax merge. Простыми словами: вместо того чтобы приводить все страницы к одному типу перед вычислением, система считает вклад каждой группы в своём формате и корректно складывает нормированные результаты.
Благодаря этому декодирование идёт напрямую по неоднородному кэшу, без так называемой плотной тени — полной копии кэша в едином формате, которая свела бы на нет всю экономию памяти.
Что показывают измерения
Память и сжатие
Замеры проводились на профилях, привязанных к конкретной конфигурации модели Qwen3.6-27B на одном ускорителе NVIDIA RTX PRO 6000 Blackwell с 96 ГБ памяти. Получилось 18,3 КиБ внимательного KV на один живой токен. Это 3,50x сжатия относительно BF16 и 1,75x относительно FP8.
Вторая цифра важнее, чем кажется на первый взгляд. Сравнение с FP8 показывает, что выигрыш достигается не только за счёт перехода от половинной точности к более экономным форматам, а именно за счёт гибридной схемы хранения.
Качество на длинном контексте
Материализующий профиль — тот, где гибридные страницы действительно разворачиваются в тензоры, — совпал со своим плотным контролем на задачах RULER needle-in-a-haystack при 16K. То есть на поиске иголки в стоге сена разницы не обнаружено.
Дальше начинаются компромиссы. На наборе LongBench v2 из 503 вопросов дельты оказались отрицательными: -0,80 процентного пункта при 16K, -0,60 при 32K и -0,40 при 64K. Обратите внимание на форму кривой — потери не растут линейно с длиной контекста, а слегка колеблются. Авторы не приводят объяснения, но сам факт стоит держать в голове при интерпретации: разброс в доли процента легко спутать с шумом измерения.
Канареечная проверка
Отдельный тест — single-pair canary, где сравнивались два прямых декодирования с запросами по 59 008 токенов каждый. Результаты: активный KV сжался в 3,625 раза, пропускная способность составила 0,9821x относительно контроля, все 16 слоёв полного внимания маршрутизировались без fallback на плотный режим, и ни одна плотная тень не сохранялась.
Пропускная способность чуть ниже единицы — это, по сути, честный обмен: около двух процентов скорости за кратное сокращение занимаемой памяти.
Выводы и оговорки
Заявленный вывод авторов осторожен: результаты показывают практический путь к сжатию длинноконтекстного состояния в смешанных форматах без вытеснения страниц живых запросов. Это ровно то, чего не хватало предыдущим подходам — компрессии, которая не жертвует свежими данными ради старых.
Что стоит учитывать при чтении:
- Тестовые профили привязаны к конфигурации. Речь о конкретной модели и конкретном ускорителе; переносимость цифр на другие архитектуры не показана.
- Канареечная проверка узкая. Одна пара запросов, один сценарий прямого декодирования — это иллюстрация работоспособности, а не статистика по нагрузке.
- Просадка на LongBench v2 ненулевая. Доли процентного пункта — немного, но в задачах, где важна каждая единица точности, это уже повод для собственного замера.
- Нет данных о задержке в продакшн-условиях. Черезput в канареечном тесте, по описанию, весь идёт через 16 слоёв без reserve-пути — интересно, как поведёт себя маршрутизация при худшем раскладе, когда якорных страниц становится больше обычного.
Практическая ценность работы не в рекордных числах сжатия, а в другом: она показывает, что гетерогенный кэш можно обслуживать напрямую, не собирая его полную копию под каждый шаг. Если этот подход переносится на другие модели, у длинноконтекстных сценариев появляется ещё один рычаг в дополнение к аппаратному масштабированию.


