
Проблема: трасса агента — это лог, а не модель поведения
Многошаговый LLM-агент оставляет после себя длинный след: вызовы инструментов, промежуточные рассуждения, исправления, повторные попытки. Читать это глазами почти бессмысленно — сотни строк текста, где полезный сигнал размазан по всему объёму. Для разработчика, который выкатывает агента в прод, такой лог превращается в чёрный ящик: непонятно ни где именно прогон пошёл не туда, ни какие состояния вообще типичны для системы.
Именно об этом работа arXiv:2608.23670 (cs.AI) «Automata from Agent Traces: Failure and Next-Step Prediction» — её авторы Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono и Adriano Koshiyama предлагают смотреть на трассы не как на текст, а как на данные о переходах между состояниями. Логика простая: если поведение агента повторяется от запуска к запуску, значит за внешним хаосом стоит структура, и её можно восстановить.
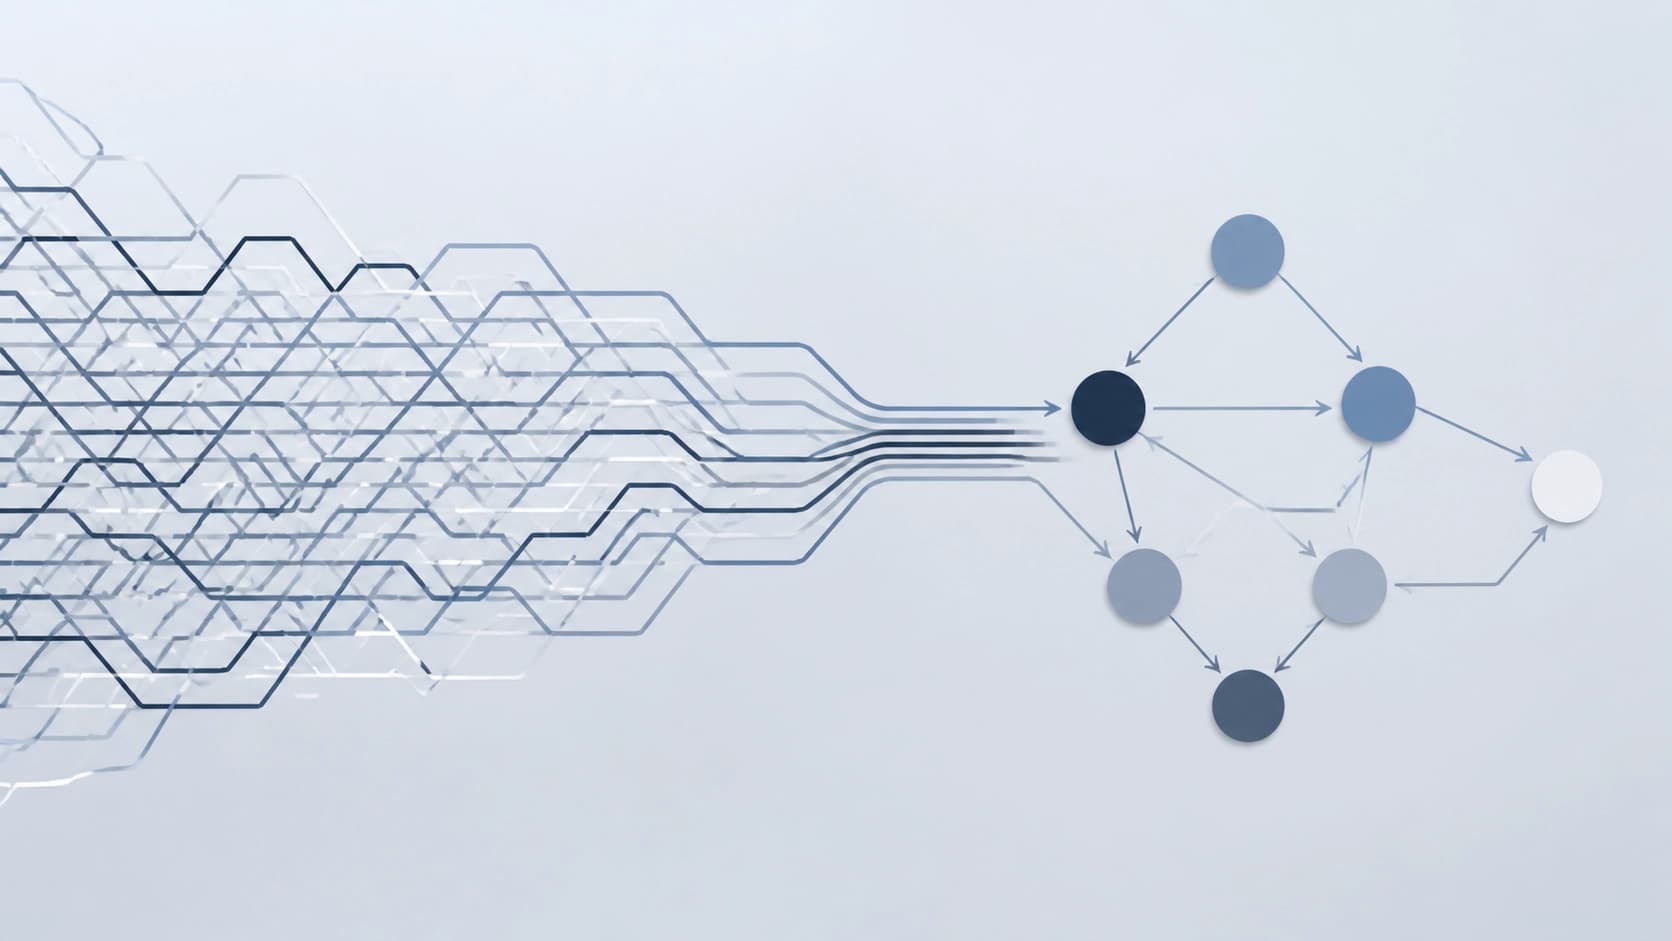
Отдельно стоит отметить, чего не хватало прежним подходам. Анализ обычно вели по одной трассе за раз либо опирались только на успешные прогоны. В обоих случаях теряется общая картина — та топология, которая связывает между собой предсказание следующего действия и предсказание провала. А ведь именно она нужна и для аудита безопасности, и для мониторинга в реальном времени.
Один автомат на весь корпус
Идея метода: взять весь набор трасс и свернуть его в единственную компактную конечную машину состояний (FSM). Не дерево решений на каждый запуск, не эмбеддинги где-то в векторном пространстве, а обычный граф с состояниями и переходами — тот самый структурный субстрат, который делает поведение агента если не предсказуемым, то хотя бы описываемым.
Результаты на двенадцати публичных датасетах выглядят обнадёживающе:
- автоматы получаются маленькими — от 7 до 43 состояний, то есть их реально нарисовать и обсудить на созвоне;
- на отложенных данных они воспроизводят трассы с fitness не ниже 0.997 — почти идеальное соответствие;
- топология, построенная на разных сплитах одного датасета, оказывается практически одинаковой;
- сама сборка занимает миллисекунды, а не часы обучения.
Последний пункт важнее, чем кажется. Метод, который строится мгновенно, можно пересобирать после каждой правки промпта или конфигурации — и сразу видеть, изменилось ли поведение системы.
Почему это не просто красивая визуализация
Компактность здесь не самоцель. Когда у вас 20 состояний вместо тысяч строк текста, появляется возможность рассуждать о режимах работы агента: вот цикл «попробовал — получил ошибку — повторил», вот ветка «задача ушла в уточняющие вопросы», вот редкое состояние, из которого почти нет выходов. Дальше с этими режимами можно работать инженерно — например, строить признаки, которые считаются по каждому состоянию.
Предсказание следующего шага: состояние важнее памяти
Для предсказания очередного действия агента авторы используют контекст состояния FSM. И этот подход обходит Agent Workflow Memory на каждом датасете, где разметка согласована с реальным ходом выполнения. Иначе говоря, знание «в каком режиме сейчас находится агент» оказывается полезнее, чем накопленная память о прошлых эпизодах работы.
Здесь есть интересный нюанс. Контекст состояния — это не просто номер узла, а сжатое описание того, что уже произошло и с какой вероятностью произойдёт дальше. Получается своего рода карта вероятных продолжений, построенная не на семантике текста, а на статистике переходов. Для практики это означает, что предсказатель следующего шага можно обучать дешевле: ему не нужен доступ к скрытым состояниям модели, достаточно структуры.
Предсказание сбоя и мониторинг по частичной трассе
Вторая половина работы — про диагностику. Признаки, посчитанные по отдельным состояниям автомата, дают AUROC до 0.94 на отложенных данных. То есть модель, которая ничего не знает о внутренностях LLM, по поведенческим характеристикам различает прогоны, которые закончатся провалом, и те, что дойдут до конца.
Самое практичное здесь — онлайн-монитор. Он смотрит на неполную трассу и ранжирует сбойные запуски выше успешных, не дожидаясь финала. Этого достаточно, чтобы включать раннюю остановку задолго до того, как агент окончательно уйдёт не туда: сэкономить токены, время и, что важнее, не дать ему навредить. Для агентов, которые пишут в базы, вызывают платёжные API или управляют инфраструктурой, такая возможность прервать выполнение на середине — не роскошь, а требование.
Главный вывод: поведение задаёт обвязка, а не модель
Пожалуй, самый провокационный тезис статьи звучит так: поведенческая топология агента в значительной степени определяется не самой языковой моделью, а deployment harness — той обвязкой, в которой модель запускается. Промпт-шаблон, набор инструментов, правила обработки ошибок, лимиты шагов — вот что формирует граф переходов.
Из этого следует несколько выводов. Во-первых, замена модели на другую при той же обвязке может не изменить структуру поведения радикально — а значит, и автомат, собранный на одной модели, стоит проверять на другой. Во-вторых, улучшать агента часто эффективнее через изменения в harness, а не через апгрейд весов. В-третьих, появляется model-agnostic структурный примитив: один и тот же подход годится для аудита безопасности и для runtime-мониторинга независимо от того, чей API вы вызываете.
Что стоит держать в голове
Подход не отменяет осторожности. Двенадцать датасетов — это всё ещё ограниченная выборка, а fitness 0.997 говорит о том, как хорошо автомат описывает уже собранные трассы, а не о том, что он предскажет поведение системы в незнакомой среде. Высокий AUROC для предсказания сбоя тоже получен на конкретных задачах: в новых доменах признаки придётся пересчитывать.
И всё же направление выглядит здраво. Вместо того чтобы бесконечно увеличивать окно контекста и надеяться, что модель «сама разберётся», можно один раз построить компактную модель поведения своей обвязки — и дальше пользоваться ей как схемой: смотреть, где агент застревает, какие состояния ведут к провалу, и что изменится, если поправить конфигурацию. Автомат не умнее LLM, но он честнее: его можно целиком уместить в голове, а это уже половина успеха в отладке.


