
Исполнительный контроль LLM-агентов: вынос оценки прогресса и права на остановку за пределы генератора экономит треть токенов
Препринт описывает режим, при котором языковой агент после достижения цели продолжает малополезные доработки и проверки, объясняя это самоподкрепляющимся контуром, где генерация, оценка прогресса и решение об остановке не разделены. Предложенная надстройка глобального управления с учётом неопределённости удерживает успешность на уровне около 96,6% и при этом снижает средний расход токенов на 36,4%, хотя выводы пока получены на механистических симуляциях.
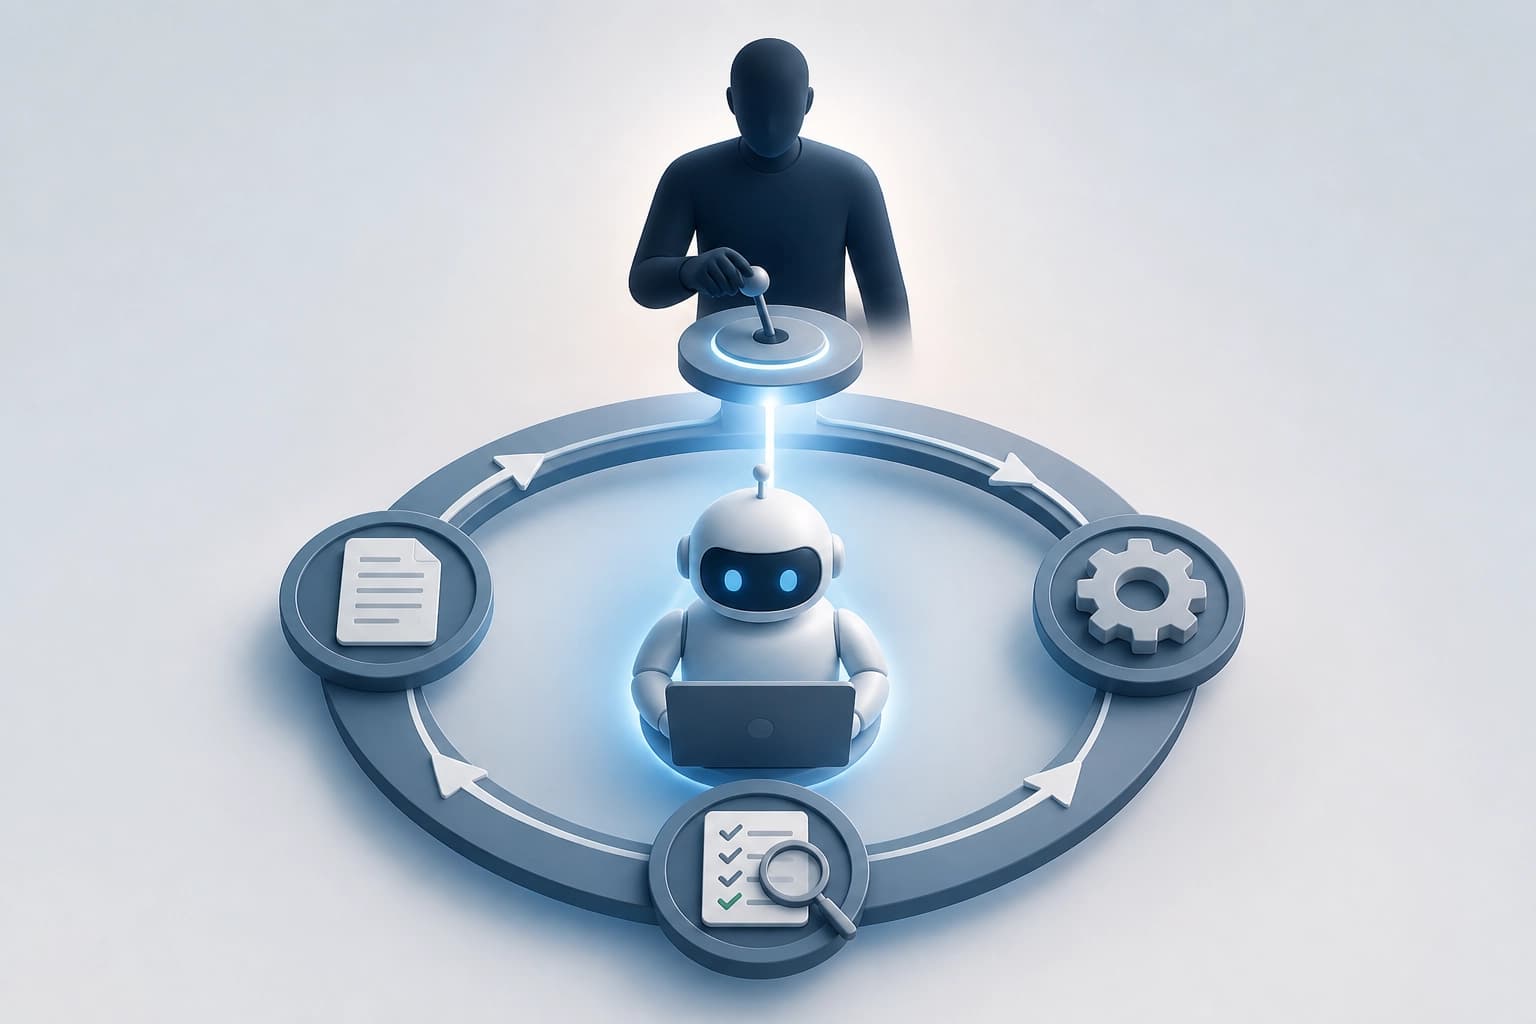
Что такое LLM Parkinsonism
Термин LLM Parkinsonism вводят как узкую неклиническую метафору. Она описывает устойчивое продолжение действий при снижении их ценности для задачи.
Признаки такого поведения:
- агент продолжает действовать после достижения исходной цели;
- выполняет низкоценные доработки;
- запускает повторные проверки;
- исправляет сложность, созданную самим собой.
Вывод: метафора указывает на сбой управления, а не на клиническую аналогию.
Почему самоконтроль в одном контуре усиливает проблему
Авторы связывают проблему не только с авторегрессивным предсказанием следующего токена. Причина также в концентрации четырех функций в одном контуре.
- генерация предложений;
- интерпретация области задачи;
- оценка прогресса;
- полномочия остановки.
Такой контур работает с самоподкреплением. Оценка, генерация и остановка влияют друг на друга.
Вывод: чтобы разорвать самоподкрепление, нужно вынести часть функций за пределы генератора.
Global Executive Control: что выносится за пределы генератора
Global Executive Control (GEC) v0.2 — архитектура управления с учетом неопределенности. Она отделяет генерацию действий от контроля на уровне проекта.
За пределы генератора выносятся:
- область задачи;
- свидетельства;
- расход ресурсов;
- остановка.
Контроль на уровне проекта получает право остановки и оценку прогресса. Генератор отвечает за действия.
Вывод: практический критерий — оценка прогресса и остановка должны находиться вне контура генерации.
Что показывают измерения
Бенчмарк включал 24,000 эпизодов с сопоставимыми кандидатами и общим ограничением в 40,000 токенов. Сравнивались три варианта.
| Вариант контроля | Успех по жесткой цели |
|---|---|
| Базовый с первым кандидатом | 67.42% |
| Локальный контроль с набором кандидатов | 96.53% |
| GEC | 96.57% |
Доступ к нескольким вариантам действий объясняет большую часть прироста успеха. GEC сохранила успешность и снизила среднее использование токенов.
- среднее использование токенов: с 19,782 до 12,574 (36.4%);
- ограниченное среднее число токенов до завершения при потолке в 40,000 токенов: с 16,136 до 13,114 (18.7%).
GEC устранила измеренный дрейф до завершения задачи и резко сократила избыточную сложность. Чувствительность к накладным расходам управления оставалась благоприятной при добавлении до 500 синтетических токенов управления за цикл.
Вывод: основной прирост успеха дает набор кандидатов; GEC добавляет к этому экономию токенов и контроль сложности.
Практические критерии для выбора контроля
Проверять стоит пять условий:
- внешняя оценка прогресса отделена от генератора;
- право остановки находится вне контура генерации;
- доступно несколько кандидатов действий;
- учитывается расход ресурсов;
- учитывается неопределенность.
Вывод: если эти функции остаются внутри генератора, риск низкоценных доработок и лишних токенов сохраняется.
Ограничения и что проверять дальше
Результаты получены на механистических симуляциях. Авторы считают, что они поддерживают явное управление областью задачи, свидетельствами, расходом ресурсов и остановкой.
Ограничения:
- проверка на реальных моделях остается необходимой;
- механистические симуляции не заменяют такую проверку.
Вывод: архитектурный принцип выглядит обоснованным, но переносить цифры на реальные LLM без проверки нельзя.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026
Модель мира для агентов на закрытых LLM: коррекция в точках риска
Предложен PAWM — внешний предиктор, который не дублирует пошаговое наблюдение, а включается при вероятном сбое и уводит агента от ошибочного действия. После SFT на синтетических сценариях и GRPO-кообучения метод дал прирост 24,3% в ScienceWorld и 7,7% в WebArena-Lite для Claude Sonnet 4.5.
4 ноября 2026
Классификационная надстройка над SpeechLLM: где она обходит генерацию меток при распознавании эмоций
На материале IEMOCAP и MELD сопоставлены генеративный вывод эмоциональной метки и линейный классификатор поверх скрытых представлений компактной SpeechLLM. Прирост качества от классификатора не универсален: он зависит от корпуса и от того, используются эталонные транскрипты или результаты ASR.
4 ноября 2026