
Классификационная надстройка над SpeechLLM: где она обходит генерацию меток при распознавании эмоций
На материале IEMOCAP и MELD сопоставлены генеративный вывод эмоциональной метки и линейный классификатор поверх скрытых представлений компактной SpeechLLM. Прирост качества от классификатора не универсален: он зависит от корпуса и от того, используются эталонные транскрипты или результаты ASR.
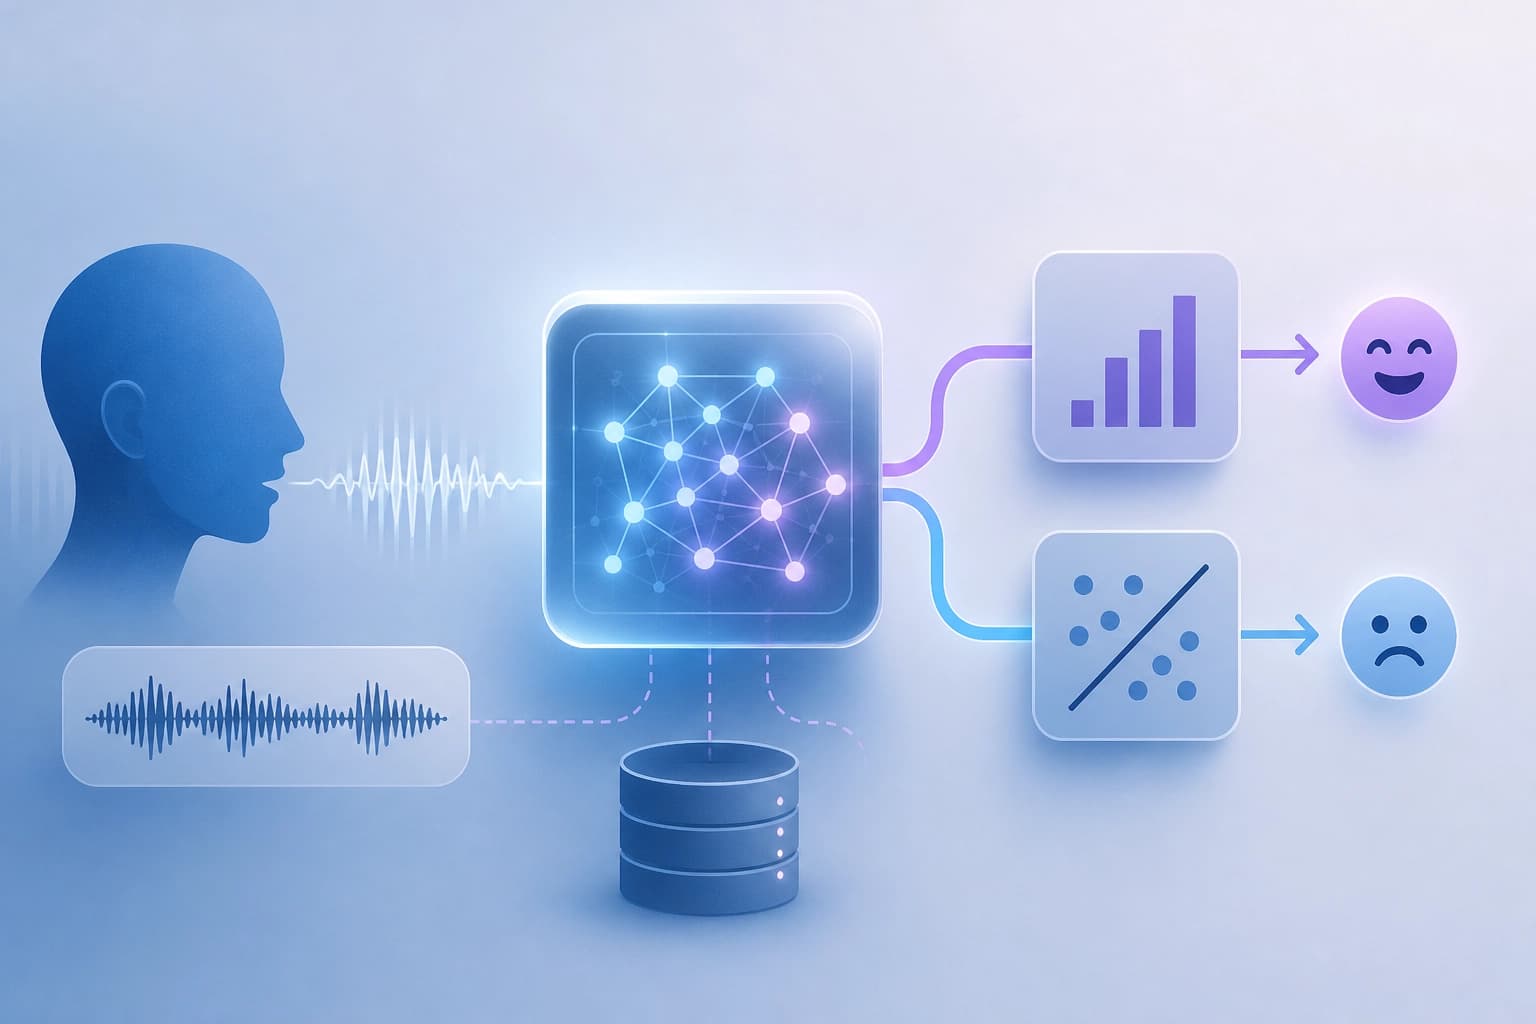
Два подхода к распознаванию эмоций
В статье сравнивают генерацию LLM токена-метки и дискриминативную классификацию с линейной головой поверх скрытых состояний LLM. Генеративный подход опирается на уже имеющиеся выходные представления LLM. Дискриминативный подход добавляет к модели отдельную классификационную голову.
| Критерий | Генерация токена-метки | Дискриминативная классификация |
|---|---|---|
| Роль LLM | Даёт выходные представления для метки | Даёт скрытые состояния для головы |
| Механизм решения | LLM генерирует токен-метку | Линейная голова классифицирует скрытое состояние |
| Что используется | Готовый выход модели | Скрытые состояния LLM |
Практическая разница в том, что генерация использует готовый выход модели, а голова читает скрытые состояния.
Условия сравнения
Сравнения провели на IEMOCAP и MELD. Использовали компактную SpeechLLM: замороженный энкодер Whisper-medium и 3B LLM. Для каждого сравнения брали эталонные транскрипты и транскрипты ASR. Сравнение охватывает два источника текста, поэтому эффект головы проверяли отдельно для каждого. Критерий оценки: сопоставлять результаты только внутри одного набора данных и одного источника транскрипта.
Где классификационная голова обходит генерацию меток
Классификационная голова улучшила Macro F1 в 10 из 14 конфигураций. На IEMOCAP она улучшила все конфигурации с транскриптами ASR и достигла 76.97% Macro F1. Там же значимый прирост показал режим только речи. На MELD голова помогла при использовании только речи, но не с транскриптами ASR. Вывод: выигрыш зависит от набора данных и источника транскрипта. Универсального обхода генерации меток нет.
Почему нельзя переносить выводы с эталонных транскриптов
На MELD транскрипты ASR имеют WER 32.38%. В 4 из 6 конфигураций с текстом эффект головы меняет знак между эталонными транскриптами и ASR. Поэтому выводы, сделанные на эталонных транскриптах, не обязательно сохраняются при ASR. Практический критерий: проверять голову на том источнике текста, который будет использоваться.
Что показывают ближайшие токены словаря
На IEMOCAP и MELD ближайшие к выученным векторам классов токены словаря LLM в основном были словами, связанными с эмоциями. Они не были явными названиями эмоций. Это показывает, что явное название эмоции не обязательно совпадает с ближайшим токеном словаря. Критерий проверки: смотреть, какие токены близки к вектору класса, а не только на название метки.
Критерий выбора
Выбор подхода опирается на два факта: набор данных и источник транскрипта.
- Для ASR-транскриптов проверять голову на ASR, а не на эталонном тексте.
- Для режима только речи учитывать прирост на IEMOCAP и MELD.
- Для эталонных транскриптов не переносить вывод на ASR.
- Для интерпретации классов смотреть ближайшие токены словаря LLM.
Итоговый критерий: голова обходит генерацию меток там, где проверка на целевом наборе и источнике транскрипта показывает выигрыш.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026
Модель мира для агентов на закрытых LLM: коррекция в точках риска
Предложен PAWM — внешний предиктор, который не дублирует пошаговое наблюдение, а включается при вероятном сбое и уводит агента от ошибочного действия. После SFT на синтетических сценариях и GRPO-кообучения метод дал прирост 24,3% в ScienceWorld и 7,7% в WebArena-Lite для Claude Sonnet 4.5.
4 ноября 2026
От индивидуальных оценок к допустимым наборам: глобальное декодирование при ограничениях DDI
Статья сопоставляет точный глобальный подбор совместимого набора препаратов, реализованный через mixed-integer linear programming, с несколькими схемами локального устранения конфликтов DDI при фиксированных оценках FLAME на MIMIC-III. На тестовой выборке глобальный вариант даёт небольшой, но устойчивый выигрыш по Jaccard, который растёт при ужесточении ограничений и достигает +0.0064 относительно сильнейшего локального базового метода.
4 ноября 2026