
Модель мира для агентов на закрытых LLM: коррекция в точках риска
Предложен PAWM — внешний предиктор, который не дублирует пошаговое наблюдение, а включается при вероятном сбое и уводит агента от ошибочного действия. После SFT на синтетических сценариях и GRPO-кообучения метод дал прирост 24,3% в ScienceWorld и 7,7% в WebArena-Lite для Claude Sonnet 4.5.
Проблема: агенту не хватает знаний о среде
Передовые агенты на LLM типа «чёрный ящик» хорошо справляются с рассуждениями на длинном горизонте и точной генерацией действий. Для конкретной агентной задачи у них нет усвоенных знаний о том, как развивается среда. Статья arXiv:2610.29139 с датой подачи 21 октября 2026 года описывает этот разрыв.
Модель мира дает агенту знания о конкретной среде. Она предсказывает реакцию среды на действие, которое агент собирается выполнить. Такая модель добавляет сведения о задаче.
Практический критерий: проверять связь модели мира с целевой средой. Общие знания о рассуждениях не закрывают разрыв в понимании конкретной задачи.
Режим коррекции: не каждый шаг, а точка риска
Предыдущие модели мира для LLM-агентов преимущественно предсказывают следующее наблюдение на каждом шаге. Такой режим затратен и малоинформативен. Отдельные наблюдения дают ограниченное руководство, связанное с задачей. Предвидение требуется не на каждом шаге.
Пилотное исследование показало: руководство модели мира наиболее полезно, когда она предвидит ловушки в ограниченном многошаговом будущем. Значит, коррекция должна включаться в точках риска, а не работать непрерывно.
| Вариант | Что известно |
|---|---|
| Пошаговое предсказание | Предсказывает следующее наблюдение на каждом шаге; затратно и малоинформативно. |
| Предвидение ловушек | Предвидит ловушки в ограниченном многошаговом будущем; дает наиболее полезное руководство. |
Практический критерий: выбирать режим, который включается при потенциальной ловушке и не тратит предвидение на каждый шаг.
Как работает предвидение ловушек
Авторы представили Pitfall Anticipation World Model (PAWM). Модель работает через три элемента:
- выборочно вмешивается при возникновении потенциальной ловушки;
- предсказывает надвигающуюся неудачу;
- уводит агента от ловушки в точке риска.
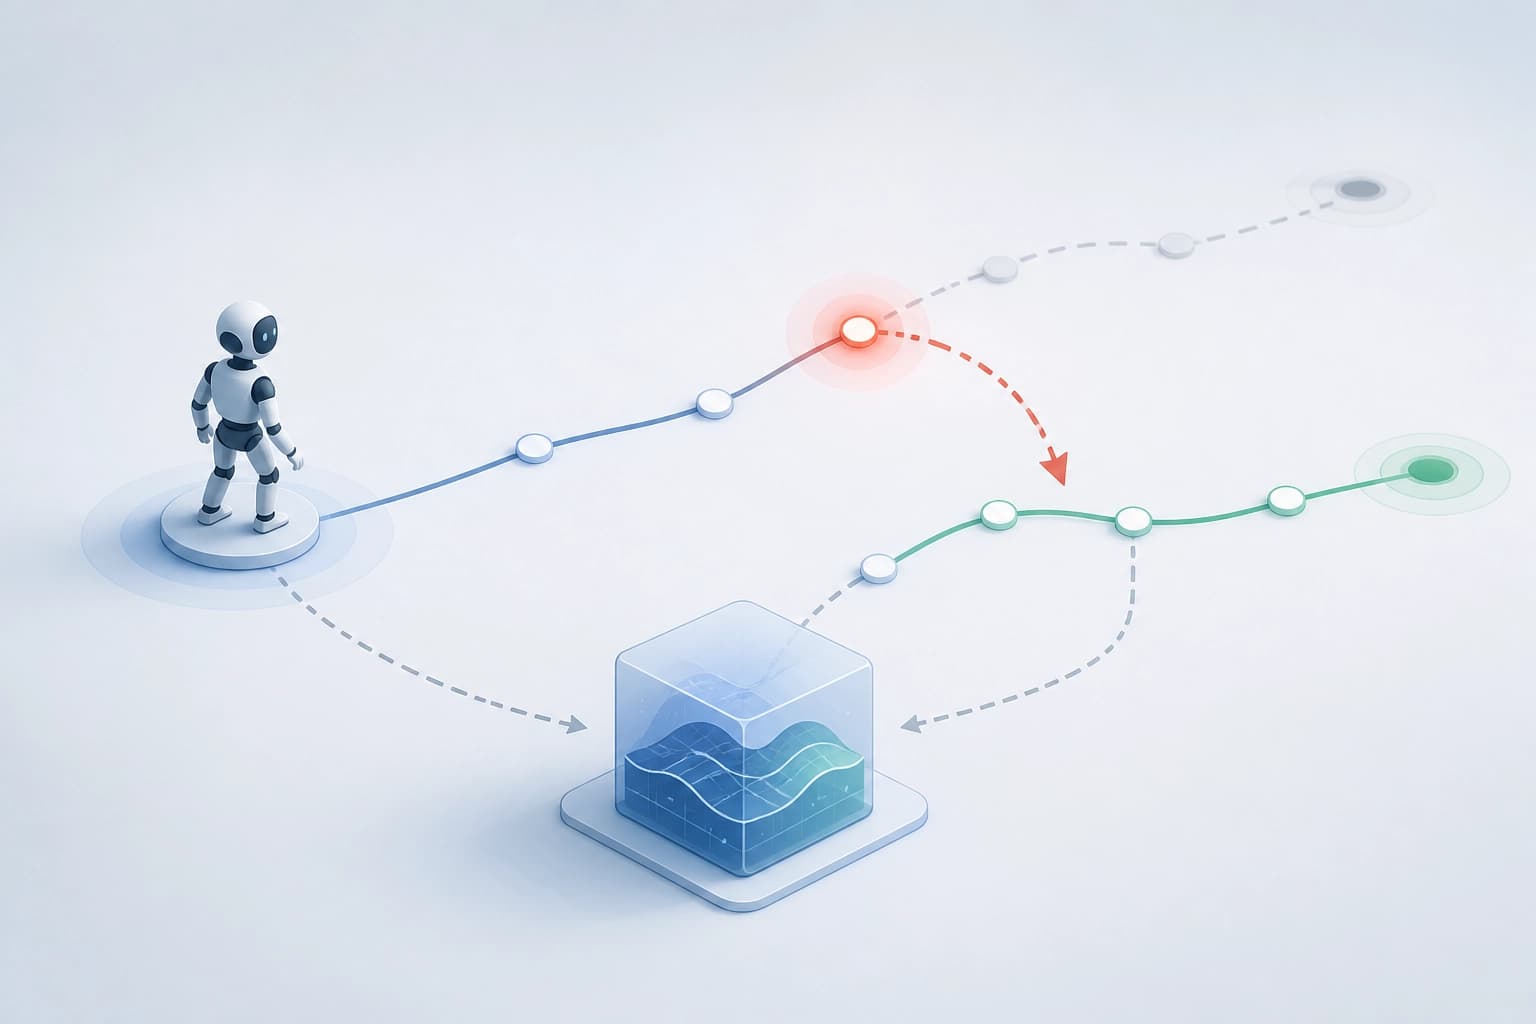
Практический критерий: триггер коррекции должен опираться на потенциальную ловушку и прогноз надвигающейся неудачи.
Двухэтапное обучение модели
Авторы обучают Pitfall Anticipation World Model (PAWM) в два этапа.
- Supervised Fine-Tuning (SFT) на синтетических данных. Синтетические данные содержат разметку ловушек для агентов.
- GRPO co-training с LLM типа «чёрный ящик». Он оптимизирует модель в целевой среде.
Практический критерий: проверять оба этапа — разметку ловушек и co-training в целевой среде.
Оценка: где смотреть прирост
Метод улучшает результаты Claude Sonnet 4.5 на 24.3% в ScienceWorld и на 7.7% в WebArena-Lite.
| Среда | Прирост для Claude Sonnet 4.5 |
|---|---|
| ScienceWorld | 24.3% |
| WebArena-Lite | 7.7% |
Авторы также указывают, что модель превосходит ряд базовых методов. Практический критерий: смотреть на прирост в целевой среде и на сравнение с базовыми методами. Перенос результата между средами требует отдельной проверки.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026
Классификационная надстройка над SpeechLLM: где она обходит генерацию меток при распознавании эмоций
На материале IEMOCAP и MELD сопоставлены генеративный вывод эмоциональной метки и линейный классификатор поверх скрытых представлений компактной SpeechLLM. Прирост качества от классификатора не универсален: он зависит от корпуса и от того, используются эталонные транскрипты или результаты ASR.
4 ноября 2026
От индивидуальных оценок к допустимым наборам: глобальное декодирование при ограничениях DDI
Статья сопоставляет точный глобальный подбор совместимого набора препаратов, реализованный через mixed-integer linear programming, с несколькими схемами локального устранения конфликтов DDI при фиксированных оценках FLAME на MIMIC-III. На тестовой выборке глобальный вариант даёт небольшой, но устойчивый выигрыш по Jaccard, который растёт при ужесточении ограничений и достигает +0.0064 относительно сильнейшего локального базового метода.
4 ноября 2026