
Составная мультиагентная ИИ-система с доказательным контуром для протонного планирования при опухолях головы и шеи
Работа описывает связку обученной PPO политики, которая выдаёт несколько вариантов плана, и LLM-агентов, ведущих диалоговое уточнение с проверкой клинических метрик и ограничений; на материале 21 пациента дообученная Qwen3-14B лучше следовала инструкциям и помогала смещать компромисс в пользу приоритетных целей. Практический вывод — автоматическое DRL-планирование можно дополнить управляемым диалогом, сохраняя контроль над конкурирующими ограничениями.
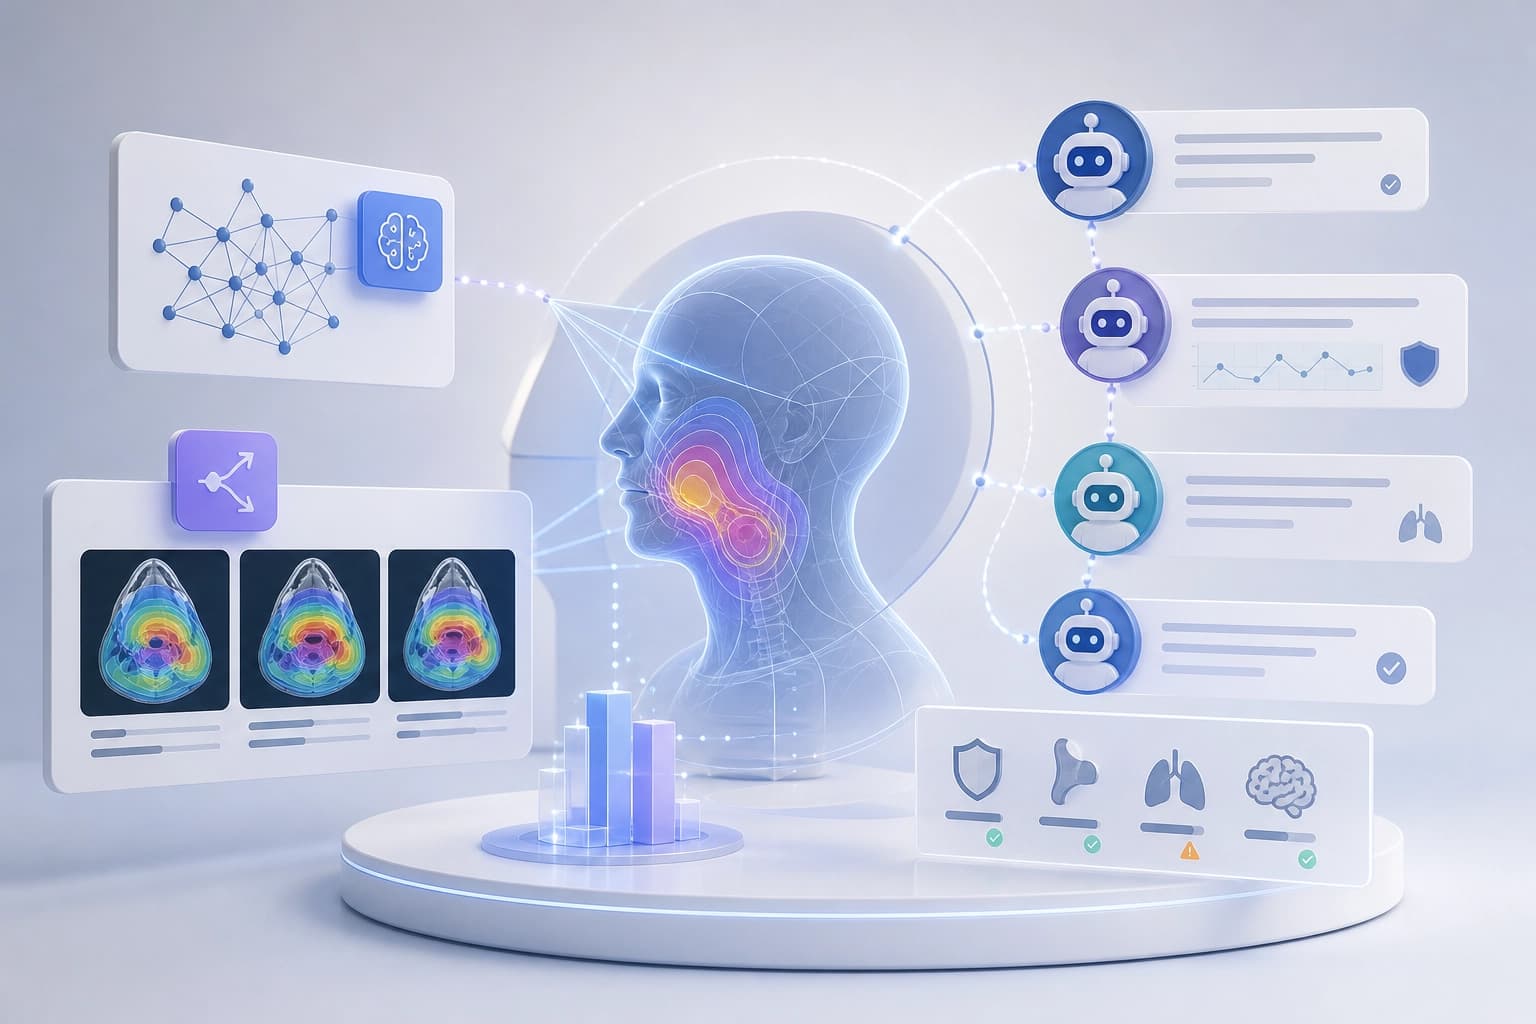
Составная архитектура: генерация и уточнение
Qingqing Wang, Liqiang Xiao и Chang Chang опубликовали статью на arXiv 21 Oct 2026 (arXiv:2610.29010). В ней они описали систему для протонной терапии PBS при раке головы и шеи. Система объединяет автоматическое планирование на основе DRL и диалоговое уточнение планов с помощью LLM.
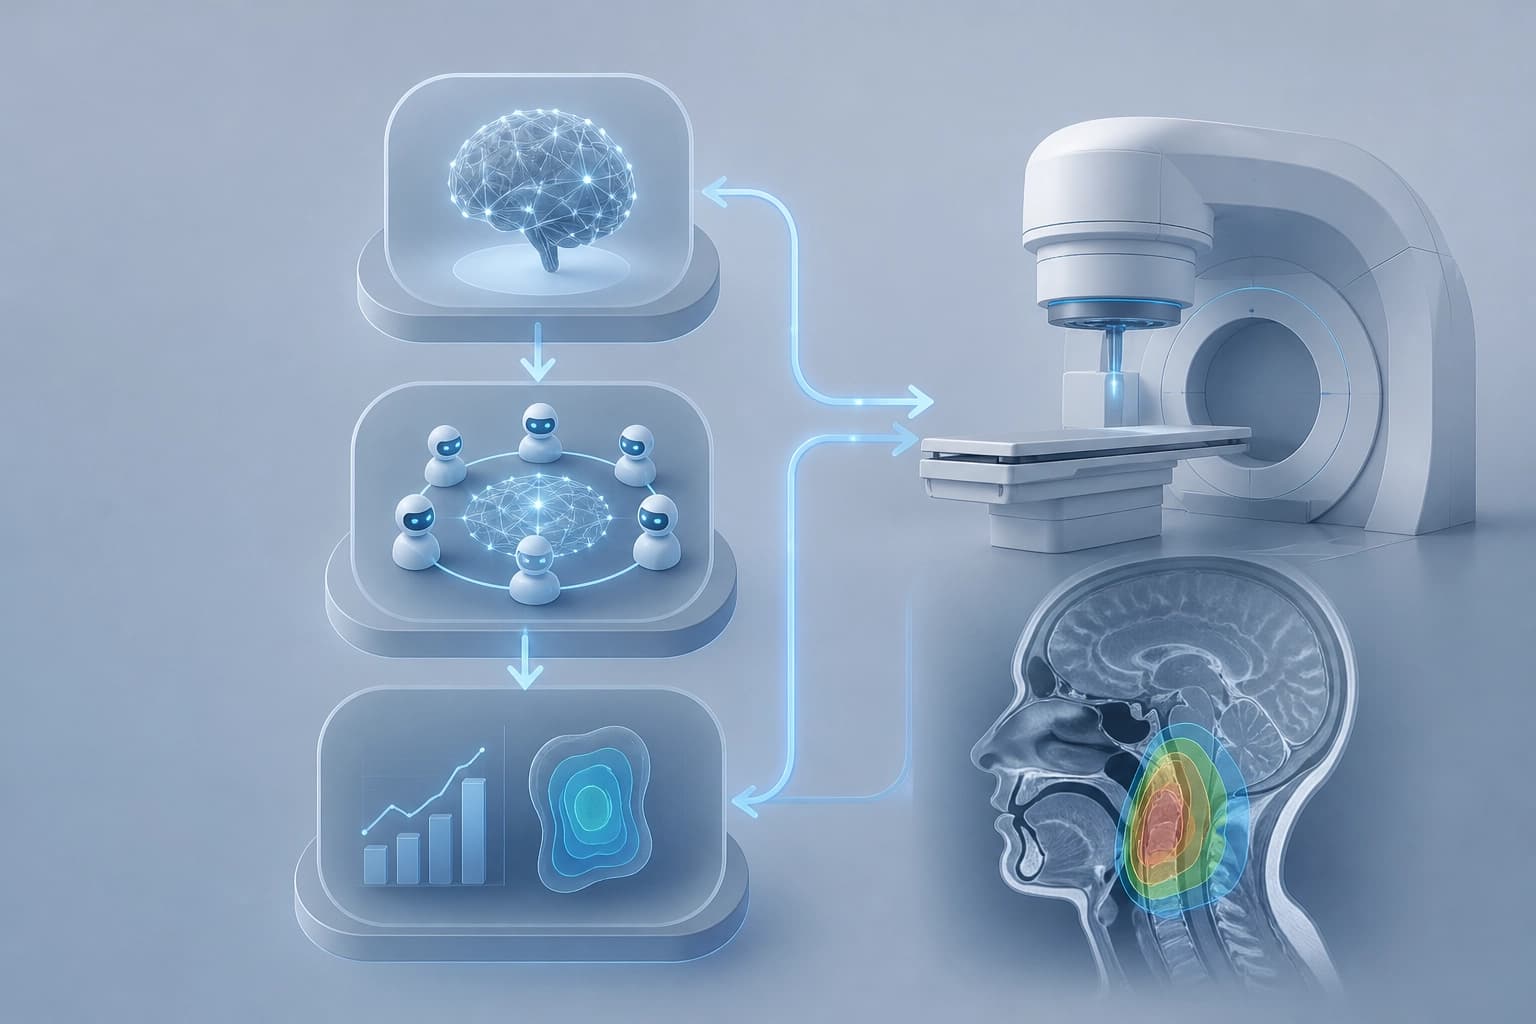
Автоматический этап на основе DRL создает набор планов. Система выбирает один план как целевой, остальные использует как справочные при уточнении. Для сложных случаев система предусматривает мультиагентную LLM-архитектуру, которая уточняет план в диалоге на естественном языке. Вывод: схема разделяет автоматическую генерацию и диалоговое уточнение с опорой на данные.
Автоматическая генерация планов на PPO
Автоматический этап опирается на PPO policy network. Авторы обучили сеть без участия человека; она сначала генерирует несколько планов. Обучение и оценка шли на данных 21 пациента с раком головы и шеи. Для каждого пациента авторы сгенерировали 5 PPO-планов.
Набор из нескольких планов дает материал для выбора целевого плана и справочную базу для уточнения. Критерий: автоматическая генерация должна выдавать не один план, а набор. Тогда у уточняющего контура будет опора.
Мультиагентный контур уточнения
Для сложных случаев система использует мультиагентную LLM-архитектуру. Она уточняет план через взаимодействие на естественном языке. В контур входят planning agent, chatbot и evaluation agent.
Planning agent предлагает корректировки с опорой на данные. Chatbot служит единым интерфейсом диалога. Evaluation agent формирует доказательный контур: извлекает клинические метрики и выявляет нарушения ограничений.
Такой контур делает уточнение проверяемым через клинические метрики и ограничения. Критерий: уточнение должно опираться на измеримые клинические показатели, а не только на текст диалога.
Обучение planning agent
Planning agent работает на основе Qwen3-14B. Он обосновывает рекомендации данными ранее созданных планов. Для дополнительного обучения на задачах авторы применяли SFT и GRPO.
По сравнению с базовой LLM дообученный Qwen3-14B показал улучшенные способности. Он лучше следует инструкциям, извлекает информацию и рассуждает в предметной области.
| Критерий | Базовая LLM | Дообученный Qwen3-14B |
|---|---|---|
| Следование инструкциям | Базовая способность | Улучшенная способность |
| Извлечение информации | Базовая способность | Улучшенная способность |
| Рассуждение в предметной области | Базовая способность | Улучшенная способность |
Практический критерий: для planning agent важна не только генерация, но и следование инструкциям, извлечение данных и предметное рассуждение. Дообучение на SFT и GRPO усиливает эти качества.
Оценка и клинические компромиссы
Авторы отобрали 50 планов для уточнения с инструкциями. Корректировки эффективнее улучшали цели, приоритетные для пользователя. При этом ухудшение конкурирующих целей оставалось ограниченным. Авторы сообщают, что корректировки позволили получать более клинически подходящие компромиссы при уточнении планов с учётом конкретного пациента.
Практический критерий: оценивать уточнение по улучшению приоритетных целей и по ограниченному ухудшению конкурирующих целей.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Вычислительный отбор вместо эмпирического перебора: новые подходы к материалам для аккумуляторов
Материал показывает, как расчётные базы, машинное обучение и генеративные модели сужают круг перспективных составов, а автоматизированные лаборатории ускоряют их проверку; при этом итог зависит от синтеза и испытаний, где прогноз может расходиться с реальной проводимостью.
20 ноября 2026
Эволюция агентных стендов при масштабировании пула задач: роль отбора свидетельств и последовательных гонок
Работа объясняет, почему наращивание числа задач может ухудшать эволюцию агентных стендов: причина — неудачный выбор свидетельств, а не объём данных как таковой. Предложенный Successive Scale Racing поочерёдно подбирает разнообразные комбинации задач и недорого сравнивает кандидатов; на трёх бенчмарках это повысило долю успешных прогонов при росте пула с 40 до 200, тогда как базовые методы деградировали, а проверочных запусков стало примерно на 60% меньше.
19 ноября 2026
Взаимное убеждение моделей: заявленные позиции не совпадают с поведением в диалоге
В контролируемых дебатах о причинах климатических изменений четыре пары GPT-6 Luna и Gemini 2.5 Flash Lite демонстрируют разную динамику сближения или расхождения установок. Прямое указание убеждать не даёт устойчивого эффекта, а декларируемая позиция и ходовая манера спора отражают не одно и то же.
19 ноября 2026