
Вычислительный отбор вместо эмпирического перебора: новые подходы к материалам для аккумуляторов
Материал показывает, как расчётные базы, машинное обучение и генеративные модели сужают круг перспективных составов, а автоматизированные лаборатории ускоряют их проверку; при этом итог зависит от синтеза и испытаний, где прогноз может расходиться с реальной проводимостью.
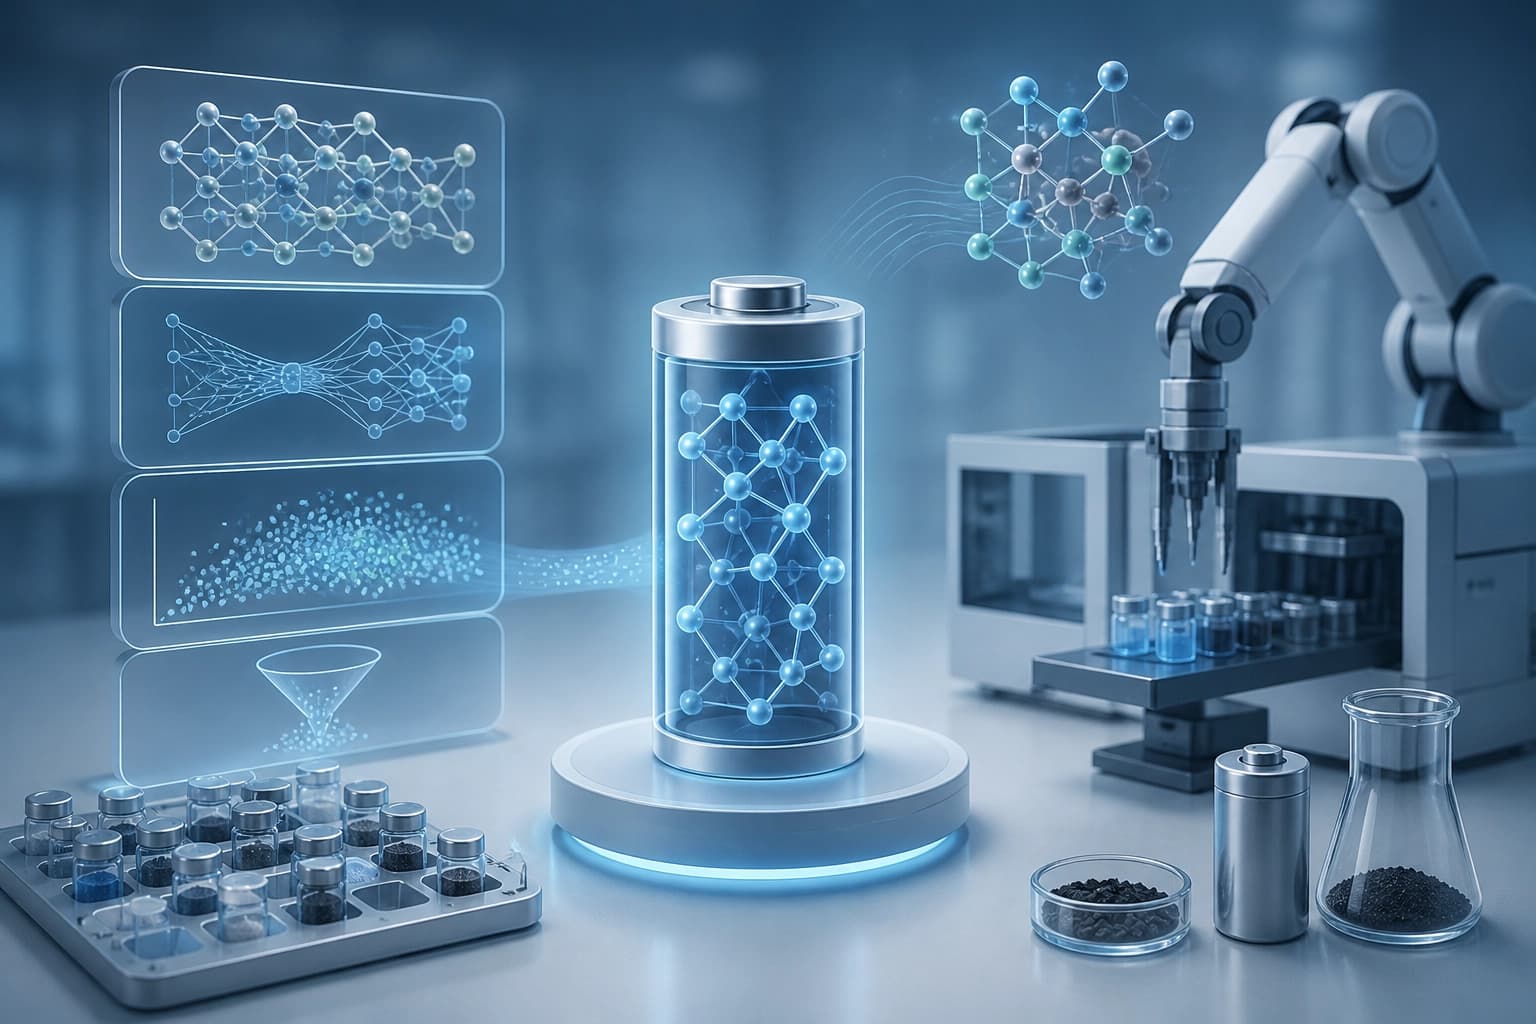
Почему эмпирический перебор упирается в масштаб
Традиционный поиск материалов идёт последовательно: синтез состава, измерение свойств, корректировка параметров. Такой цикл плохо работает, когда возможных материалов миллионы.
- Производителям аккумуляторов нужны элементы с большим запасом энергии, быстрой зарядкой, долгим сроком службы и низкой стоимостью.
- Свойства зависят от сочетания элементов и кристаллической структуры.
- Последовательный синтез и измерение плохо масштабируются на миллионы составов.
Практический критерий: лабораторный перебор стоит запускать после вычислительного отсева, а не вместо него.
Данные и модели как первый фильтр
Модели машинного обучения используют расчёты и предыдущие данные. Они оценивают свойства неизмеренных материалов и отсеивают слабые варианты. Экспериментальные данные существуют менее чем для 1% соединений в открытой научной литературе.
| Ресурс или модель | Роль | Факты |
|---|---|---|
| Materials Project | База данных и инструменты для материалов | Проект запустили в 2011 году в Berkeley Lab. У проекта более 650 000 зарегистрированных пользователей. Рецензируемые исследования цитировали данные и инструменты более 32 000 раз. Библиотека содержит более 200 000 материалов и более 577 000 молекул. Для работы с ней не нужны навыки программирования. |
| GNoME | Предсказание стабильности кристаллов | Google DeepMind обучила модель на данных Materials Project. В базу добавили новые соединения. |
| MatterGen | Генеративная модель для неорганических материалов | Microsoft создала модель. Она использует тот же ресурс. Модель предлагает новые структуры для проверки. |
Практический критерий: модель полезна, если сужает список кандидатов и опирается на расчётные и экспериментальные данные. Финальную проверку свойств она не отменяет.
Воронка: от миллионов составов к короткому списку
Воронка отбора начинается с большого списка и заканчивается решением о синтезе. Microsoft и Pacific Northwest National Laboratory использовали модели ИИ для поиска неорганических материалов. Модели предсказывали стабильность и ионную проводимость.
| Этап | Что происходит | Результат |
|---|---|---|
| Первичный поиск | Модели ИИ изучают возможные неорганические материалы. | Более 32 миллионов вариантов. |
| Фильтр стабильности | Модели отбирают стабильные кандидаты. | Более 500 000 кандидатов. |
| Сужение списка | Фильтрация сокращает список. | 150 кандидатов, затем 18 для экспертной оценки. |
| Физическая проверка | Суперкомпьютеры считают ведущие варианты подробнее. | Уточнение свойств. |
| Решение о синтезе | Учёные выбирают материалы для лаборатории. | Короткий список для изготовления. |
Вычисления заняли 80 часов. Команда оценила, что старым методам потребовалось бы 20 лет.
Практический критерий: вычислительная воронка полезна, если каждый следующий фильтр строже предыдущего, а решение о синтезе остаётся у учёных.
Где расчёт встречается с лабораторией
Расчётный список становится материалом только после синтеза и испытаний. Исследователи Pacific Northwest National Laboratory прошли путь от расчётного кандидата до работающего элемента.
- Изготовили твёрдый электролит, где часть лития заменили натрием.
- Получили материал с меньшим содержанием лития, чем в существующих литий-ионных аккумуляторах.
- Собрали твердотельный аккумулятор и испытали при комнатной и повышенной температуре.
- Зафиксировали проводимость ниже первоначальных ожиданий.
- Признали необходимость всесторонней оценки до массового производства.
- Переход от компьютерного списка к элементу занял недели.
В Berkeley Lab работает A-Lab: роботы под управлением ИИ изготавливают материалы. Конвейер моделирования соединяют с автоматизированными экспериментами. В Европе инициатива Battery 2030 plus работает над похожей целью.
Практический критерий: вычислительный отбор сокращает путь до эксперимента, но не гарантирует заявленные свойства. Работоспособность элемента решают испытания.
Критерии зрелости вычислительного отбора
Вычислительный отбор не сводится к одной модели. Он работает как цепочка решений.
| Критерий | Что показывает |
|---|---|
| Данные | Модель опирается на расчёты и прошлые измерения. |
| Целевые свойства | Модель оценивает стабильность и ионную проводимость. |
| Каскад проверки | Ведущие варианты проходят более подробные физические расчёты. |
| Роль эксперта | Учёные выбирают материалы для лабораторного синтеза. |
| Эксперимент | Свойства проверяют на изготовленном материале. |
Практический критерий: подход зрелый, если он ведёт от большого списка к проверяемым кандидатам и сохраняет экспериментальную проверку. Иначе остаётся только расчёт.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Составная мультиагентная ИИ-система с доказательным контуром для протонного планирования при опухолях головы и шеи
Работа описывает связку обученной PPO политики, которая выдаёт несколько вариантов плана, и LLM-агентов, ведущих диалоговое уточнение с проверкой клинических метрик и ограничений; на материале 21 пациента дообученная Qwen3-14B лучше следовала инструкциям и помогала смещать компромисс в пользу приоритетных целей. Практический вывод — автоматическое DRL-планирование можно дополнить управляемым диалогом, сохраняя контроль над конкурирующими ограничениями.
20 ноября 2026
Эволюция агентных стендов при масштабировании пула задач: роль отбора свидетельств и последовательных гонок
Работа объясняет, почему наращивание числа задач может ухудшать эволюцию агентных стендов: причина — неудачный выбор свидетельств, а не объём данных как таковой. Предложенный Successive Scale Racing поочерёдно подбирает разнообразные комбинации задач и недорого сравнивает кандидатов; на трёх бенчмарках это повысило долю успешных прогонов при росте пула с 40 до 200, тогда как базовые методы деградировали, а проверочных запусков стало примерно на 60% меньше.
19 ноября 2026
Взаимное убеждение моделей: заявленные позиции не совпадают с поведением в диалоге
В контролируемых дебатах о причинах климатических изменений четыре пары GPT-6 Luna и Gemini 2.5 Flash Lite демонстрируют разную динамику сближения или расхождения установок. Прямое указание убеждать не даёт устойчивого эффекта, а декларируемая позиция и ходовая манера спора отражают не одно и то же.
19 ноября 2026