Почему траектория — плохая единица измерения
Современные методы рассуждения во время инференса работают по одной и той же схеме: модель порождает не один ответ, а целый пул кандидатных цепочек, после чего внешняя reward-модель выбирает лучшую. Логика простая — чем больше вариантов, тем выше шанс, что среди них окажется удачный.
Слабое место здесь в другом. Каждый кандидат рассматривается как неделимое целое: его либо принимают целиком, либо целиком отправляют в мусор. Но длинное рассуждение редко бывает однородным. Типичная картина — уверенный, корректный старт, аккуратная постановка задачи, верно выбранный метод, а затем срыв: арифметическая ошибка, зацикливание, подмена условия. Формально вся цепочка помечается как неудачная, хотя её первая половина была вполне рабочей.
Итог — вычисления, потраченные впустую. Мы оплачиваем генерацию токенов, которые были правильными, а потом выбрасываем их вместе с испорченным хвостом. Именно на эту неэффективность и указывают авторы работы Selective Regenerative Decoding, опубликованной как arXiv:2608.24338 (cs.AI) 25 августа 2026 года.
SRD: три ветки вместо двух
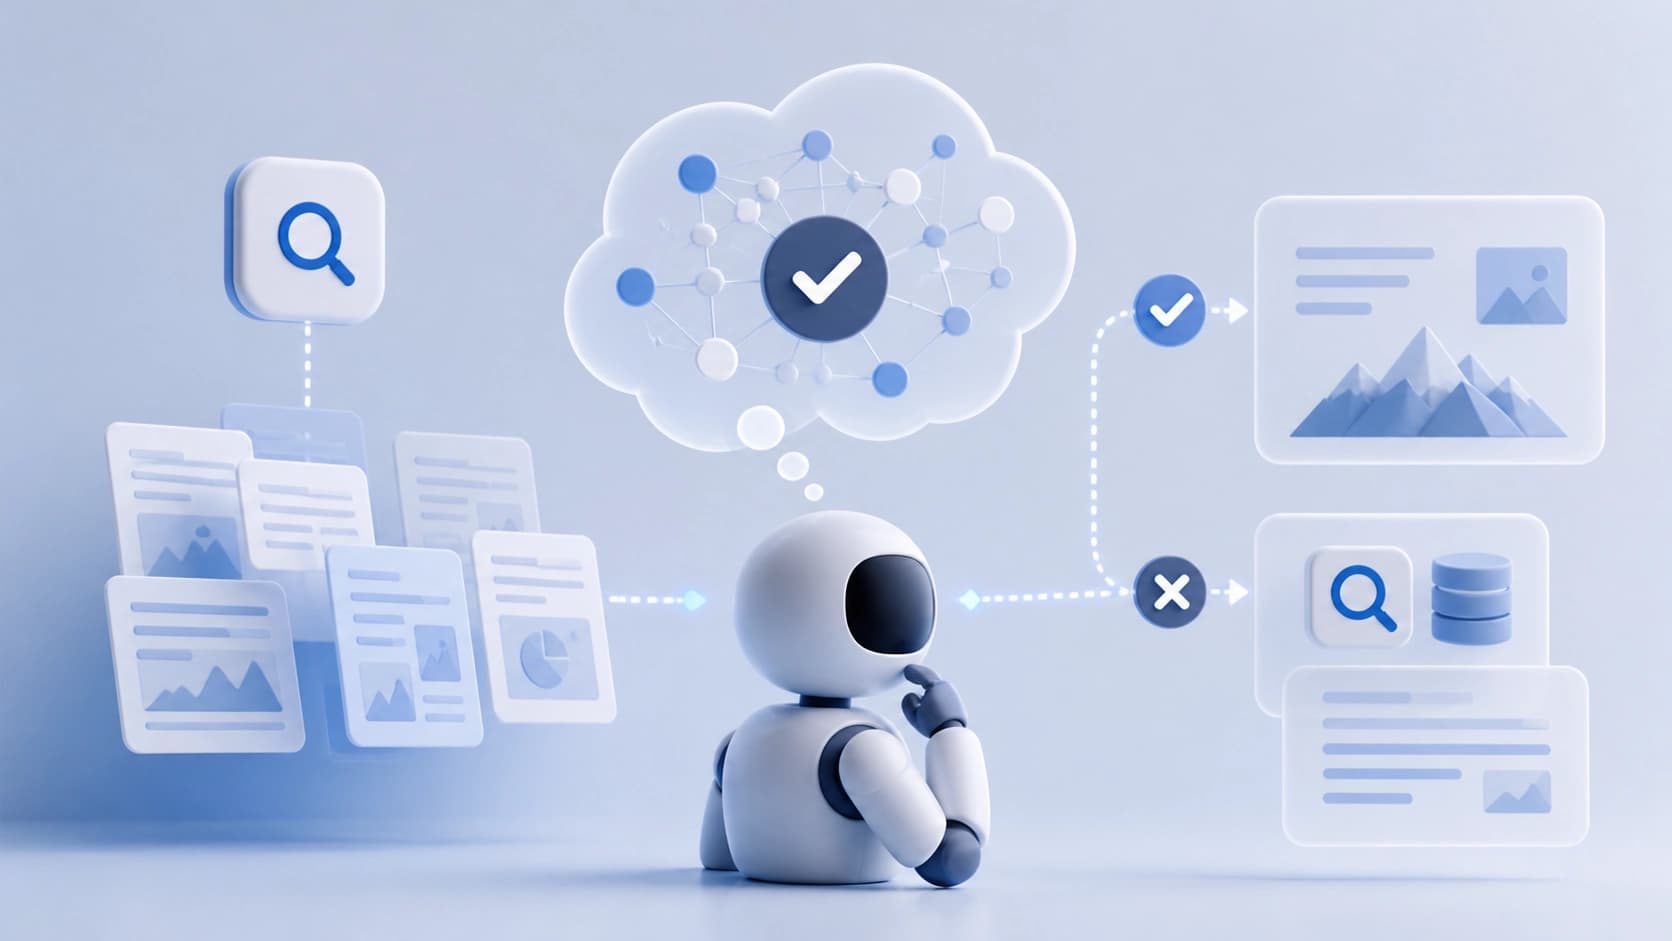
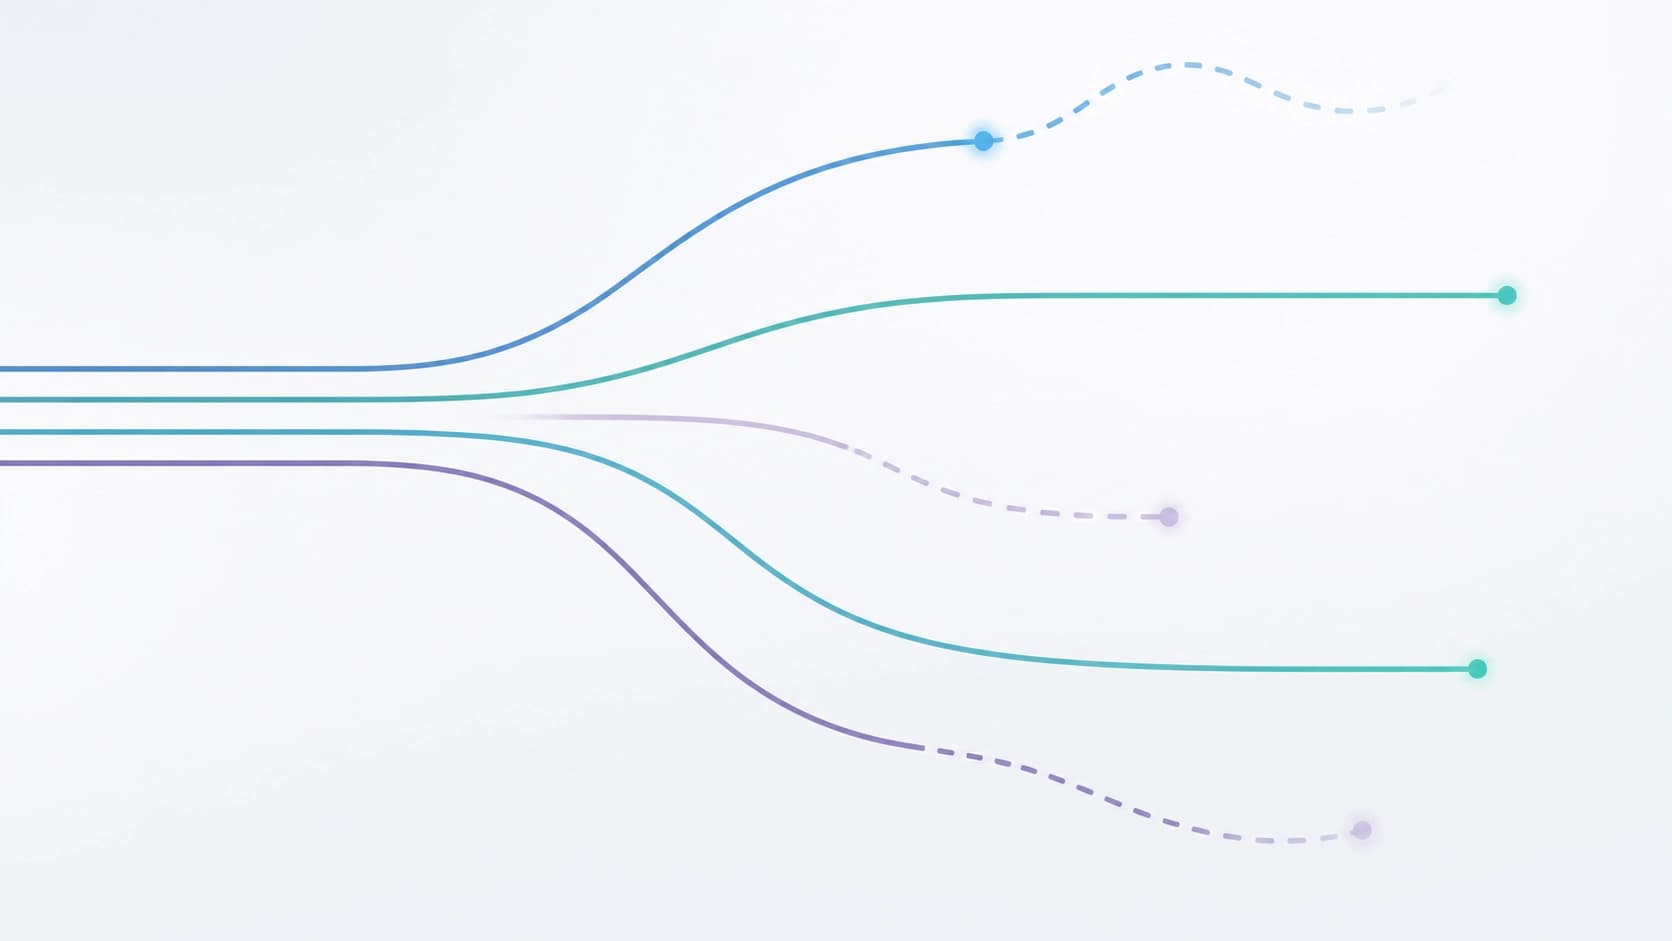
Selective Regenerative Decoding (SRD) предлагает отказаться от бинарного выбора. Вместо «принять или отбросить» каждый кандидат направляется в одну из трёх веток:
- отбросить — если цепочка бесполезна от начала до конца;
- сохранить — если она выдерживает проверку целиком;
- доработать — если полезная часть есть, но суффикс явно деградировал.
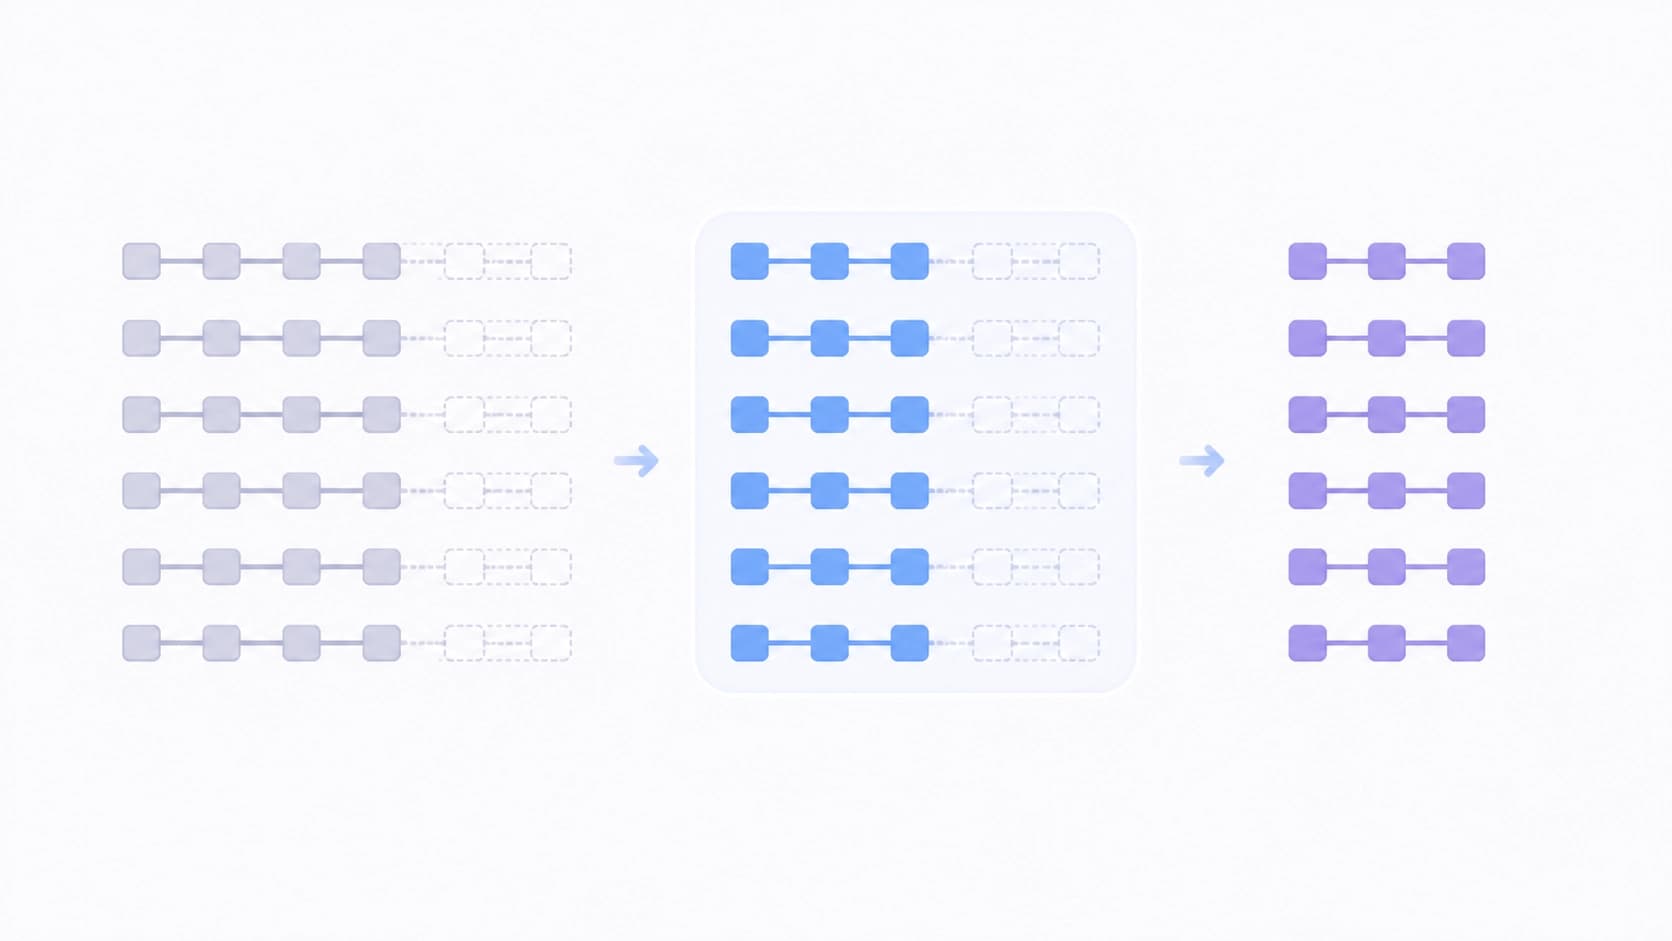
В третьем случае система не переписывает рассуждение с нуля, а сохраняет качественный префикс и регенерирует только испорченный участок. Это ближе к редактированию черновика, чем к написанию нового текста: вы не выбрасываете удачное вступление из-за провалившегося финала, а правите то, что сломалось.
Отдельно авторы подчёркивают, что для такого вмешательства не требуется более крупная модель-донор. Никакого «умного учителя», который бы вытягивал слабого ученика, — вся работа идёт в рамках уже имеющихся вычислительных ресурсов. Именно это делает метод прикладным, а не теоретическим упражнением.
Откуда берётся выигрыш
Самое интересное в работе — не эвристика, а её обоснование. При мягких допущениях SRD даёт доказуемый рост эффективности выборки в 1,28–1,36 раза относительно классического rejection sampling, причём ожидаемое качество итоговой траектории оказывается строго выше, а не просто «не хуже».
Интуиция здесь понятна без формул. Кандидат, прошедший через регенерацию суффикса, уже содержит в себе оплаченные вычисления — те токены префикса, которые не нужно генерировать заново. Чем больше таких пограничных кандидатов удаётся спасти, тем меньшая доля сгенерированного текста уходит в корзину. А поскольку при увеличении пула кандидатов растёт и число «почти удачных» цепочек, выигрыш не остаётся постоянным — он масштабируется вместе с бюджетом на генерацию.
Где это проверяли
Эмпирическая часть охватывает четыре разных типа нагрузки: MATH500 (математические задачи), GPQA Diamond (вопросы научного уровня), HotpotQA (многошаговые вопросы по документам) и AlpacaEval (следование инструкциям и оценка предпочтений). Тестирование проводилось на нескольких комбинациях «генератор + reward-модель», чтобы результат не зависел от одной удачной пары.
Заявленные итоги: SRD выходит на точность, которую обычно получают режимом Best-of-N, но расходует заметно меньше сгенерированных токенов. А в сценариях с ограниченными вычислениями метод обходит speculative rejection — то есть выигрывает именно там, где каждый лишний токен стоит дорого.
Что это меняет по существу
Главный сдвиг, который фиксируют авторы, — методологический. Раньше выбор происходил на уровне целой траектории: reward-модель ставила оценку и решала судьбу всего рассуждения. SRD переносит вмешательство внутрь траектории, на уровень сегментов, и за счёт этого открывает область компромисса между точностью и вычислениями, которая до сих пор почти не изучалась.
Практический вывод для тех, кто строит инференс-пайплайны: качество рассуждения и стоимость его получения — не обязательно жёстко связанные величины. Часть «лишних» вычислений можно вернуть, если перестать относиться к черновику модели как к монолиту.
Что остаётся за кадром
Открытых вопросов хватает. Ключевой — как именно определяется граница между здоровым префиксом и деградировавшим суффиксом: от этого критерия зависит, сколько кандидатов вообще попадёт в третью ветку. Дальше — цена самой регенерации (она не бесплатна), чувствительность к выбору reward-модели и переносимость выводов за пределы четырёх использованных бенчмарков.
Работа занимает 20 страниц и подана в ARR, то есть пока это препринт первой версии, а не отрецензированный результат. Но направление выглядит перспективным: вместо того чтобы генерировать больше и отбирать жёстче, можно аккуратнее распорядиться тем, что модель уже придумала.