Зачем нужен причинный граф — и почему его часто нет
Контрфактические вопросы звучат просто: «что было бы, если бы пациент получил другое лечение», «как изменился бы спрос, если бы мы подняли цену». Сложность в том, что ответ на них нельзя вывести из одних только наблюдаемых корреляций. Нужна модель того, как переменные влияют друг на друга, — то есть причинная структура.
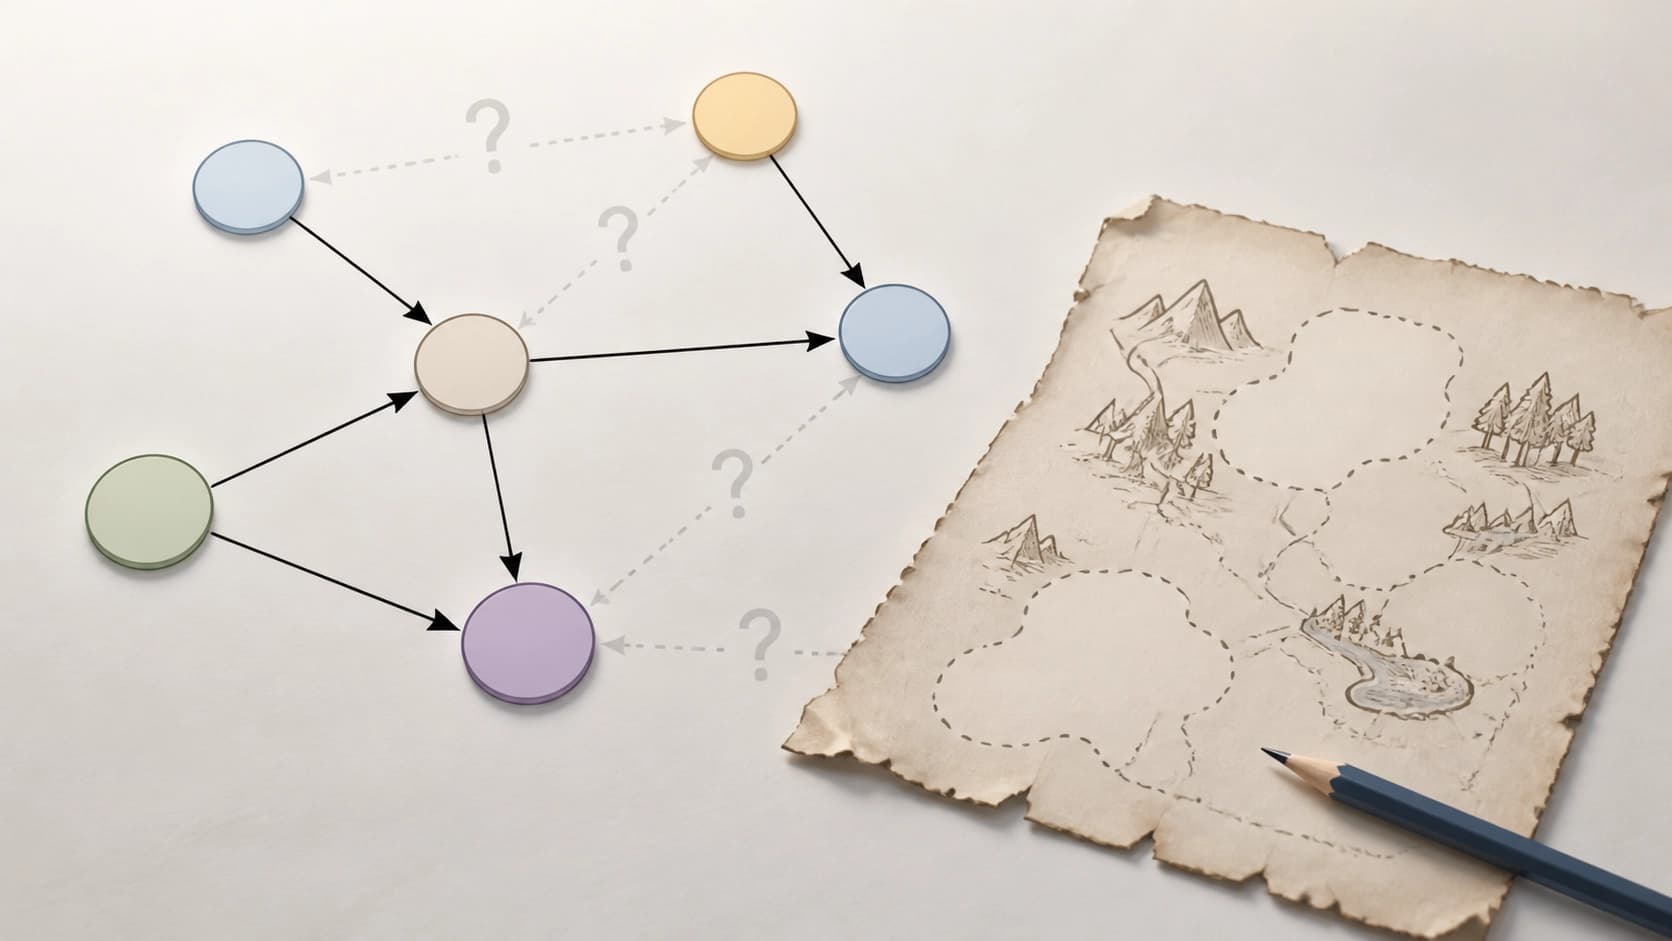
Классический рецепт в литературе по непараметрической идентификации такой: возьмите полностью заданный причинный граф, добавьте допущения о виде механизмов — и считайте интересующую величину либо её допустимый диапазон. Работает это надёжно, но опирается на роскошь, которой у аналитика почти никогда нет. Предметная область изучена частично, часть связей спорна, часть переменных вообще не измеряется. Полный граф в такой ситуации — не отправная точка, а недостижимый идеал.
Именно это расхождение между теорией и практикой пытаются закрыть Эрик Россетто и Алессандро Антонуччи в статье Partial Identification under Causal Orders by Linear Programming (arXiv:2608.24427). Их ход — не «достроить граф хоть как-нибудь», а вообще отказаться от требования иметь его на входе.
Запрос сам подсказывает структуру
Ключевое наблюдение авторов можно сформулировать так: контрафактический запрос — не нейтральный вопрос, а объект с внутренней логикой. Когда мы спрашиваем «что было бы, если бы переменная X приняла значение x», мы уже неявно выстраиваем переменные в некотором отношении: одно предшествует другому, одно зависит от другого, третье остаётся фоновым условием.
Формализуется это через топологический порядок. В обычном причинном графе такой порядок задан целиком и однозначно: если есть стрелка из A в B, то A идёт раньше. Но для идентификации полная упорядоченность и не нужна. Достаточно частичного порядка — набора отношений «раньше», которые покрывают не все пары переменных. Остальные пары просто остаются неупорядоченными, и это не мешает делу.
Центральный результат работы состоит в том, что любой контрфактический запрос порождает как раз такой — в общем случае частичный — топологический порядок над теми переменными, которые в него входят. Причём этот порядок не надо угадывать или вводить вручную: он извлекается из самой формулировки вопроса. Домен-специалисту больше не нужно отвечать на неудобный вопрос «нарисуйте весь граф»; достаточно согласиться с тем, что следует из постановки задачи.
От порядка к линейной программе
Дальше начинается техническая часть, ради которой всё и затевалось. Наличие порядка позволяет выписать запрос в явном параметризованном виде. Параметры здесь — не произвольные, а подчинённые структуре: они описывают распределения и механизмы так, чтобы согласовываться и с наблюдаемыми данными, и с выведенным порядком.
После такой переparamетризации задача идентификации перестаёт быть задачей о функциях и превращается в задачу о числах. А именно — в линейную программу: нужно минимизировать и максимизировать линейный функционал на множестве, заданном линейными ограничениями. Минимум и максимум и дают нижнюю и верхнюю границы интересующей величины.
Такой переход ценен не только элегантностью. Линейное программирование — хорошо изученная область с надёжными решателями, и перевод задачи в эту форму означает, что границы можно реально считать, а не только доказывать их существование. Схема работает для произвольных контрфактических запросов, включая вложенные: те, где гипотетический сценарий сам содержит внутри себя другой гипотетический сценарий. Вложенность всегда была головной болью для существующих методов, поскольку требует одновременного обращения к нескольким «слоям» мира.
Насколько границы узкие
Получить какие-то границы несложно — вопрос в том, полезны ли они. Если интервал накрывает почти весь мыслимый диапазон значений, толку от него немного.
Авторы отвечают на это доказательством точности. Идея конструкции: для каждой границы строится структурная причинная модель, которая её достигает. Такая модель обязана быть совместимой сразу с двумя вещами — с наблюдаемым распределением данных и с тем порядком, который подразумевает запрос. Если модель существует, значит граница не искусственная: её нельзя сдвинуть внутрь, не потеряв согласованности с доступной информацией. Значит, интервал узкий настолько, насколько это вообще возможно при заданных допущениях.
Это важный сдвиг в статусе результата. Речь не о «грубой оценке на пальцах» и не о том, что «в худшем случае может быть что угодно». Речь о честном описании неопределённости: вот всё, что можно утверждать, и ни шагом больше.
Связь с классической рамкой
Работа позиционируется как обобщение подхода Tian и Pearl, предложенного в 2000 году для вероятностей причинности. Та рамка тоже умела выдавать интервалы вместо точечных оценок, но была привязана к конкретному классу величин и требовала известной структуры. Новый результат расширяет класс запросов и снимает требование знать граф целиком. Полезно держать в голове эту преемственность: перед нами не изобретение с нуля, а аккуратное расширение того, что уже проверено временем.
Проверка на знакомых примерах
Чтобы показать, что метод не экзотика, авторы возвращаются к нескольким кейсам, разобранным в литературе ранее, и прогоняют их через свою процедуру. Условие эксперимента жёсткое: причинный граф на вход не подаётся вообще. Вместо него — только тот порядок, который вытекает из формулировки запроса.
Результат, о котором сообщают исследователи, состоит в том, что получаемые интервалы остаются информативными. Иными словами, отказ от полного графа не превращает вывод в бессодержательное «возможно всё». Это, пожалуй, самый практичный вывод статьи: цена незнания оказывается ниже, чем принято думать.
Что это меняет для практики
Практическая ценность сводится к нескольким пунктам.
- Снижается порог входа. Не нужно описывать всю систему целиком — достаточно согласиться с порядком, который и так подразумевается постановкой задачи.
- Неопределённость становится видимой. Вместо точечной оценки, за которой скрыты произвольные допущения, аналитик получает интервал и понимает, где именно проходит граница его знаний.
- Появляется инструментальная база. Сведение к линейной программе означает, что расчёт можно автоматизировать стандартными средствами, а не писать отдельный решатель под каждый класс запросов.
- Расширяется класс допустимых вопросов. Вложенные контрфактические конструкции, ранее требовавшие отдельной теории, попадают в общую схему.
Чего метод не обещает
Стоит обозначить и рамки. Во-первых, частичный порядок всё же нужно извлечь корректно: если из формулировки запроса выведено неверное отношение предшествования, обоснованность границ теряется. Во-вторых, ширина интервала напрямую зависит от того, насколько богаты наблюдаемые данные и сколько отношений удалось зафиксировать: чем более разрежен порядок, тем шире ответ. Метод не заменяет знание о предметной области — он позволяет работать с его фрагментами вместо отсутствующего целого.
Объём статьи — 15 страниц основного текста, к которым приложены три приложения, три рисунка и три таблицы, так что технические детали доказательств вынесены за пределы основного изложения и доступны отдельно. Для тех, кто занимается причинным выводом на реальных данных с дырами в описании системы, это, пожалуй, более интересная новость, чем очередная точечная оценка с неоговорёнными допущениями.