Почему агентный RAG упирается в развилку
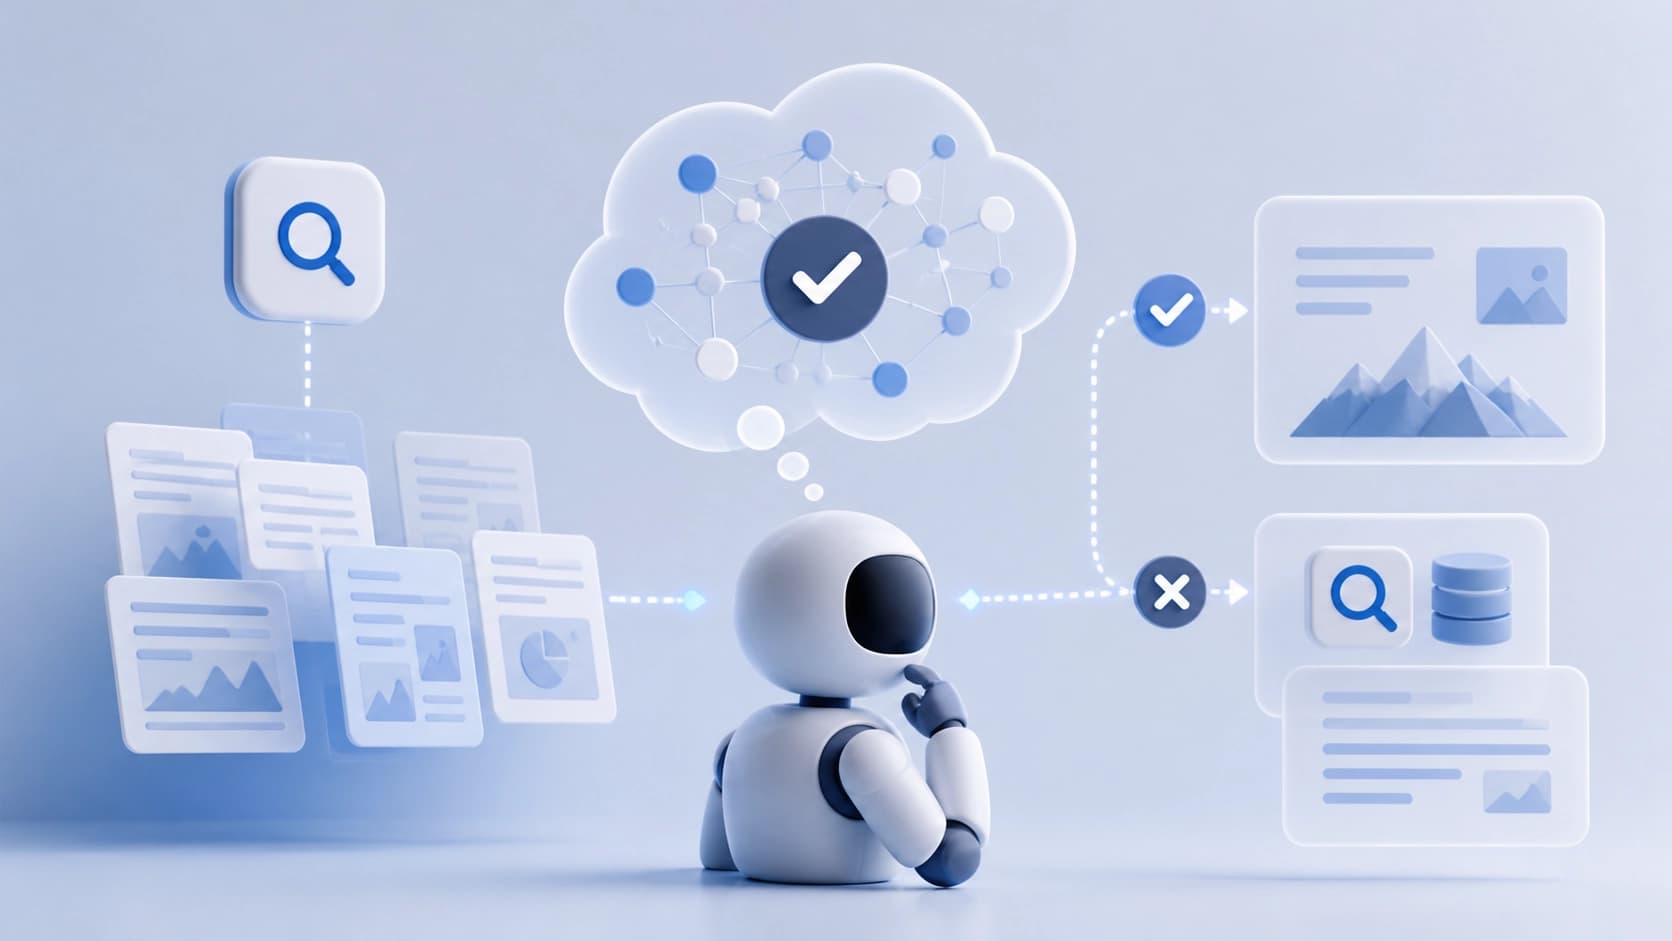
Агентный RAG устроен как цикл: модель читает вопрос, решает, нужен ли ещё один запрос к поиску, получает результаты и снова выбирает — искать дальше или уже отвечать. Каждая лишняя итерация стоит денег и времени, каждая пропущенная грозит неполным ответом. Получается, что главный навык агента — не извлечение документов, а умение вовремя сказать «доказательств достаточно».
Классическое обучение с подкреплением оценивает такое поведение снаружи: ответ совпал с эталоном — плюс, не совпал — минус. Про то, что сама модель думает о полноте собранной фактуры, никто не спрашивает. Отсюда две симметричные болезни: политика либо продолжает копать, когда внутри уже всё ясно, либо обрывает поиск, хотя данных очевидно мало. Внешняя награда эти ситуации не различает — итог один и тот же, а поведение разное.
Сдвиг постановки задачи
Авторы работы MetaRAG предлагают смотреть не только на действие, но и на то, насколько оно совпадает с внутренним убеждением агента о достаточности доказательств. Такую постановку они называют согласованием убеждений и действий — belief-action alignment. Мысль простая: качество решения о поиске — это не отдельная метрика поверх ответа, а согласованность между тем, что модель «думает», и тем, что она делает.
Как устроен MetaRAG
Фреймворк собран из трёх частей: явной проверки перед действием, зонда внутреннего убеждения и специальной награды, которая связывает одно с другим.
Верификация перед действием
Первый компонент — Verify-first Action Generation. Вместо того чтобы сразу выдавать очередной шаг, политика сначала прогоняет его через явную процедуру проверки: подходит ли это действие текущему состоянию поиска. Идея в том, чтобы отсеять импульсивные решения ещё до того, как они попадут в траекторию. По сути это встроенный в генерацию «стоп-кадр», которого обычно не хватает быстрым агентам.
Зонд внутреннего убеждения
Второй компонент — Internal Belief Probing. Из того же контекста, что видит политика (вопрос плюс история действий и наблюдений), отдельно считывается её собственное мнение: отвечаем ли на вопрос уже сейчас. Важно, что это не внешняя модель-судья и не разметка от человека — сигнал берётся у той же политики, просто заданным другим способом.
Награда за согласованность с предохранителем
Из этих двух сигналов выводится consistency reward: агент поощряется, когда его действие совпадает с внутренней оценкой достаточности доказательств. Здесь есть очевидная ловушка — можно начать вознаграждать «уверенно неверное» поведение, если модель стройно и последовательно ошибается. Авторы закрывают её гейтом: награда за согласованность учитывается только тогда, когда ответ оказался корректным. Иначе говоря, согласованность — не самоцель, а множитель к правильности.
Отдельная деталь, важная для практиков: зонд убеждения живёт только на этапе обучения. В инференсе он не вызывается, так что лишних вычислений на каждый запрос не появляется — накладные расходы остаются нулевыми.
Что показали эксперименты
Работа проверена на семи публичных бенчмарках вопросов-ответов. Заявленный результат — устойчивое улучшение компромисса между точностью и эффективностью относительно сильных RL-базовых методов для агентного RAG. То есть выигрыш не в том, чтобы просто отвечать точнее, а в том, чтобы не платить за это бесконечным поиском.
Дальше авторы проверяли, насколько эффект переносится: на сценарии глубокого исследования (deep research), на разные оптимизаторы и на разные базовые модели. Во всех этих конфигурациях метод, по их данным, сохраняет преимущество. Это как раз тот тип проверки, которого часто не хватает: улучшение на одной модели и одном наборе данных легко спутать с удачной настройкой гиперпараметров.
Что это значит на практике
Разработчикам агентных поисковых систем MetaRAG подсказывает направление, которое дешевле, чем кажется. Если у вас уже есть обучение политики, добавление сигнала о внутреннем убеждении не требует новых разметчиков: тот же контекст, который политика и так видит, можно использовать как источник сигнала. Гейт по корректности при этом обязателен — без него агент может обучиться красиво и уверенно ошибаться.
Второй вывод касается проектирования награды в целом. Внешние метрики отвечают на вопрос «получилось ли», но почти ничего не говорят о том, «был ли агент адекватен в моменте». Различение этих двух вещей и есть основная мысль статьи: согласованность между убеждением и действием — самостоятельный, отдельно оптимизируемый объект, а не побочный эффект от роста точности.
Впрочем, стоит держать в голове границы: эксперименты ограничены бенчмарками QA и сценариями глубокого исследования, а сам подход надстроен над RL-обучением, то есть не применим «из коробки» к системам, где политика не тренируется вообще. Для таких случаев полезнее сама идея — явно проверять действие перед выполнением и отдельно оценивать, совпадает ли решение с внутренним ощущением достаточности данных.
Полный текст доступен как arXiv:2608.24214 (v1, 25 августа 2026, раздел cs.AI) — работа принята на основную программу конференции EMNLP 2026.