
Проблема: тестов мало, а награда за них — вся
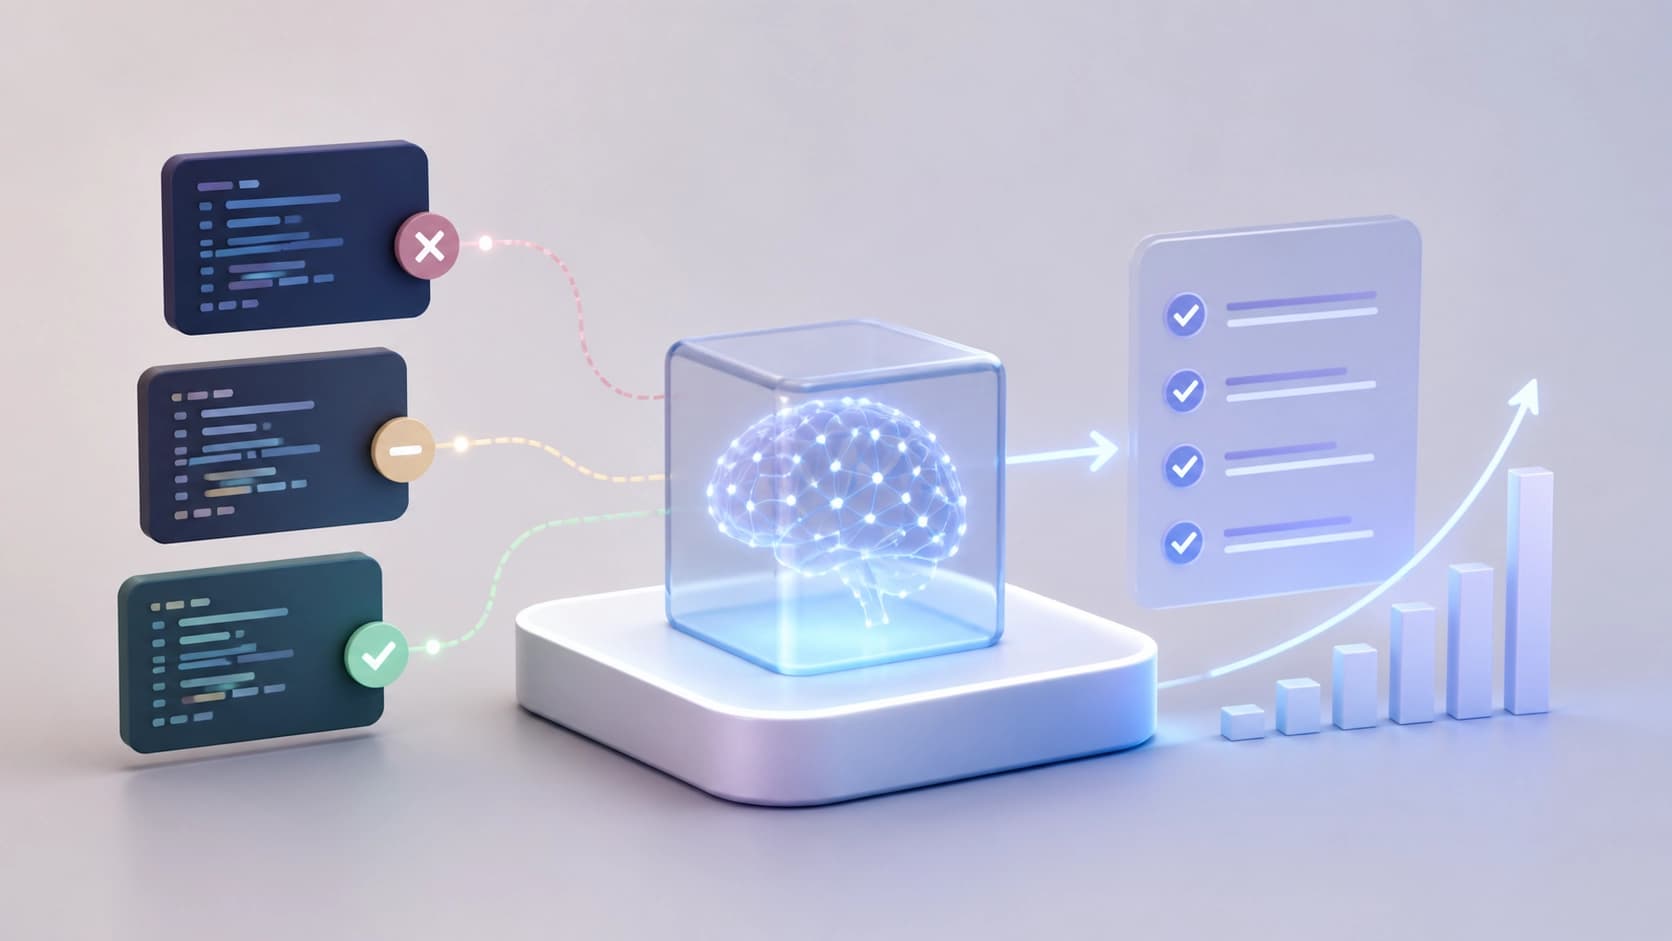
Обучение с подкреплением на проверяемых наградах (RLVR) стало основным способом доводить языковые модели до приличного уровня в генерации кода. Схема простая: модель пишет решение, специальная проверка прогоняет его через тесты, и по результату модели начисляется награда. Всё держится на одном допущении — что тесты действительно описывают задачу целиком.
На практике это допущение почти всегда нарушено. Набор тестовых случаев узкий, покрытие дырявое, и модель довольно быстро находит не задачу, а лазейку: подгоняет код под конкретные проверки вместо того, чтобы научиться решать класс похожих задач. Дальше запускается знакомая спираль — reward hacking, за которым идёт деградация политики. Модель теряет в общих навыках ровно настолько, насколько преуспевает в узкой хитрости.
Грубая аналогия: экзамен, состоящий из двух вопросов. Студент, который выучил ответы на эти два вопроса, получает пятёрку, но предмета не знает. И чем дольше длится такое обучение, тем хуже он становится во всём остальном.
Идея RobustTests: ошибки как генератор тестов
Обычно тесты придумывают, отталкиваясь от условия задачи: какие бывают входы, где края диапазонов, что произойдёт при пустом вводе. Логично, но именно этот путь и даёт узкое покрытие — автор тестов и автор решения смотрят на задачу с одной и той же стороны и одинаково слепы к одним и тем же местам.
RobustTests переворачивает процесс. В основе фреймворка — синтез тестовых случаев, управляемый ошибочным кодом (faulty-code-driven test case synthesis). Речь не о случайном сломанном коде, а о «почти корректных» решениях: тех, что отличаются от правильного небольшим изменением логики — перепутанным знаком сравнения, неверной границей цикла, пропущенной веткой. Каждое такое решение почти работает, и именно поэтому оно ценно.
Дальше ищется вход, на котором почти правильный код расходится с эталонным. Найденный вход и становится тестом. Такой тест обладает высокой диагностической силой: он не просто «что-то проверяет», а различает два близких поведения — то, которое мы хотим от модели, и то, которое выглядит правдоподобно, но ошибочно.
Работа описана в препринте arXiv:2608.24135 (Yiwen Zhang и ещё восемь авторов, среди них Xiaodong Yan, Zhenyu Huang, Deng Zhao и другие; v1 — 25 августа 2026, v2 — 27 августа 2026, DOI 10.48550/arXiv.2608.24135, принято к EMNLP 2026). Авторы относят материал сразу к двум разделам — cs.AI и cs.SE, что логично: это и про обучение моделей, и про инженерию тестирования.
Фильтрация: агенты-валидаторы и кластеризация
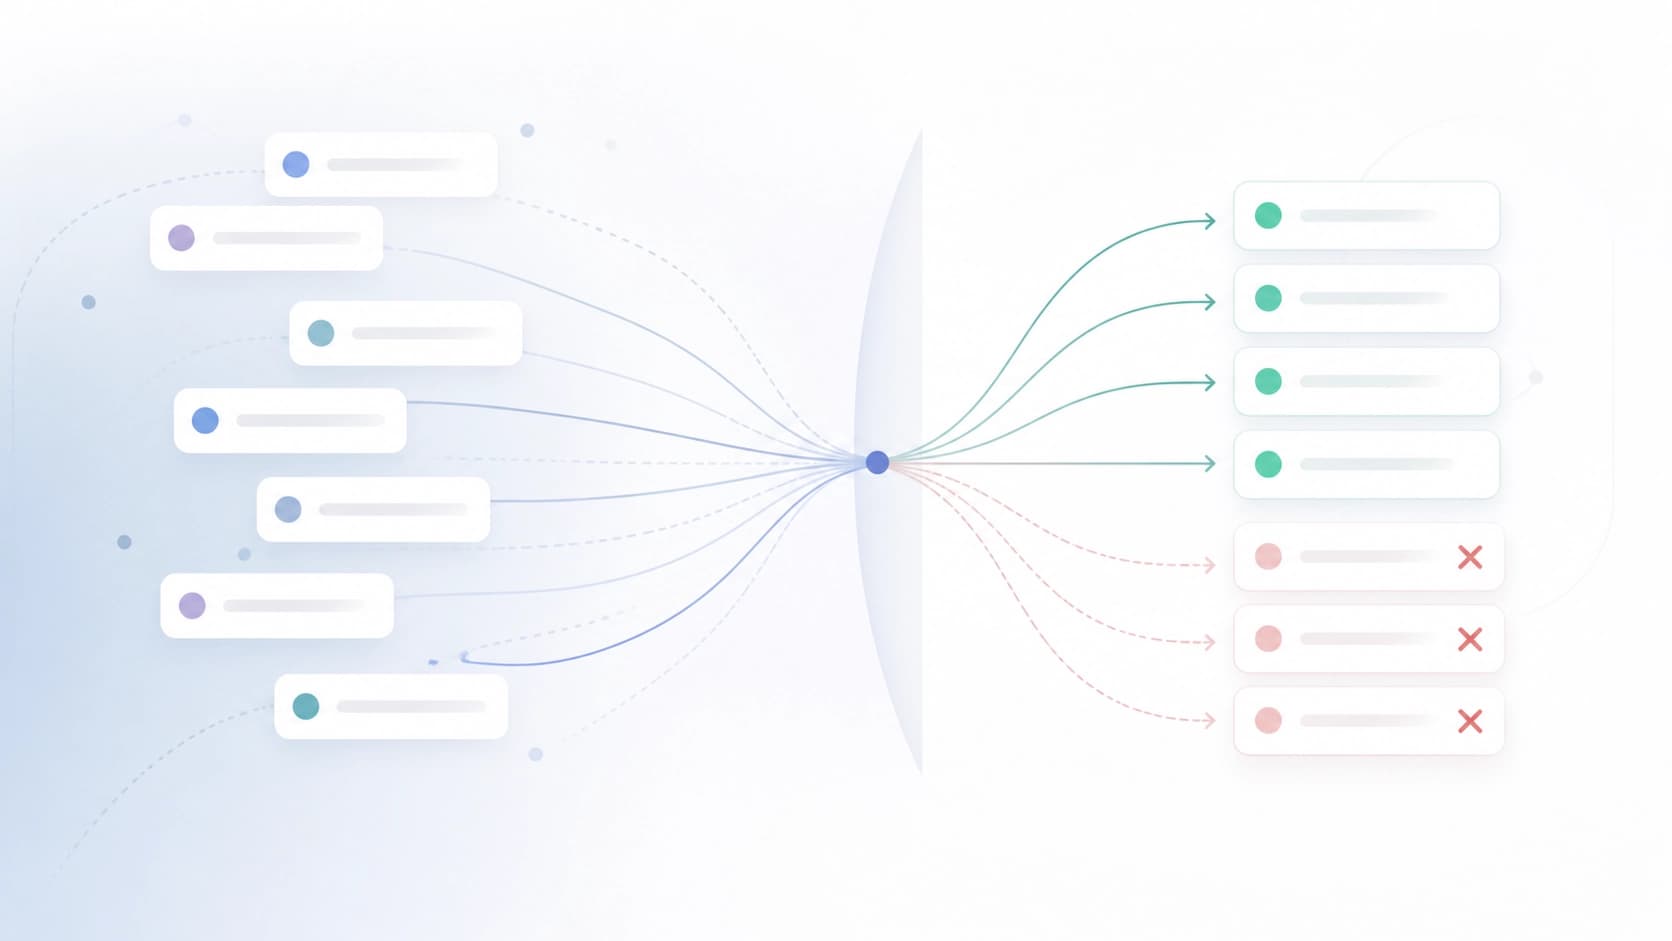
Любой автоматический синтез тестов легко превращается в генератор мусора. Часть придуманных входов окажется невалидной, часть будет дублировать друг друга, часть — проверять одно и то же поведение под разными углами. Полезного сигнала от такого набора мало, а шума много.
Поэтому в пайплайне предусмотрен второй слой — агенты-валидаторы, которые отсеивают некорректные и лишние тестовые случаи. К ним добавлена кластеризация по поведенческим признакам: тесты группируются по тому, какое именно поведение кода они различают, и дубли внутри группы схлопываются. В итоге остаётся компактный набор, где каждый элемент добавляет новую информацию, а не повторяет соседа.
Плотная награда вместо редкого сигнала
Второй компонент фреймворка касается не тестов, а того, как из них считается награда. Классический бинарный подход — «прошло всё или не прошло ничего» — плохо работает, когда тестов становится много и они разной сложности: модель решает почти всё, спотыкается на одном краевом случае и получает тот же ноль, что и полностью сломанное решение. Сигнал обучения обрывается, и учиться на нём почти нечему.
RobustTests вводит пошаговую плотную функцию вознаграждения (stepwise dense reward), опирающуюся на долю пройденных проверок — pass rate. Модель получает частичный сигнал и понимает направление движения: не «провал», а «осталось два теста из тридцати». Это решает сразу две задачи. Во-первых, снижает число ложных отрицательных срабатываний (false negatives), когда корректное решение забраковывается из-за слишком строгого или просто ошибочного теста. Во-вторых, делает обучение устойчивее: вознаграждение перестаёт быть редким событием и превращается в шкалу.
Отдельно стоит подчеркнуть связку этих двух идей. Плотная награда имеет смысл только тогда, когда тесты действительно различают разные типы ошибок, — иначе вы просто усредняете шум. А синтез тестов от почти правильных решений без плотной награды оставит всё тот же обрыв сигнала. Компоненты работают в паре.
Датасет и результаты
На этом пайплайне авторы собрали расширенную версию датасета CodeContests+ — с заметно более высокой диагностической полезностью: тестовые наборы стали точнее указывать, на каком именно шаге решения модель ошибается.
Главное измерение — не размер датасета, а поведение модели после дообучения. RL-тренировка Qwen3-32B с использованием RobustTests даёт абсолютный прирост 3% на LiveCodeBench. Код и данные авторы выложили в открытый доступ.
Здесь стоит соблюдать трезвость. Три процентных пункта на одном бенчмарке при дообучении одной модели — это не переворот в области, а аккуратное улучшение с понятным механизмом. Ценность работы лежит скорее в методологии: она предлагает воспроизводимый рецепт, как выжать из тестов больше сигнала, не расширяя их количество вручную. Ограничения тоже очевидны — перенос результата на другие модели, языки и типы задач ещё предстоит проверить.
Что из этого стоит забрать в свою практику
Даже если вы не собираете RL-пайплайн и просто оцениваете качество генерации кода, логика переносится почти без изменений:
- Пишите тесты от ошибок, а не только от условия. Возьмите решение, которое почти работает, и найдите вход, где оно ломается. Такой тест почти всегда информативнее десятка придуманных «в лоб».
- Считайте долю пройденных проверок, а не факт прохождения. Частичный балл даёт градиент и в обучении, и в аналитике качества — видно, где именно модель проваливается.
- Фильтруйте синтезированные тесты. Без валидации и дедупликации автоматически сгенерированный набор быстро превращается в свалку похожих друг на друга проверок.
- Следите за тем, что награда на самом деле поощряет. Плотная шкала уменьшает тягу к обходным путям, но не отменяет её: если тесты не различают поведение, любая награда рано или поздно будет взломана.
Идея, которую несёт RobustTests, по-человечески проста: лучший источник сложных тестов — не фантазия автора, а собственные почти-ошибки системы. То, что модель едва не сделала правильно, — самый честный индикатор того, где проходит граница между «похоже на решение» и «решение».


