
Сырые данные вместо готовых таблиц
Модели всё чаще выступают в роли кодовых агентов: им поручают писать скрипты для обработки данных, строить графики, считать метрики, разбирать инженерные выгрузки. Но есть класс задач, который до сих пор почти не проверяли — работа с «сырьём» физического уровня. Именно эту нишу закрывает бенчмарк EMRB (Electromagnetic Reasoning Benchmark), описанный в препринте arXiv:2608.24086 (разделы cs.AI, cs.CE, cs.SE).
Ключевая идея проста и потому убедительна. На входе — только сырые I/Q-записи, то есть квадратурные отсчёты сигнала, как они приходят с приёмника. Никаких предобработанных признаков, спектрограмм с подписями и уж тем более таблиц с готовыми значениями. Величину, к которой относится вопрос, модель должна сначала обнаружить в данных — через код, который сама напишет и запустит.
Чем это отличается от привычных замеров
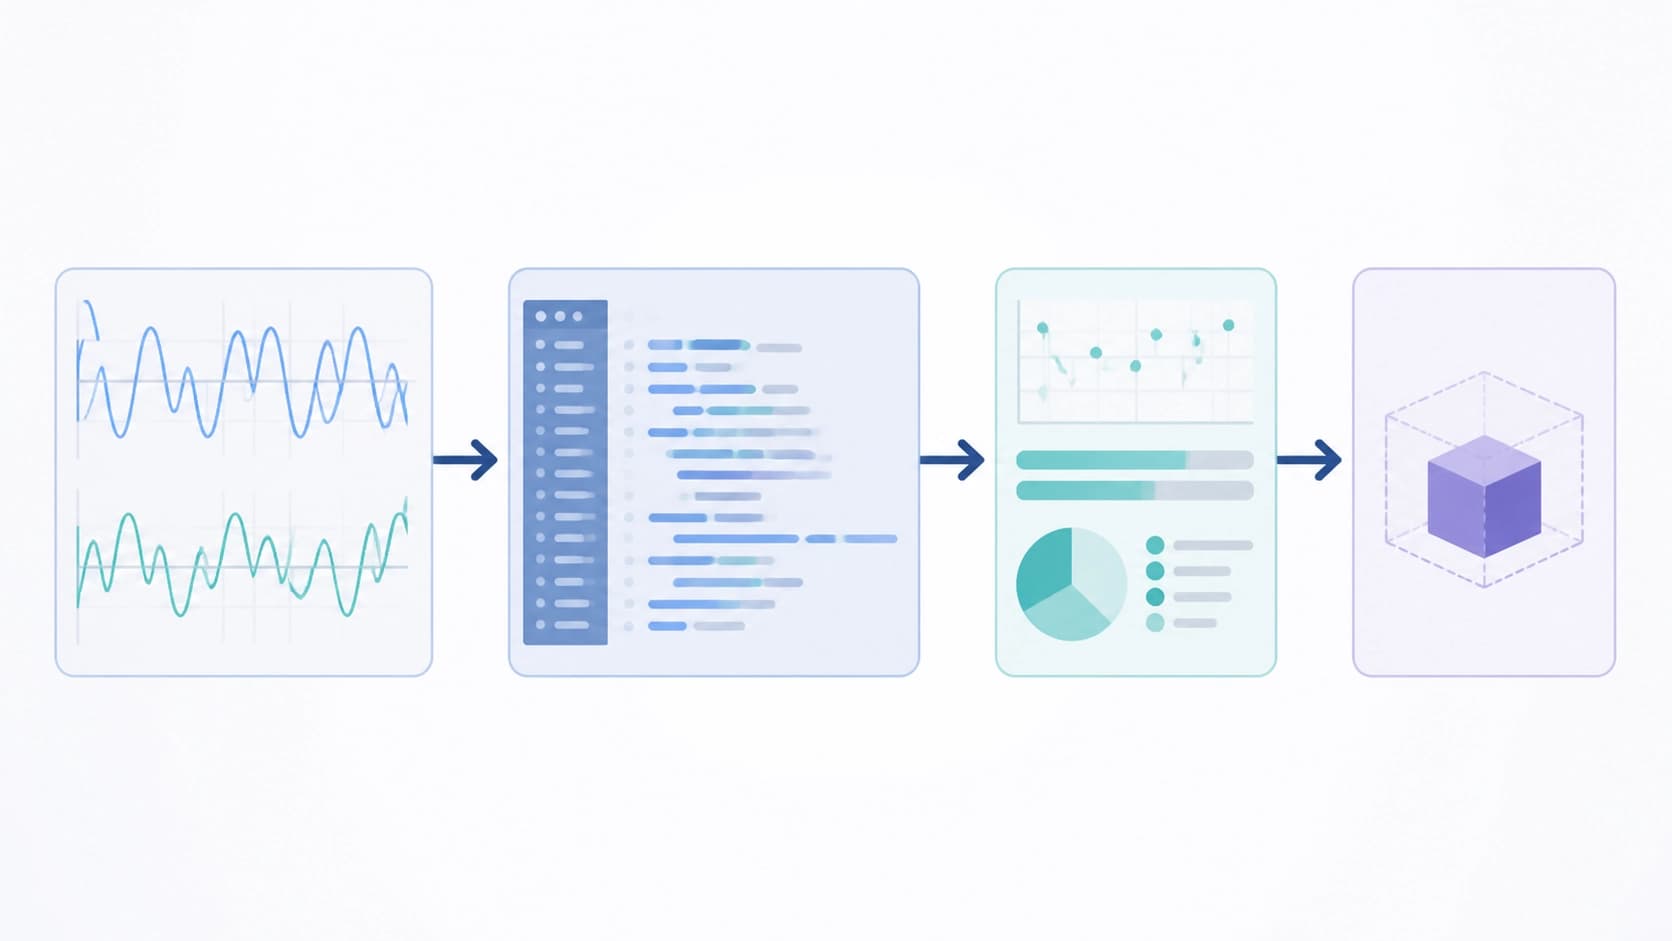
За последние годы появилось немало наборов задач, где модели предлагают рассуждать о радиосигналах. Но чаще всего там уже выполнена работа за модель: из записи извлекли признаки, посчитали спектр, оценили уровень шума, свели всё в структурированную таблицу. В такой постановке остаётся арифметика и сопоставление чисел — навыки полезные, но не имеющие отношения к радиофизике.
Разница принципиальна. Когда величины заданы заранее, ошибка модели на раннем шаге не видна: неверная оценка полосы или частоты просто не возникает, потому что эти значения дали в условии. Когда данных необработанных — любая ошибка на этапе разведки сигнала тянет за собой весь дальнейший расчёт. Поэтому EMRB проверяет не знание терминов, а способность выстроить цепочку: посмотреть на отсчёты, понять, что там за сигнал, выделить нужную характеристику, посчитать её корректно и не потерять размерности.
Как устроен бенчмарк
Авторы — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang и Shan Huang — собрали 200 задач. Задачи разложены по пяти уровням сложности и 27 типам вопросов: от банального обнаружения сигнала до проектирования OFDM-системы. Источник материала — 11 типов сигналов, для каждого подготовлена проверенная эталонная истина.
Пять уровней
Уровни выстроены по нарастанию самостоятельности модели. Внизу — измерения базовых параметров: найти сигнал, оценить его характеристики. Выше — интерпретация и сравнение, затем анализ с несколькими шагами, потом диагностика и, наконец, системное проектирование, где от модели требуется не измерить, а спроектировать решение под заданные требования.
27 типов вопросов и 11 типов сигналов
Такой разброс нужен, чтобы результат не зависел от одной удачной или неудачной формулировки. Разные типы сигналов дают разные ловушки: где-то мешает шум, где-то — перекрытие по спектру, где-то нужно аккуратно обойтись с дискретизацией. Число типов вопросов и сигналов вместе формирует пространство, в котором сложно случайно угадать.
Открытые данные
Все материалы и код выложены в публичном GitHub-репозитории, так что результат можно перепроверить независимо. Для бенчмарка это важнее обычного: если задачи сгенерированы, а не собраны вручную из полевых записей, вопрос корректности эталонов становится центральным — и открытость здесь единственный работающий ответ.
Что показали модели
Проверили 14 языковых моделей: проприетарные, открытые по весам и отдельно модели, нацеленные на рассуждения. Итоговый разброс — от 24.1% до 78.9%. Уже сам по себе диапазон говорит о многом: разница между лучшей и худшей моделью здесь измеряется не процентами, а разами.
Но интереснее другое. Средний результат резко проседает по мере усложнения уровня: с 84.9% на базовых измерениях до 21.2% на системном проектировании. То есть модели неплохо справляются, когда нужно посчитать измеримую величину, и почти разваливаются, когда требуется собрать из этих величин работающее решение.
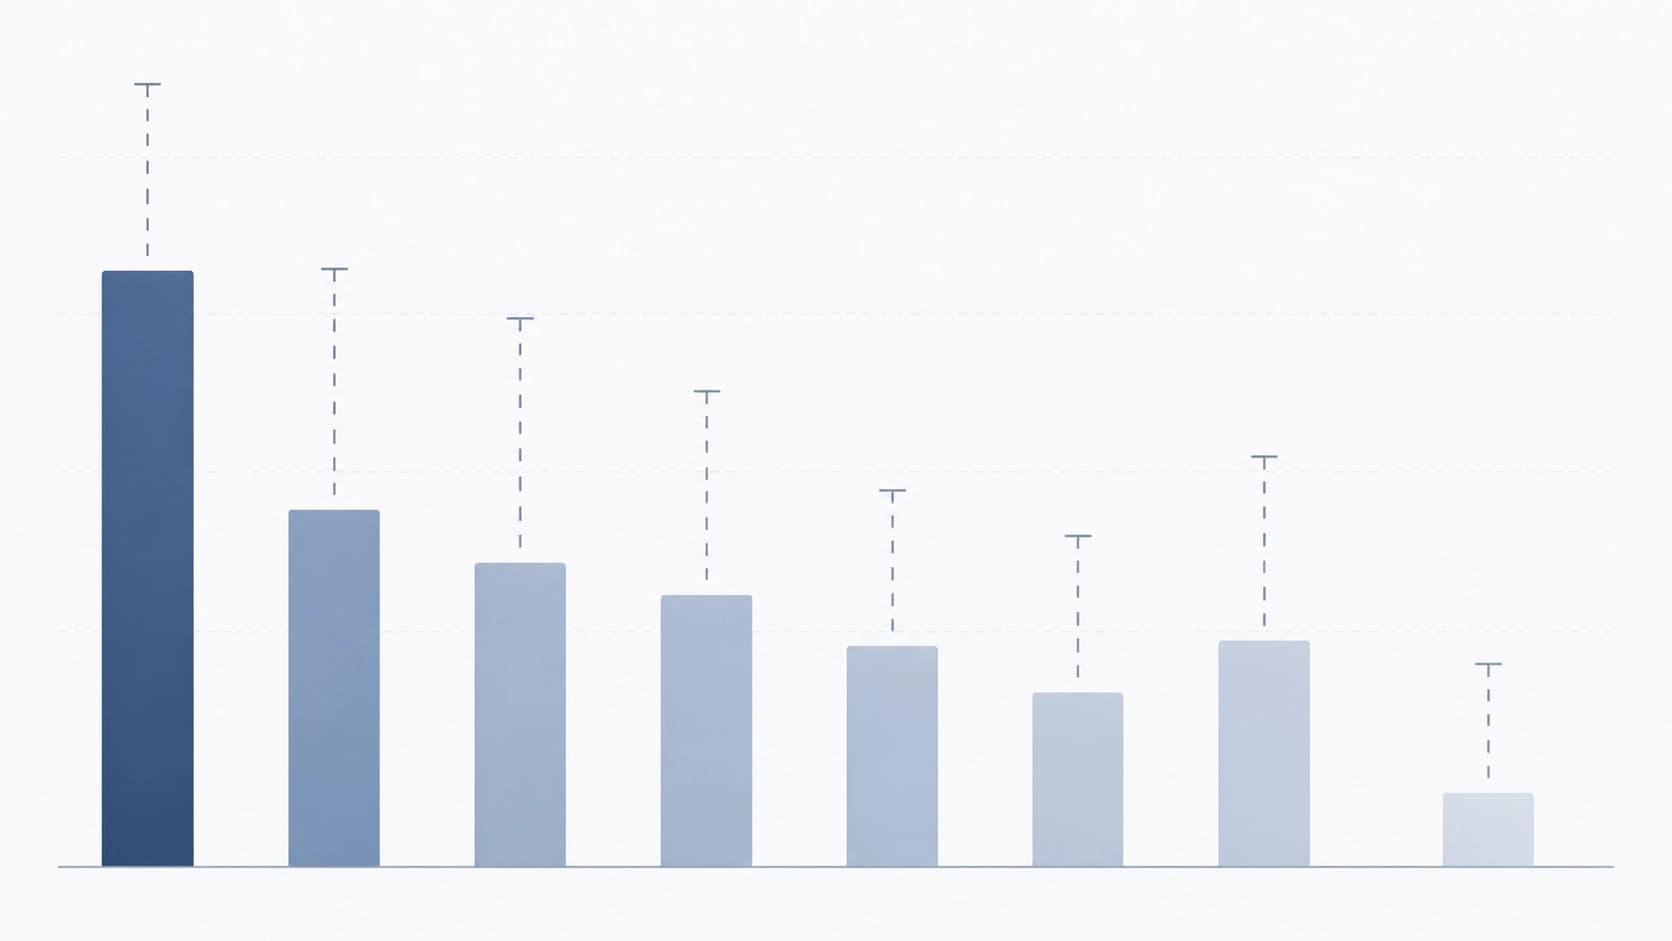
Читать это стоит как диагноз, а не как рейтинг. Сильная сторона нынешних моделей — исполнение кода и арифметика поверх известной постановки. Слабая — перевод инженерной задачи на язык измеримых шагов: понять, какие величины вообще нужны, в каком порядке их искать, как проверить, что найденное вообще похоже на правду. Именно этот разрыв и делает бенчмарк полезным.
ReconPilot: разведка, анализ, проверка
Авторы не ограничились измерением. Они предложили ReconPilot — структурированный подход, в котором работа разбита на три этапа: разведка сигнала, целевой анализ и самопроверка. Сначала модель изучает запись и составляет представление о том, с чем имеет дело. Потом решает конкретную задачу. Затем возвращается к своему результату и проверяет его на согласованность.
На трёх базовых моделях метод добавляет к общему баллу от 3.8 до 17.6 пункта. Улучшение достигнуто в 13 из 15 протестированных комбинаций «бэкбон + уровень». Обратите внимание на формулировку: выигрыш неодинаков, и в двух случаях его нет вовсе. Это нормальный признак честного эксперимента — универсальной таблетки не нашлось, но тенденция устойчивая.
Показательно, что помогает именно явное разделение фаз. Модель, которую просто просят «проанализировать сигнал», склонна перескакивать к вычислениям, не убедившись, что она поняла данные. Разведка как отдельный обязательный шаг заставляет сначала посмотреть, а потом считать.
Что из этого следует
Для инженерной практики вывод довольно прямой: прежде чем доверять агенту расчёты по реальным измерениям, стоит проверить его на данных без подсказок. Удобный интерфейс и гладкий ответ в чате ничего не говорят о том, переживёт ли модель встречу с неподготовленной выгрузкой с приёмника.
Есть и более общая мысль, выходящая за пределы радио. В любой области, где рассуждение опирается на сырые измерения — гидроакустика, вибрации, телеметрия, — агент должен уметь сначала найти в данных величину, а потом с ней работать. Таблицы с признаками эту часть работы скрывают, и вместе с ней скрываются ошибки.
Ограничения и что дальше
Полностью закрытым вопрос не назвать. 200 задач — объём приличный, но не безграничный, а генерация на основе 11 типов сигналов означает, что реальные полевые записи со всеми их артефактами там всё же не представлены. Оценка 14 моделей — срез момента, а не приговор: состав лидеров в этой области меняется быстро.
Тем не менее формулировка задачи выглядит правильной. Если мы хотим, чтобы LLM работали не с пересказом данных, а с самими данными, проверять их нужно ровно там, где заканчиваются подсказки. EMRB делает именно это — и показывает, что запас для роста у моделей в разведке сигнала ещё очень велик.


