
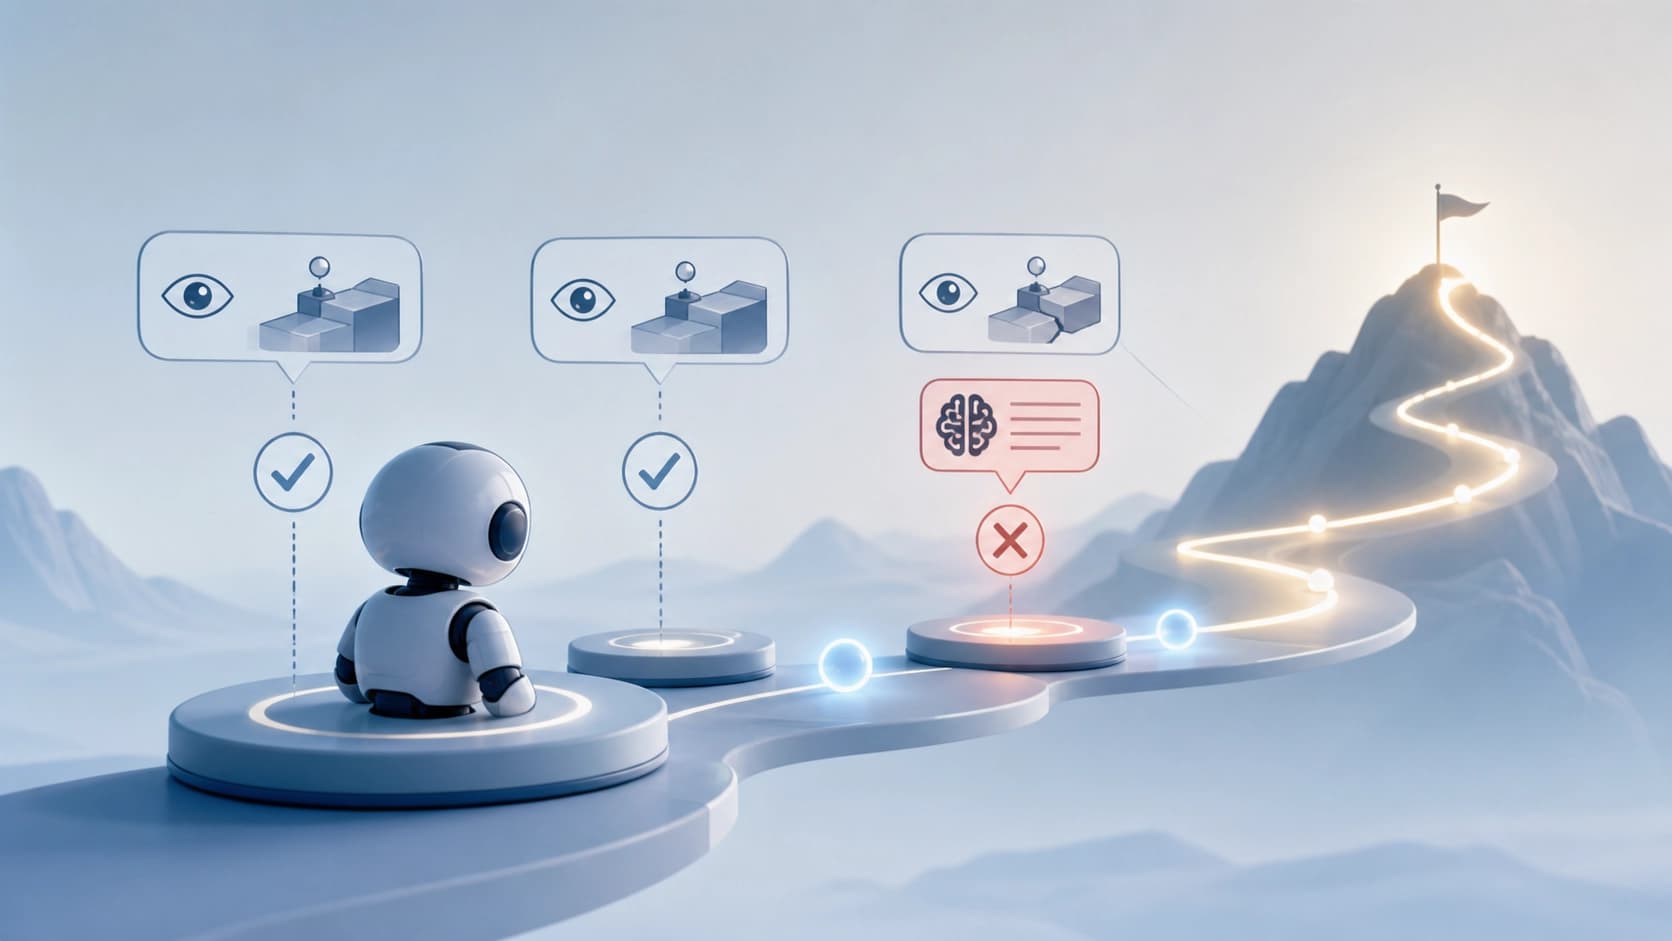
Проблема: награда одна на всю траекторию
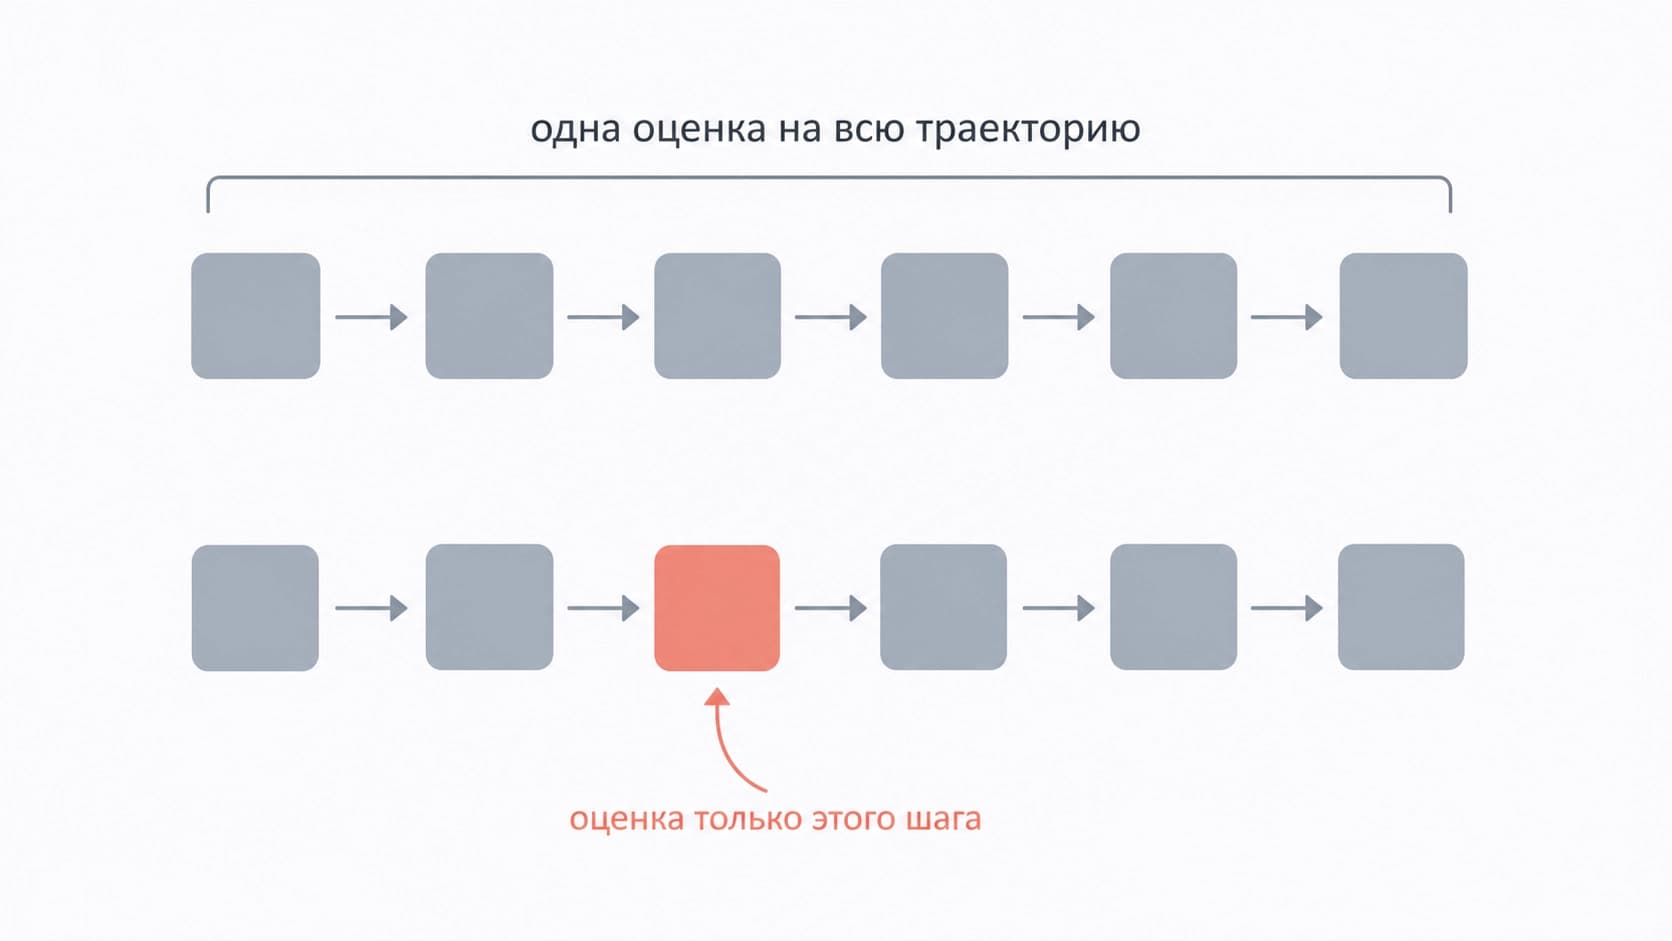
Многоходовые агенты на базе LLM учатся методом проб: выполняют цепочку действий, получают итоговую оценку и по ней корректируют поведение. Беда в том, что эта оценка обычно приходит на всю траекторию целиком. Агент узнаёт, что задача решена или провалена, но не узнаёт, на каком именно шаге всё пошло не так.
Дальше начинается арифметика, которая плохо сочетается со здравым смыслом. Одинаковое преимущество размазывается по всем шагам подряд — и по удачному выбору инструмента, и по случайной опечатке в запросе, и по рутинному «подтвердить действие». В итоге модель одновременно поощряет и случайные промахи, и нормальные рабочие шаги, если финал оказался успешным. Кредит за успех достаётся всем поровну, а вина за провал — тоже всем.
Классическое лечение — само-дистилляция с привилегированной информацией. Учитель знает больше ученика: у него есть доступ к среде, к промежуточным сигналам, к правильному ответу. Он может подсказывать на каждом шаге, а не только в конце. Звучит хорошо, но у такого подхода есть скрытая небрежность: одна и та же подсказка выдаётся всем шагам без разбора.
Асимметрия шагов: рутине и ошибкам нужно разное
Ключевая мысль работы AHEAD в том, что шаги в траектории неравноценны, и супервизия для них тоже должна быть разной.
- Рутинные шаги — открыть страницу, подтвердить переход, вызвать нужный инструмент — почти не нуждаются в подсказках. Модель и так справляется. Лишнее руководство здесь только зашумляет обучение и тратит бюджет.
- Критические шаги с ошибкой — там, где агент свернул не туда и потерял шанс на успех, — требуют не просто констатации «тут плохо», а конкретного направления: что надо было сделать вместо этого.
- Обратная связь от среды хорошо заземляет происходящее: она говорит, что реально произошло. Но она не умеет объяснять, как надо было поступить. Сигнал «дверь не открылась» не подсказывает, где лежал ключ.
Получается, что два источника супервизии дополняют друг друга, но не заменяют. Фидбэк среды даёт плотный и честный сигнал на каждом шаге; сгенерированные моделью корректирующие подсказки дают то, чего в фидбэке среды принципиально нет — намерение и альтернативу. Смешивать их вслепую по всей траектории — значит терять сильные стороны обоих.
Как устроен AHEAD
Авторы — Xiaolong Jin, Dingmin Wang, Vijay Lingam и Varun Kumar — предлагают фреймворк, который осознаёт тип шага и подбирает под него источник супервизии. Работа выложена в arXiv в конце августа 2026 года, рубрика cs.AI; объём — 22 страницы, 15 рисунков и 7 таблиц, то есть материала на детали хватает.
Учитель, который видит среду
Учительская модель получает обратную связь среды на всех шагах — это заземлённый и плотный сигнал, одинаково доступный и на успешных, и на провальных участках. Такой учитель не фантазирует: он опирается на то, что действительно произошло в среде.
Корректирующие подсказки — точечно
Поверх этого учитель получает сгенерированные LLM подсказки, но не на всех шагах, а именно на ошибочных. Логика простая: там, где агент ошибся, одного факта из среды недостаточно, нужно объяснение, куда стоило двигаться. Там, где всё идёт гладко, дополнительное руководство не добавляется вовсе.
Это и есть «точечная подсказка» из названия: не размазанная по траектории, а сфокусированная на проблемных точках. Шаг-осознанное сопоставление источников супервизии вместо единого сигнала для всей цепочки действий.
Минимальные правки к GRPO
Отдельно стоит отметить инженерную скромность метода. GRPO — популярный алгоритм обучения с подкреплением — не переписывается с нуля: изменения вносятся точечно, поверх стандартной схемы. Для практиков это важно, потому что не требует пересобирать весь пайплайн обучения агента.
Что показали эксперименты
Оценка шла на трёх типах задач: ALFWorld — многошаговые сценарии в текстовой среде, WebShop — взаимодействие с интернет-магазином, и поисковый вопрос-ответ. Тестировались три масштаба моделей, так что выводы не привязаны к одному размеру.
Результаты по сравнению с обычным GRPO:
- +13,3 пункта успешности на ALFWorld при модели на 7B;
- +11,0 пункта на WebShop при том же масштабе.
Помимо абсолютных цифр, есть два не менее интересных эффекта. Во-первых, заданный уровень успешности достигается за меньшее число шагов обучения — то есть метод не только лучше в пределе, но и быстрее выходит на рабочую кондицию. Во-вторых, агент решает задачи в более узких бюджетах взаимодействия, чем подходы на основе только итоговой награды и предыдущие методы само-дистилляции.
Второй пункт, на мой взгляд, недооценён. Экономия шагов взаимодействия — это не только метрика красоты. В реальных сценариях каждый вызов инструмента стоит денег, времени и риска. Агент, который приходит к цели за пять действий вместо десяти, полезнее не на 13 процентов, а в разы — особенно там, где цена ошибки высока.
Почему это работает и что остаётся за кадром
Объяснение у метода почти педагогическое. Хороший учитель не комментирует каждое движение ученика — он молчит, пока тот делает разумные вещи, и вмешивается ровно там, где ученик сбился с пути. Если комментировать всё подряд, ученик перестаёт думать сам и начинает ждать подсказки. Если не комментировать ничего, он будет повторять одни и те же ошибки.
AHEAD формализует эту интуицию в терминах обучения с подкреплением: разный тип шага — разный источник сигнала. Плотный заземлённый фидбэк — как фон, корректирующее направление — как акцент. Никакой магии, просто отказ от идеи, что все шаги равны.
Что остаётся вопросами. Генерация корректирующих подсказок сама по себе требует модели, а значит, добавляет вычислительные затраты и зависит от её качества — если учитель объясняет неверно, ученик получит уверенное, но неправильное направление. Остаётся открытым и то, насколько метод переносится на задачи, где цена промежуточного шага не так очевидна, как в ALFWorld или WebShop, и где «ошибочность» шага не всегда можно определить сразу, а только по отложенным последствиям.
Тем не менее направление выглядит здоровым. Основная линия развития агентных методов последних лет — не увеличивать модель, а умнее распоряжаться сигналом обучения. AHEAD — ровно из этой линии: точечное вмешательство вместо тотального контроля.


