
Почему голосование по уверенности вообще работало
Идея, знакомая каждому, кто строил пайплайны вокруг больших языковых моделей, проста: запустить одну и ту же задачу несколько раз параллельно, а потом выбрать ответ большинством. Но не «плоским» большинством, а взвешенным — каждый прогон получает вес по внутренним сигналам модели, чаще всего по лог-вероятностям токенов. Тот вариант, в котором модель была увереннее, звучит громче остальных.
Для одношаговых рассуждений такая схема неплохо себя показывает: если модель ошибается, она обычно колеблется, а верный ответ сопровождается высокой уверенностью. Разрыв в лог-вероятностях становится чем-то вроде встроенного детектора ошибок, не требующим ни дополнительных вызовов, ни разметки, ни отдельной модели-судьи.
Ломается там же, где началось: на многошаговом поиске
Проблема в том, что современные агенты устроены иначе. Они не просто рассуждают в один проход: они формулируют запросы, получают внешние документы, встраивают их в контекст, уточняют запрос и так несколько раз, пока не соберут достаточно материала для финального ответа. Каждый шаг добавляет в окно модели куски чужого текста.
Авторы работы «Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding» (arXiv:2608.24024, принята в Findings конференции EMNLP 2026) — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng и Beidi Chen — проверили, что происходит с голосованием по уверенности в этом сценарии. Результат неприятный: приём, отлаженный на одношаговых задачах, переносится на поисковых агентов плохо.
Механизм отказа: copy inflation
Причину исследователи назвали copy inflation — «копировательное раздувание». Когда извлечённые документы попадают в контекст, токены, которые модель переносит из этих документов в свой ответ, получают систематически завышенные лог-вероятности. Копирование — лёгкая операция: продолжать текст, который лежит прямо перед глазами, статистически проще, чем генерировать что-то своё. Модель «уверена» в таком токене не потому, что он верен, а потому, что он буквально списан.
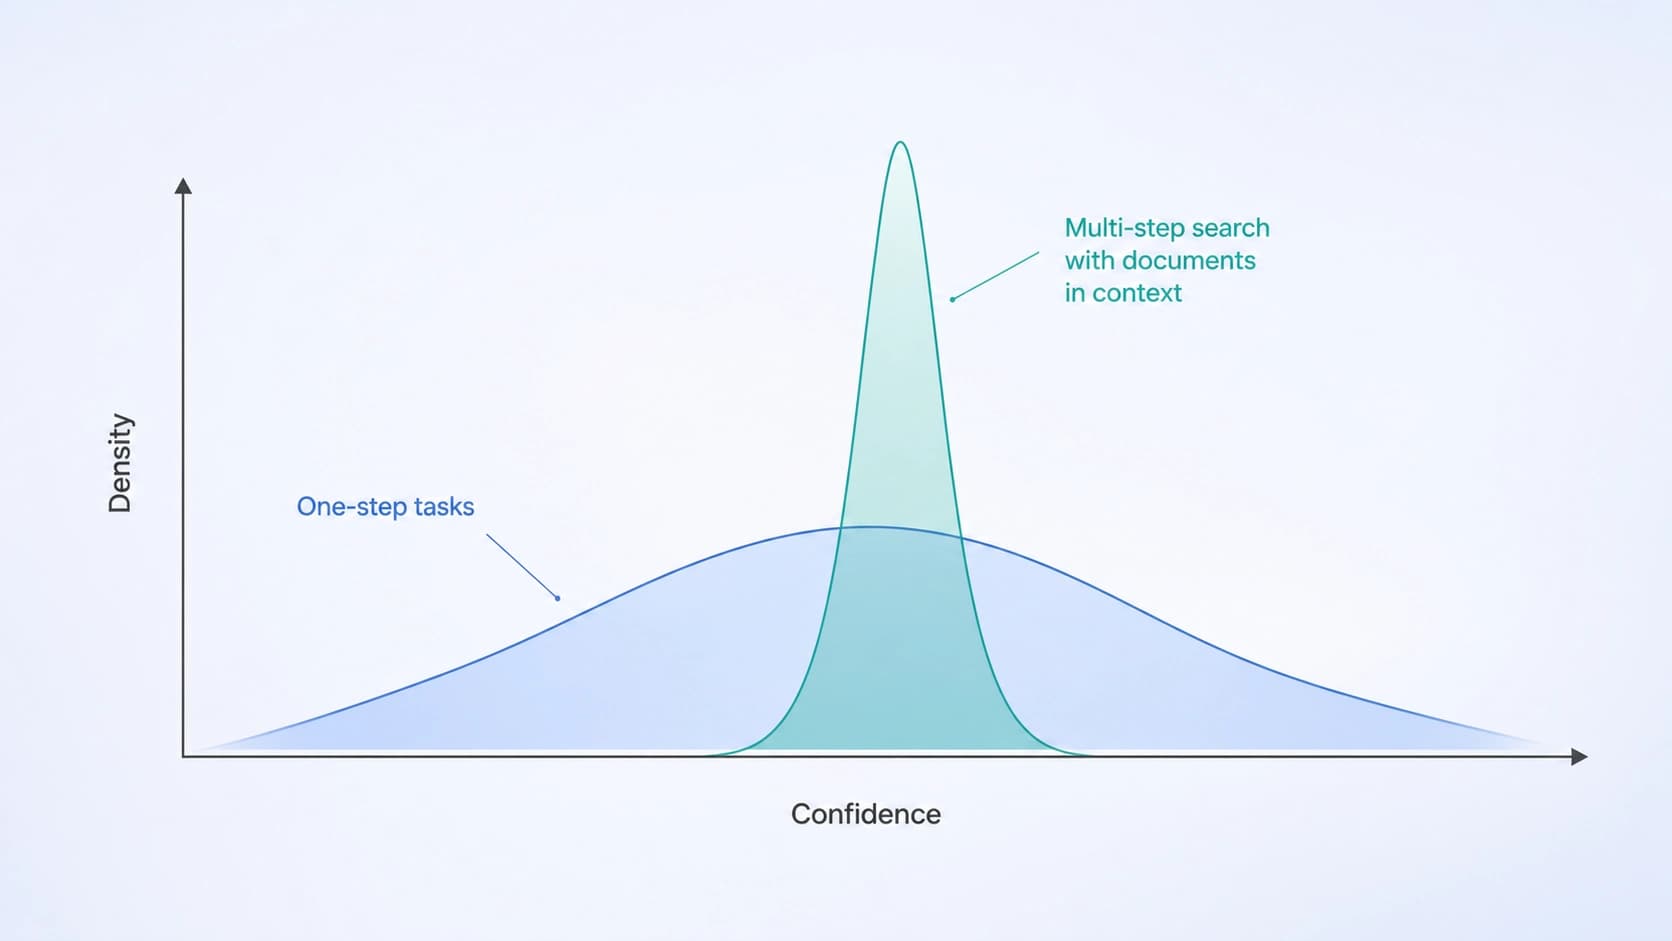
Дальше эффект накапливается. Поскольку все прогоны так или иначе опираются на найденные документы, все они получают свою порцию раздутых вероятностей. Оценки уверенности внутри одного вопроса выравниваются, сжимаются в узкий диапазон — и взвешенное голосование теряет главное, ради чего существовало: способность отличить сильный прогон от слабого. Веса становятся почти одинаковыми, и агрегация вырождается в обычное большинство, только с лишней вычислительной нагрузкой.
Что предлагают: Retrieval-Grounded Voting
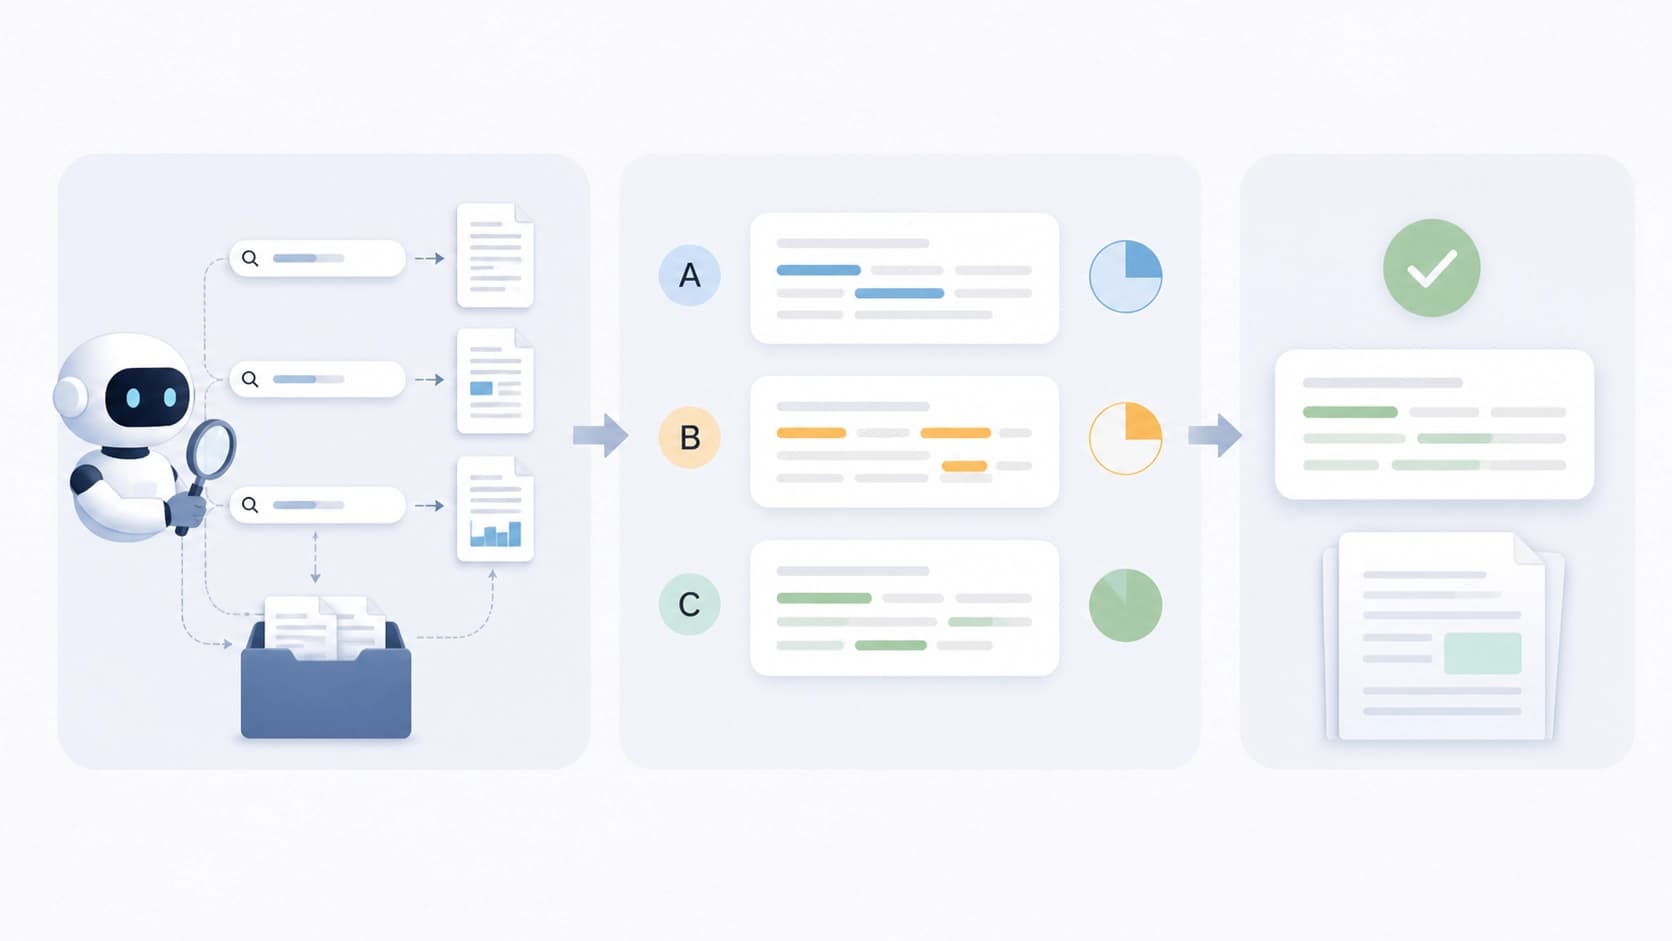
В качестве замены авторы предлагают метод Retrieval-Grounded Voting (RGV). Он тоже оценивает каждый прогон по отдельности, но смотрит не внутрь модели, а наружу — на связь финального ответа с теми документами, которые этот прогон сам же и достал.
Метрика намеренно простая: лексическое пересечение между текстом ответа и текстом извлечённых источников. Чем сильнее ответ опирается на найденный материал, тем выше его счёт. Прогон, который что-то придумал от себя или уехал в сторону, делит со своими документами меньше слов и получает меньший вес.
Почему сигнал работает
Логика здесь такая: если агент действительно нашёл релевантные страницы и построил вывод на них, формулировки ответа неизбежно пересекутся с формулировками источников — терминами, названиями, оборотами. Это не идеальный признак корректности, но он устойчив там, где лог-вероятности уже испорчены.
Ключевое достоинство RGV — он считает сигнал вне загрязнённого контекста. Оценка строится на паре «ответ — документы», а не на состоянии модели в момент генерации, поэтому copy inflation на неё не влияет. Заодно метод обходится без доступа к лог-вероятностям токенов и без дополнительных обращений к LLM: никакой модели-судьи, никакого второго прохода, только подсчёт пересечений — операция, которую можно сделать обычным кодом почти бесплатно.
Результаты
Эксперименты ставились на четырёх бенчмарках для поисковых агентов и пяти разных языковых моделях. Картина повторяется: RGV стабильно опережает голосование по уверенности.
Самый показательный замер — на «minority-correct» вопросах, где правильный ответ появляется лишь в одном-двух прогонах из восьми. Именно здесь взвешивание по уверенности проваливается сильнее всего: раздутые вероятности тянут голосование к массовой, но неверной версии. Прирост от RGV на таких вопросах достигает +35%, а по точности в целом — до +5.4%.
Цифры стоит читать с оговоркой: это не «плюс пять процентов к качеству любой поисковой системы», а улучшение процедуры агрегации при фиксированных модели и наборе прогонов. То есть метод ничего не меняет в самом агенте — он лишь аккуратнее выбирает из того, что агент уже сгенерировал.
Что это значит на практике
Если вы собираете многошагового агента и уже используете self-consistency или любое голосование по вероятностям, у RGV есть три практических плюса:
- Ничего не стоит по инференсу. Дополнительные вызовы модели не нужны, вес считается постфактум по уже готовым ответам и документам.
- Работает с закрытыми моделями. Лог-вероятности токенов доступны далеко не всегда, а иногда и вовсе скрыты за API. Сравнение текстов от этого ограничения свободно.
- Предсказуемо отлаживается. Метрика прозрачная: можно посмотреть, какие слова дали совпадение, и понять, почему прогон получил такой вес.
Где метод может споткнуться
Слабое место очевидно из самой конструкции: лексическое пересечение награждает совпадение слов, а не совпадение смысла. Перефразированный, но верный ответ получит несправедливо низкий вес; числовой результат или короткая выжимка тоже почти не пересекутся с исходным текстом, даже если полностью ему соответствуют. Обратная ситуация ещё неприятнее: прогон, который просто длинно цитирует найденное, наберёт высокий счёт, ничего не добавив к решению.
Отсюда и разумная стратегия — воспринимать RGV не как замену всем сигналам, а как дополнительный голос, который особенно полезен именно там, где уверенность модели перестаёт что-либо значить. Логично и комбинировать его с проверками других типов: сравнением смыслов, оценкой отдельной моделью, верификацией по фактам. Авторы, судя по формулировке задачи, двигались ровно в эту сторону — от «доверять внутреннему ощущению модели» к «оценивать то, что она реально сделала».
Итог
История с copy inflation — хорошая иллюстрация общей проблемы агентных пайплайнов: приёмы, отлаженные в изоляции на одной модели с одним шагом рассуждения, тихо разваливаются, когда в цикл добавляются поиск, контекст и чужие тексты. Уверенность модели перестаёт быть мерой правильности и превращается в меру лёгкости копирования.
RGV предлагает обходной путь, который выглядит почти скучно — считать пересечение слов между ответом и источниками. Но именно эта скучность и делает метод привлекательным: он дешёвый, прозрачный, не требует внутренностей модели и даёт заметный выигрыш там, где правильный ответ тонет в шуме. Для команд, которые строят поисковых агентов из готовых API, это редкий случай полезного улучшения, не требующего ни переобучения, ни новых бюджетов на инференс.


