Почему формат подачи — это не деталь реализации
Когда мы проверяем память языковой модели или качество RAG-пайплайна, нас обычно интересует ровно одно: добралась ли модель до нужного факта. А то, в каком виде этот факт оказался во входном контексте — отдельной записью памяти, сжатым резюме, структурированной записью с полями или сырым куском переписки, — принято относить к внутренним делам системы. Логика простая: если факт есть, неважно, как он упакован.
Авторы препринта arXiv:2608.23568 предлагают с этим не согласиться. Их работа «RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation» (Yuan Si, Simeng Han, Daming Li, Jialu Zhang; v1 от 5 июня 2026 года) бьёт в саму идею, что у памяти есть одна честная и универсальная оценка. Вместо этого её предлагают измерять так же, как измеряют другие чувствительные к конфигурации свойства: зафиксировать одну переменную и перебирать значения другой.
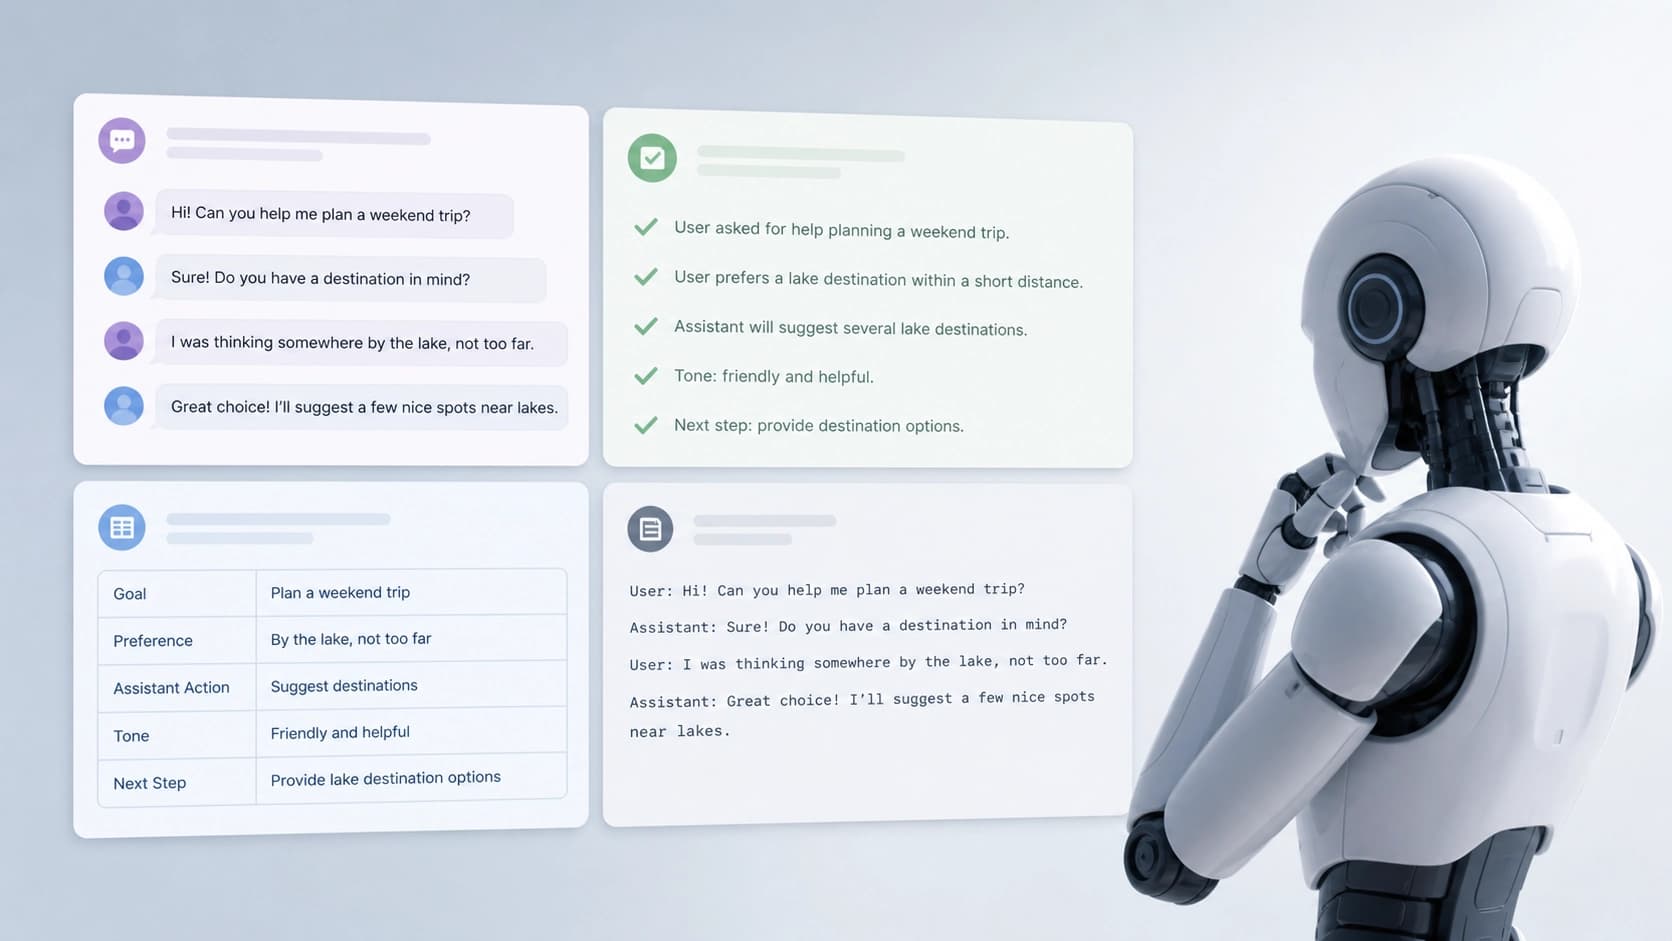
Что именно контролирует RENDER
Диалог не меняется. Меняется только артефакт, обращённый к читателю: то, что модель-ответчик фактически видит перед собой. Именно этот слой — reader-facing artifact — RENDER и делает управляемой переменной.
Лестница из пяти уровней
Ядро методики — five-level packet ladder. Это не просто набор форматов, а шкала, которая локализует момент, когда несущий ответ контент попадает во вход отвечающей модели. Смысл в том, чтобы разделить два принципиально разных провала: система не нашла нужный факт и система нашла его, но не смогла донести в пригодном виде. Без такой шкалы эти случаи сливаются в одну строчку отчёта, и дальше начинаются неверные выводы — например, что модель «плохо помнит», хотя на деле она просто не разобрала упаковку.
Четыре шаблона подачи
Второй элемент — детерминированные шаблоны, аппроксимирующие типовые способы показа истории пользователю. Их четыре:
- записи в стиле ChatGPT — аккуратные блоки, похожие на то, что человек видит в интерфейсе чат-бота;
- резюме в стиле LangChain — сжатые пересказы, которые теряют формулировки, но сохраняют суть;
- типизированные записи в стиле MemGPT — структура с полями и категориями, удобная для машинной обработки;
- сырой диалог — реплики как есть, без разметки и переупаковки.
Шаблоны детерминированные: один и тот же вход каждый раз даёт один и тот же текст. Это важно, потому что иначе нельзя было бы отличить эффект формата от случайного разброса генерации.
Что показали цифры
Эксперимент опирается на 500 вопросов из LongMemEval и девять моделей. Здесь стоит остановиться: это не один запуск и не один прогон ради красивой цифры, а сетка «модель × формат подачи», которая и позволяет увидеть эффект.
Главный результат: matched-budget resolved packets обходят recency-truncated raw dialogue на 42.4–72.6 пункта. Иными словами, если привести форматы к сопоставимому бюджету и дать модели контент, который действительно несёт ответ, разрыв с самым наивным способом подачи — обрезанным по свежести сырым диалогом — оказывается не косметическим, а обвальным.
В deployed-style шаблонах картина мягче, но всё равно крупная: разброс между лучшим и худшим форматом составляет 24.6–48.8 пункта на каждую из девяти моделей. То есть внутри одной модели, на одних и тех же вопросах, при одном и том же бюджете можно «потерять» или «приобрести» десятки пунктов просто за счёт того, как выглядит доказательство.
Ещё одна деталь из первичного скоринга: у 7 из 9 моделей записи в стиле ChatGPT получают более высокие точечные оценки, чем сырой диалог. Это, пожалуй, самый неудобный вывод для тех, кто строит метрики на «чистой» истории переписки.
Судья тоже не истина в последней инстанции
Отдельный сюжет — что будет, если оценки пересчитать не автоматическим скорером, а судьёй-моделью (judge rescoring). Агрегированный положительный эффект формата сохраняется, но значимость по отдельным моделям становится смешанной. Проще говоря: тренд на уровне всей выборки не исчезает, а вот точечные утверждения вида «модель X выигрывает именно благодаря формату Y» после пересудьи уже не так надёжны.
Это не повод отказываться от LLM-судей, но хорошее напоминание: любая оценка памяти сама является измерительным прибором с собственной чувствительностью к формату входа. И если система и судья по-разному реагируют на упаковку доказательств, то разница может уйти в шум или, наоборот, в ложный сигнал.
Самый наглядный результат: ноль против пятидесяти
Если из статьи брать одну цифру, брать стоит эту. Три модели, показавшие 0 % на formal ledger packets, отвечали на те же самые факты из natural-language entries с точностью 45.4–53.4 %.
Не «немного лучше», не «в пределах погрешности» — от полного нуля до уверенного попадания в половину случаев на идентичном содержании. Такой разрыв трудно объяснить нехваткой знаний у модели или плохим поиском: факты были на месте, менялся только способ их предъявления. Формальная, машиночитаемая запись почему-то оказывалась для модели непроходимой, а та же информация, изложенная обычным языком, считывалась без проблем.
Для инженера это практический сигнал: если ваш пайплайн складывает память в строгие структурированные блоки, вы можете систематически недооценивать возможности модели — и одновременно переоценивать пользу от формализации.
Насколько это устойчиво
Эффект не рассыпается при усложнении условий: он сохраняется при retrieval noise, то есть когда в контекст подмешиваются лишние фрагменты. Более того, он переносится на HotpotQA — другой набор данных, построенный вокруг многошаговых вопросов. Это важно, потому что снимает подозрение, будто всё дело в специфике одного бенчмарка для длинной памяти.
Ограничения тоже стоит держать в голове: шаблоны приближают реальные способы подачи, а не воспроизводят их буквально, а выводы по конкретным моделям после пересудьи смешанные. Так что речь не о готовых рецептах, а о необходимости вообще замечать эту переменную.
Что с этим делать на практике
Вывод авторов довольно прямой: отчёты об оценке memory/RAG должны либо сообщать, какой reader-facing артефакт использовался, либо явно его контролировать. Ниже — как это выглядит прикладным образом:
- Фиксируйте формат в описании теста. «Мы прогнали модель на LongMemEval» — недостаточное описание, если не сказано, в каком виде история попадала на вход.
- Прогоняйте хотя бы два-три формата. Один хороший и один наивный (например, сырой обрезанный диалог) уже дадут представление о чувствительности вашей системы.
- Не сравнивайте модели между собой на разных упаковках. Разница в 20–30 пунктов может целиком принадлежать формату, а не модели.
- Проверяйте свои структурированные схемы памяти. Ноль на формальной записи при уверенных ответах на тот же факт обычным текстом — это баг подачи, а не памяти.
- Отдельно тестируйте канал «модель-судья». Если оценщик сам чувствителен к формату, метрика становится смещённой.
- Учитывайте цену формата. Резюме и типизированные записи экономят токены; теперь у этого есть измеримая обратная сторона, и её стоит взвешивать осознанно.
Главная мысль RENDER проста и потому неудобна: «оценка памяти модели» без указания способа подачи доказательств — неполное утверждение. Один и тот же диалог, одни и те же вопросы, одна и та же модель, но разные ответы. Разница в том, как вы показали ей то, что она должна вспомнить.