Молекулярная наука давно считается одним из самых перспективных — и самых сложных — направлений для ИИ. Именно ей посвящён препринт arXiv:2608.23104 «Molecular LLM Agents: From Architectural Design to Scientific Autonomy»: 25 страниц, категории cs.CL и cs.AI, версия v1 от 24 августа 2026 года и уточнённая v2 от 25 августа. Авторский коллектив — Jiatong Li, Wengyu Zhang, Weida Wang, Yuxuan Ren, Wei Liu, Chenyang Mao, Yuqiang Li, Yatao Bian, Changmeng Zheng, Xiaoyong Wei и Qing Li. Работа интересна не очередным рекордом на бенчмарке, а попыткой навести порядок в терминах: что вообще считать молекулярным агентом, из каких узлов он собирается и насколько самостоятельно может действовать.
Чем молекулярный агент отличается от «обычного»
Разговорные ассистенты и кодовые агенты живут в мире текста, репозиториев и веб-страниц. Инструменты, которыми они оперируют, почти всегда принимают и возвращают что-то, что можно прочитать глазами. С химией этот трюк не проходит: молекула — не абзац.
Доменному агенту приходится иметь дело сразу с несколькими несовместимыми типами данных:
- символьные нотации вроде SMILES — компактные строки, где один неверный символ превращает лекарственный кандидат в другое вещество;
- молекулярные графы, где важны не только атомы, но и порядок связей, заряды, стереохимия;
- трёхмерные конформации — потому что свойства молекулы определяются её формой, а не только формулой;
- спектры и результаты симуляций — длинные числовые ряды, из которых нужно вытащить смысл;
- измерения из «мокрой» лаборатории, то есть данные реальных экспериментов с веществом, а не с файлом.
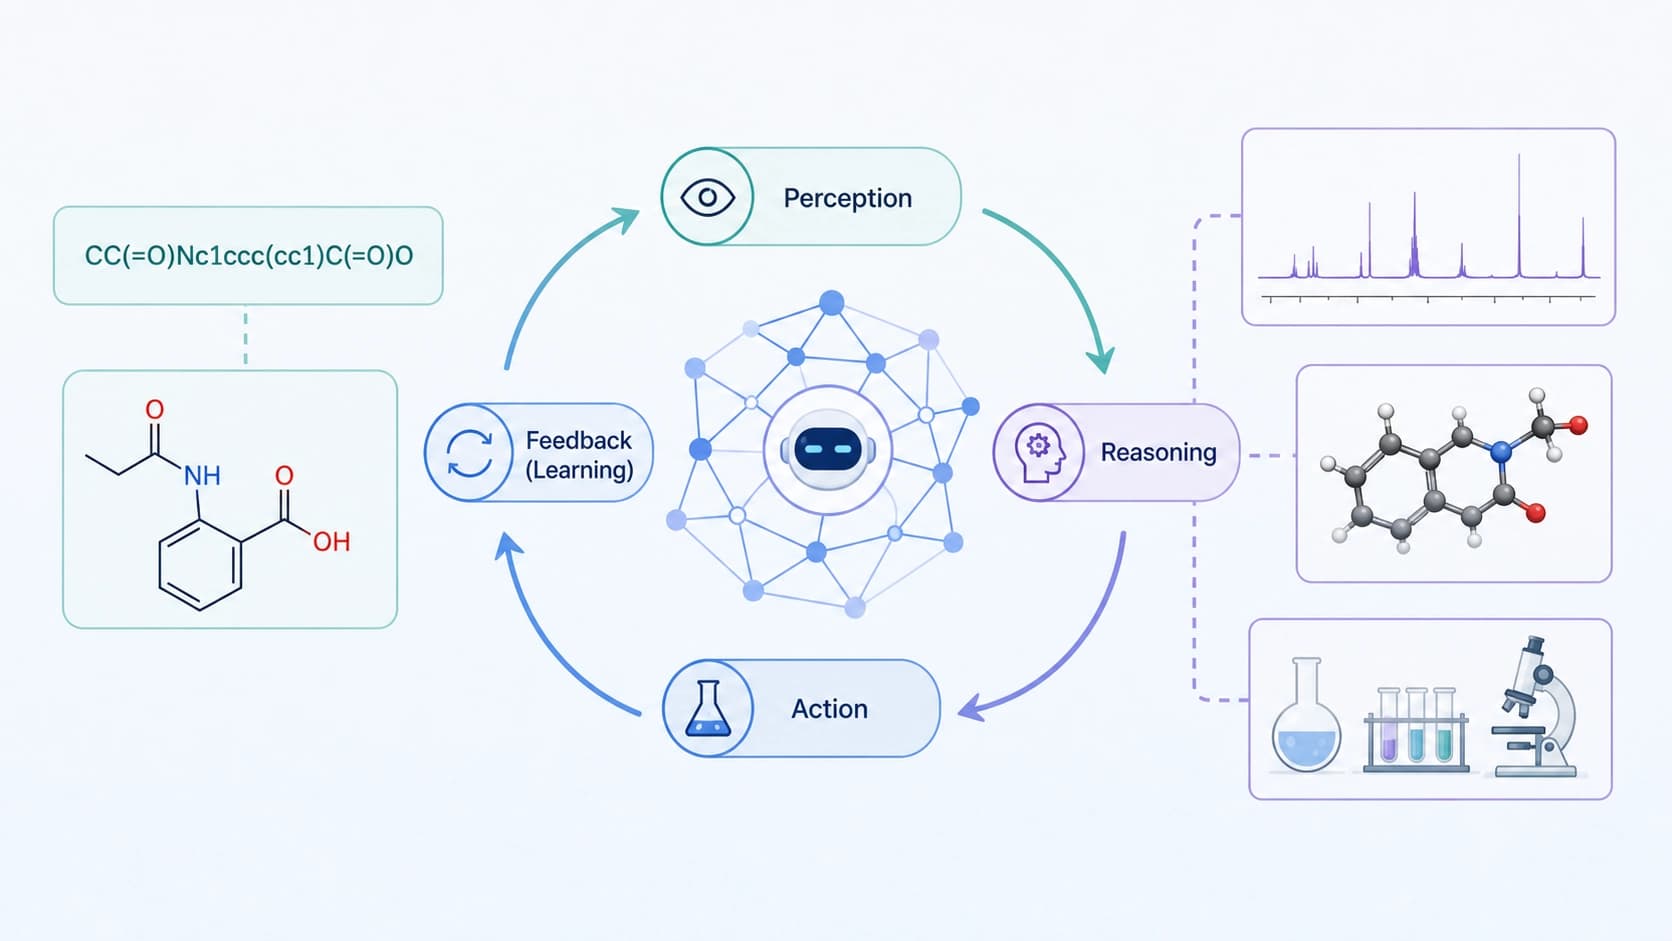
Отсюда и главная мысль авторов: способности такого агента складываются не из одной удачной модели, а из нескольких опор сразу. Нужно химически корректное восприятие молекулярных объектов, агентный фреймворк с языковой моделью в центре, инструменты, привязанные к конкретной предметной области, а также канал обратной связи — вычислительной или экспериментальной. Сверху на это накладывается умение планировать и вовремя вызывать нужный инструмент.
Архитектурный взгляд: из чего собирают молекулярного агента
Первая из двух перспектив статьи — инженерная. Авторы раскладывают конструкцию на четыре слоя и предлагают смотреть на любой существующий проект именно так.
Восприятие: молекула как объект, а не как абзац
Языковые модели обучены на тексте, поэтому строку SMILES они поначалу видят как набор токенов и легко «галлюцинируют» несуществующие валентности. Здесь помогает связка с доменными моделями: например, AlphaFold показывает, как специализированная архитектура решает узкую молекулярную задачу точнее универсальной. Для агента это означает простую вещь: прежде чем рассуждать, он должен уметь валидировать — проверять, существует ли молекула вообще, сходится ли её граф с формулой, не потерялась ли стереохимия при переводе между форматами.
Фреймворк, тулбоксы и обучение
Второй и третий слои — это «мозг» и «руки». Языковая модель планирует и решает, какой расчёт запустить; доменный тулбокс даёт ей докинг, квантово-химический расчёт, поиск по базам, предсказание свойств. Хороший пример такого подхода — агент ChemCrow: ценность там создаёт не сама модель, а аккуратно описанные инструменты, которые она вызывает.
Четвёртый слой — обучение и оптимизация. Агента можно дообучать на траекториях удачных решений, а можно просто улучшать описание инструментов и стратегию их выбора. Второй путь дешевле, и авторы явно дают понять: половина провалов в этой области — не про слабую модель, а про плохо спроектированную петлю обратной связи.
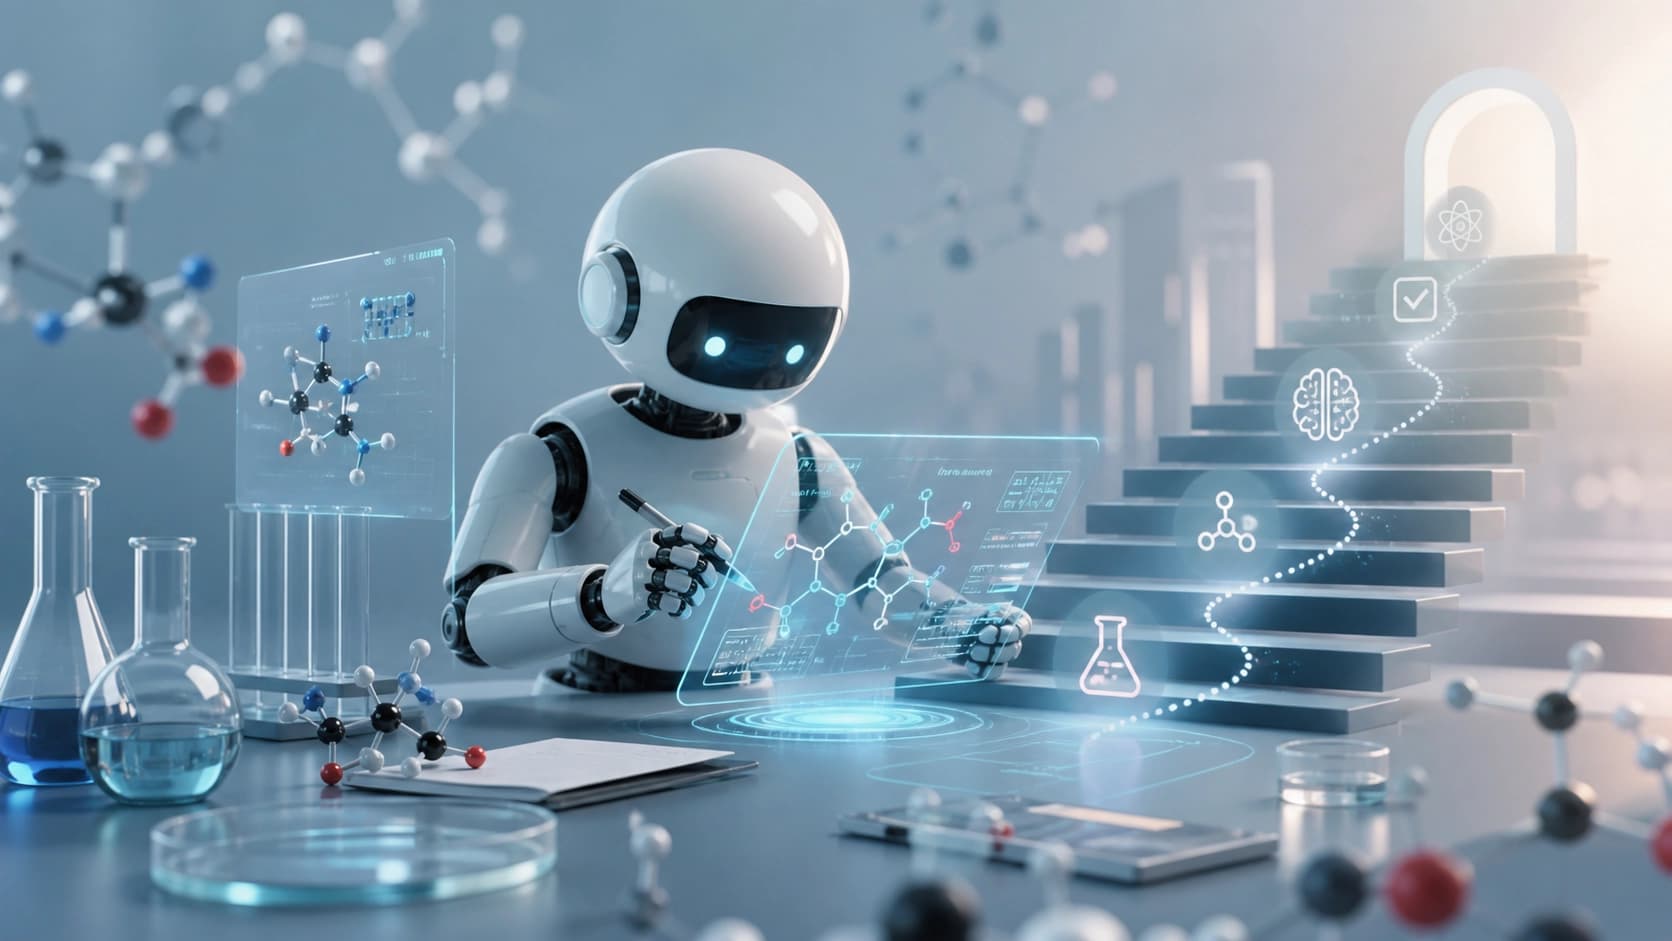
Лестница научной автономии: L1–L4
Вторая перспектива статьи — та самая «лестница автономии», позаимствованная из логики уровней в инженерных системах. Она нужна, чтобы не спорить абстрактно «умный ли агент», а понимать, сколько решений он реально берёт на себя.
L1 — ассистент с фиксированным сценарием
Здесь человек задаёт последовательность шагов, а модель выполняет отдельные операции: перевести структуру, посчитать дескрипторы, предложить варианты. Автономии почти нет, зато предсказуемость максимальная.
L2 — адаптивный вычислительный агент
Агент сам решает, какой инструмент вызвать и в каком порядке, перепланирует при ошибке, работает в полностью цифровом контуре. Это сегодняшний мейнстрим: риск ограничен испорченным расчётом, а не испорченным образцом.
L3 — агент, учитывающий результаты реальных экспериментов
Самый интересный и самый рискованный уровень. Агент не только планирует, но и получает обратную связь из физической лаборатории — спектры, хроматограммы, данные синтеза — и корректирует план по ним. Примеры такого класса систем существуют: Coscientist демонстрировал планирование синтезов с привлечением лабораторной автоматики. Но именно здесь цена ошибки перестаёт быть абстрактной: неверный шаг расходует реагенты, время прибора и, в худшем случае, безопасность людей.
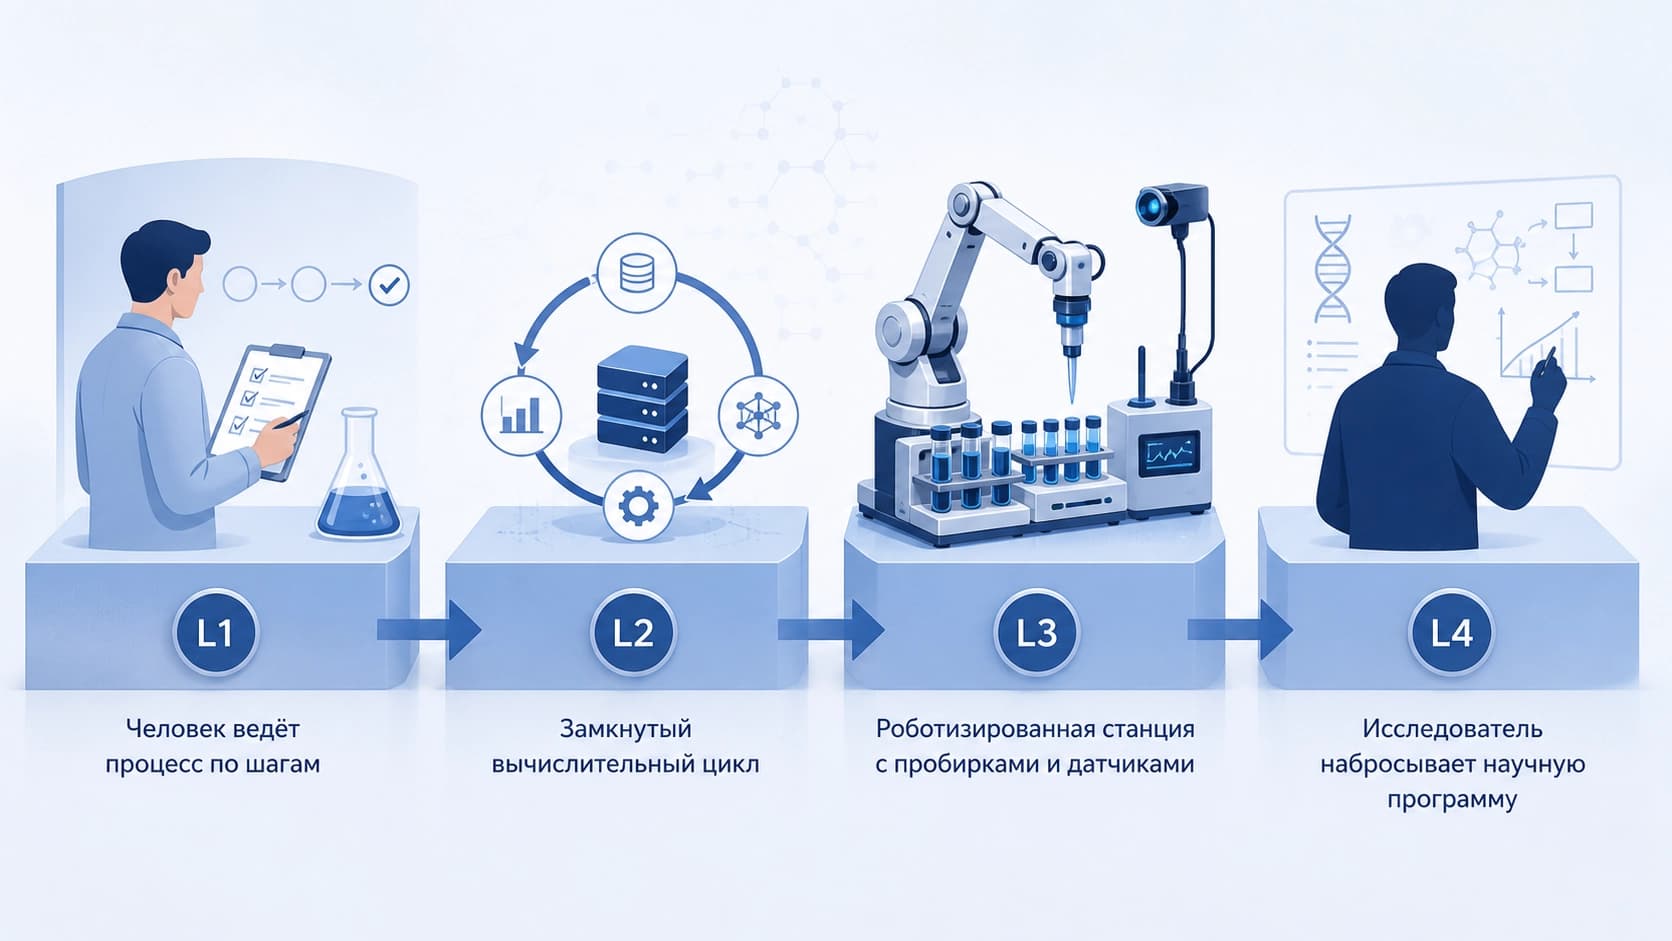
L4 — агент, формирующий научную повестку
Верхняя ступень — когда система сама выбирает, какие гипотезы проверять, какие направления считать приоритетными и где искать пробелы в литературе. Пока это скорее ориентир, чем описание работающих решений. Но именно он задаёт направление: разница между «быстрым исполнителем» и «соавтором-постановщиком» принципиальна, и её стоит фиксировать словами, а не интуицией.
Зачем нужна такая рамка
Практическая польза от двух перспектив — в возможности сравнивать несравнимое. Если два агента оба называют «автономными», но один крутится в симуляторе, а второй управляет роботом-синтезатором, это системы разного класса ответственности.
Авторы предлагают использовать фреймворк для трёх задач:
- Диагностика. Разложив агента по слоям, видно, где у него просадка: в восприятии молекул, в инструментах или в планировании.
- Оценка рисков. Чем выше ступень, тем серьёзнее последствия сбоя — и тем важнее проверки перед действием, а не после.
- Проектирование. Понимание, какой уровень автономии реально нужен для задачи, спасает от соблазна строить L4 там, где хватило бы аккуратного L2.
Ограничения и что остаётся нерешённым
Честная оговорка: лестница — это концептуальная модель, а не измеренная шкала. Она помогает думать, но не заменяет валидацию, сертификацию и воспроизводимость результатов. К тому же химия плохо терпит «почти правильно»: в тексте опечатка — досадно, в структурной формуле — уже другое вещество.
Отдельный нерешённый вопрос — данные. Обратная связь из реальной лаборатории дорогая и редкая, а без неё агент L3 остаётся теорией. Второй вопрос — интерпретируемость: химику нужно понимать, почему система предложила именно этот маршрут синтеза, иначе доверия не будет.
Коротко о главном
Молекулярные LLM-агенты — не просто «химия плюс чат-бот». Это отдельный класс систем, где языковая модель работает диспетчером между графами, спектрами, расчётными пакетами и лабораторным оборудованием. Работа arXiv:2608.23104 полезна прежде всего словарём: четыре архитектурных слоя и четыре ступени автономии дают общий язык для разговора о том, что такие агенты уже умеют, чего им не хватает и где проходит граница между полезным ускорением рутины и решением, которое лучше оставить человеку.