Проблема: модель проверяют там, где искать уже не нужно
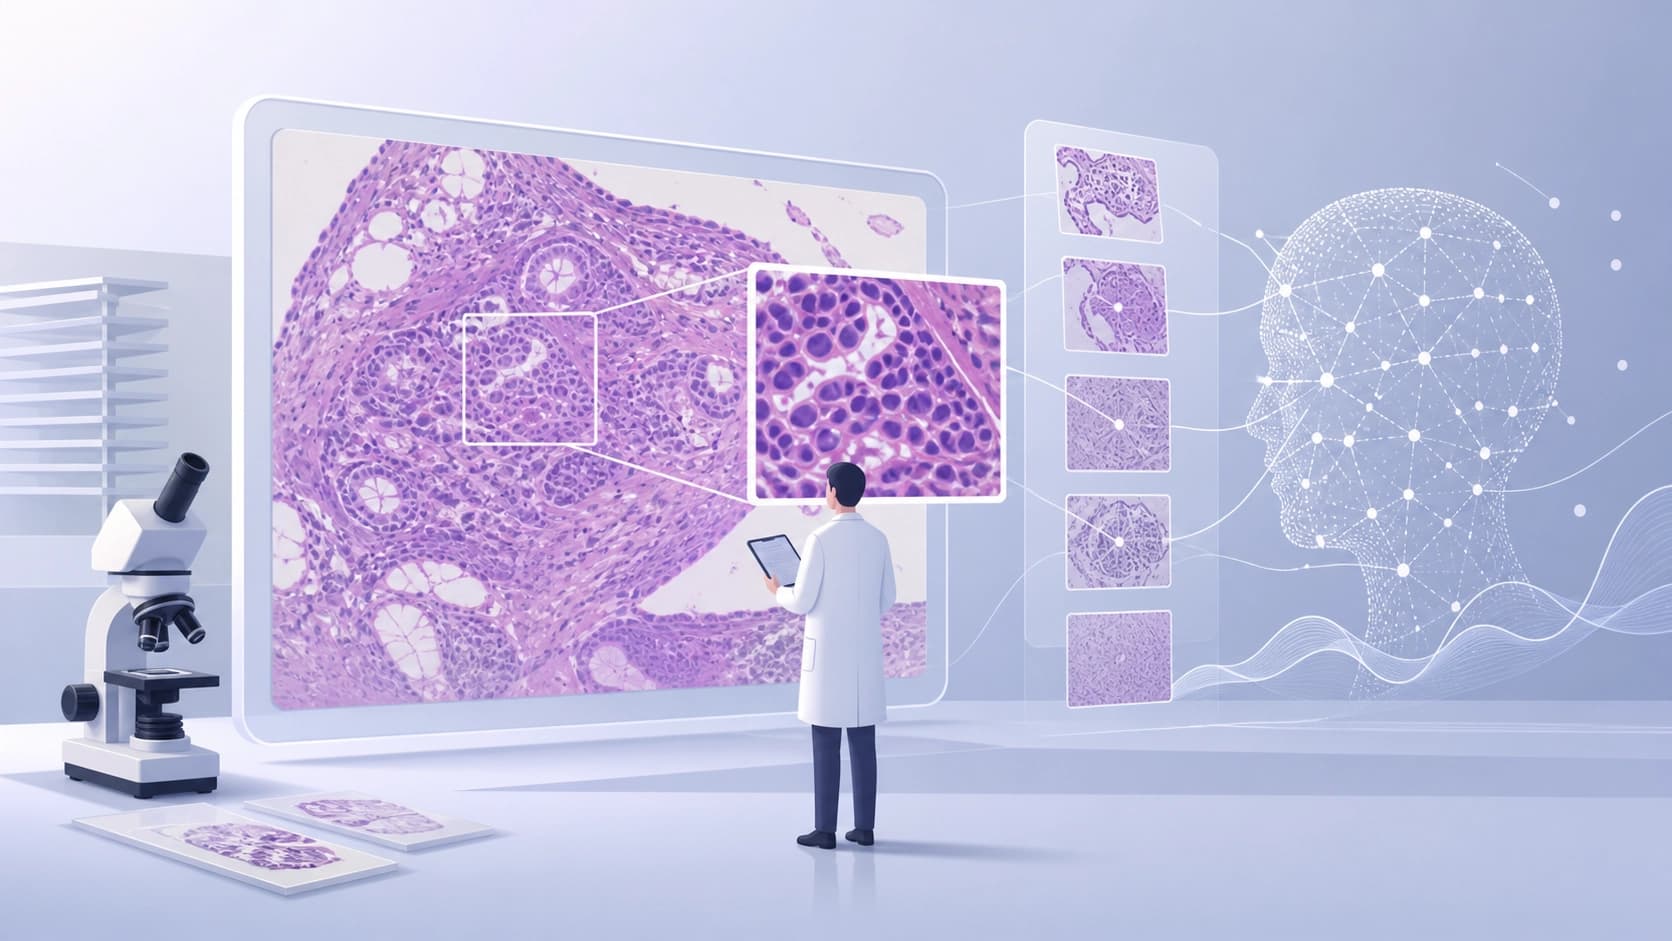
Гистологический слайд — это гигапиксельное изображение. Чтобы поставить диагноз, патологоанатом сначала оглядывает препарат на малом увеличении, выхватывает подозрительные участки, затем рассматривает их вблизи, сопоставляет картину на разных масштабах и только потом формулирует заключение. Существенная часть этой работы уходит не на разглядывание, а на поиск: куда вообще стоит смотреть.
Большинство существующих бенчмарков для ИИ-патологии эту часть работы у модели отнимают. На вход подаётся либо заранее вырезанный патч, либо уже извлечённые признаки слайда — то есть кто-то другой заранее решил, что именно здесь важно. Модель получает готовые доказательства и демонстрирует умение рассуждать по ним. А насколько хорошо она добывает доказательства самостоятельно — остаётся почти непроверенным.
Именно на этот пробел нацелена работа EviPathBench. Её авторы — Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai и Yueming Jin; препринт появился на arXiv 21 июля 2026 года, а к 25 августа дожил уже до четвёртой версии (arXiv:2607.19261, cs.CV / cs.AI). Такая частота правок сама по себе намекает: тему авторы считают живой и спорной.
Как устроен бенчмарк
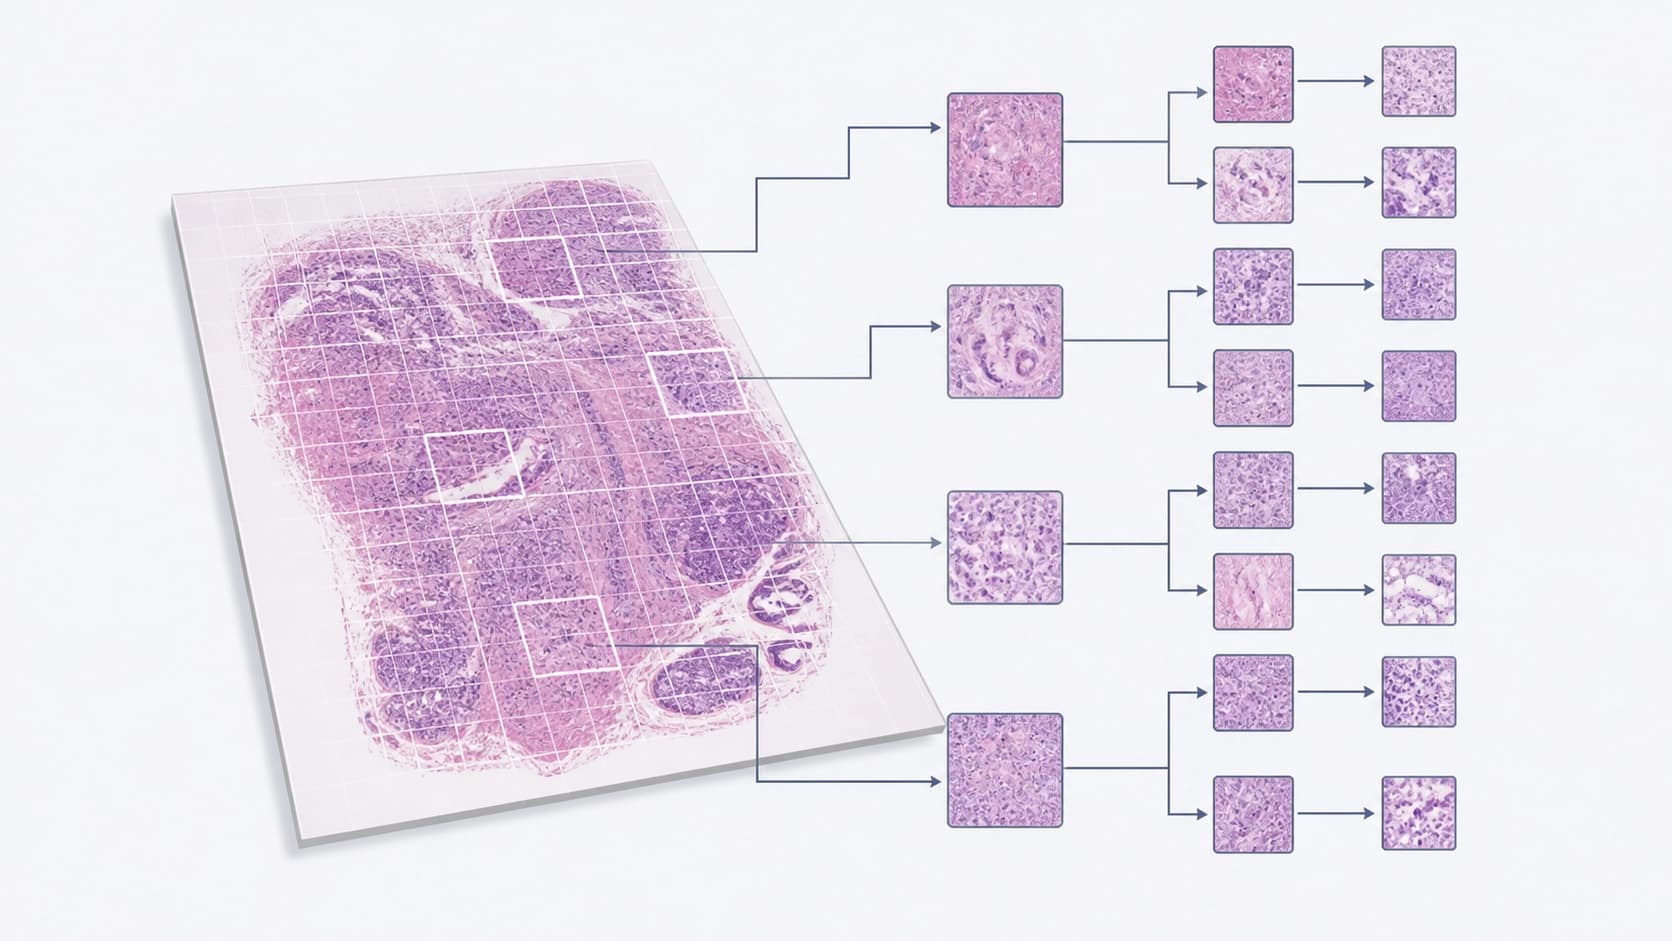
EviPathBench построен не как набор отдельных вопросов с вариантами ответов, а как диагностическое дерево. Вложенные друг в друга области на разных увеличениях связаны с находками, специфичными для конкретного масштаба, и в итоге — с диагнозом уровня патологического заключения. От модели требуется не просто выдать метку «рак», а пройти цепочку: найти область, описать находку на этом увеличении, подняться на уровень выше, согласовать данные между масштабами и свести их в общий вывод.
Четыре проверяемые способности
Авторы разложили навык работы со слайдом на составляющие и оценивают каждую отдельно:
- Сопоставление изображения с текстом — интерпретация доказательства, когда модель связывает увиденное с описанием.
- Текстовый запрос к изображению (retrieval) — верификация: по формулировке нужно отыскать в слайде соответствующий фрагмент.
- Локализация диагностической области — собственно сбор доказательств: где именно искать.
- Разноуровневые рассуждения — интеграция находок, полученных на разных увеличениях, в единую картину.
Такое деление ценно само по себе: оно показывает, что «понимание слайда» — не одна способность, а несколько, и они могут расходиться между собой очень сильно.
Данные и разметка
Основу составили 1 822 WSI из TCGA и 17 135 диагностических путей, размеченных десятью сертифицированными патологами. Отдельно используется приватная когорта из 190 слайдов рака груди с подробными аннотациями — она нужна, чтобы проверить именно автономное исследование целого препарата, без подсказок о том, где находится интересующая зона.
Результаты: рассуждать получается, искать — нет
В оценке участвовали 19 «зрение-языковых» моделей — универсальные, медицинские и специализированные патологические — плюс одна текстовая модель-референс, нужная как точка отсчёта.
Картина получилась контрастной. Лучшие открытые модели превышают 93% точности в разноуровневых рассуждениях и больше 50% — в обеих задачах кросс-модального сопоставления. Казалось бы, всё хорошо.
А вот с локализацией диагностической области — беда. Лучший результат по text-guided mean IoU не дотягивает даже до 0,09. Это хуже простой эвристики, которая ставит прямоугольник в центр слайда, вообще ничего не анализируя. Иными словами, модель, обученная смотреть на ткань, ищет хуже, чем программа, которая не смотрит никуда.
Масштаб ломает поиск
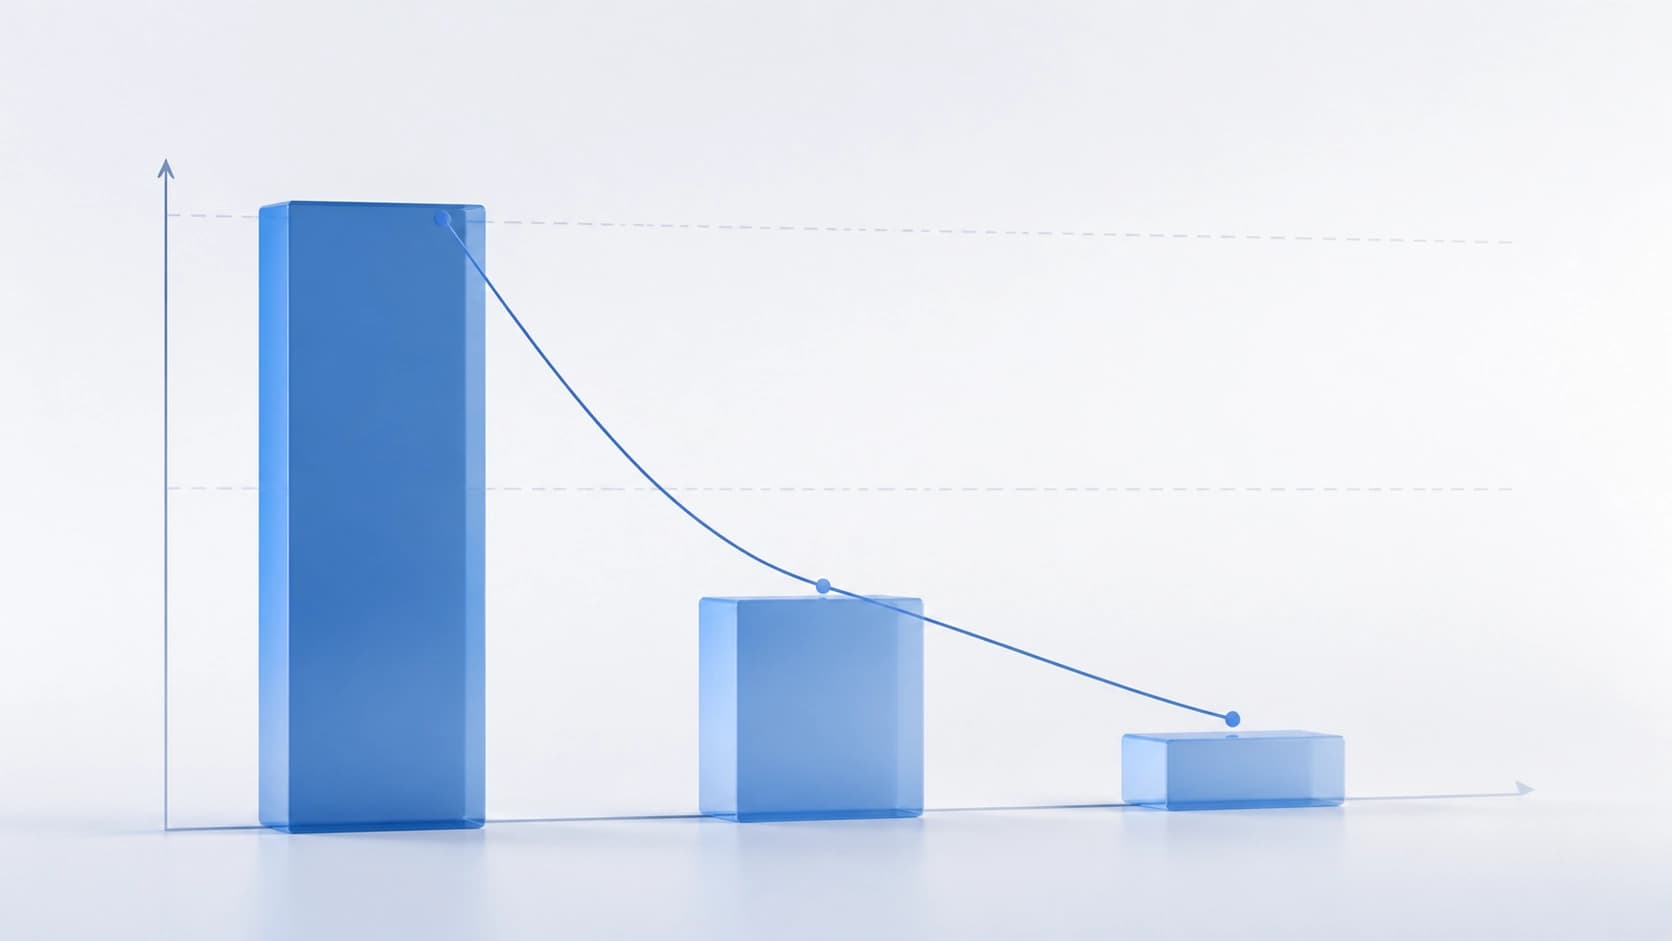
Отдельная линия эксперимента — автономное исследование слайда. Здесь безусловный hit rate обваливается по мере роста увеличения: 0,522 на малом, 0,185 на среднем и 0,020 на большом. Логика падения понятна: на малом увеличении модель видит общую архитектуру ткани и легко попадает «куда-то в правильную зону», но чем сильнее зум, тем уже поле зрения и тем дороже каждая ошибка на предыдущем шаге. Проколы накапливаются, и к максимальному увеличению модель почти гарантированно смотрит не туда.
Что из этого следует
Главный вывод работы формулируется просто: между умением рассуждать по подготовленным доказательствам и умением эти доказательства добывать лежит глубокий разрыв. Первое у современных моделей получается уже неплохо, второе — почти не получается.
Для практики это означает, что навигацию по слайду пока нельзя отдавать модели «на откуп» и ждать клинически осмысленного результата. Зато сам бенчмарк даёт общий фреймворк: по нему можно измерять обе способности и смотреть, помогает ли конкретное улучшение — обучение с подкреплением, память между шагами зума, иерархический поиск — продвинуться в той части, которая проваливается.
Стоит держать в голове и оговорки. Приватная когорта ограничена раком груди, а основная часть данных — ретроспективные материалы TCGA, то есть реальная клиническая вариативность там представлена не полностью. Метрики локализации чувствительны к тому, как именно размечали границы областей, а четыре версии препринта за месяц говорят о том, что цифры ещё могут уточняться.