
Подтверждение кандидатов дороже их генерации: приманки против LLM-поиска уязвимостей
В работе разобрана ценовая асимметрия агентного поиска дефектов: генерация версий дешева, а их подтверждение через анализ достижимости, исполнение и PoC требует основного бюджета, поэтому верификацию можно сделать самостоятельным объектом обороны. Предложенный RedHerring — подстраиваемые под репозиторий приманки с закрытым сертификатом — при равных затратах снижал число найденных настоящих уязвимостей на 38,7–60,4% в 33 проектах OSS-Fuzz; даже после предупреждения агента падение сохранялось на уровне 37,2%.
Проверка гипотез как ограниченный ресурс
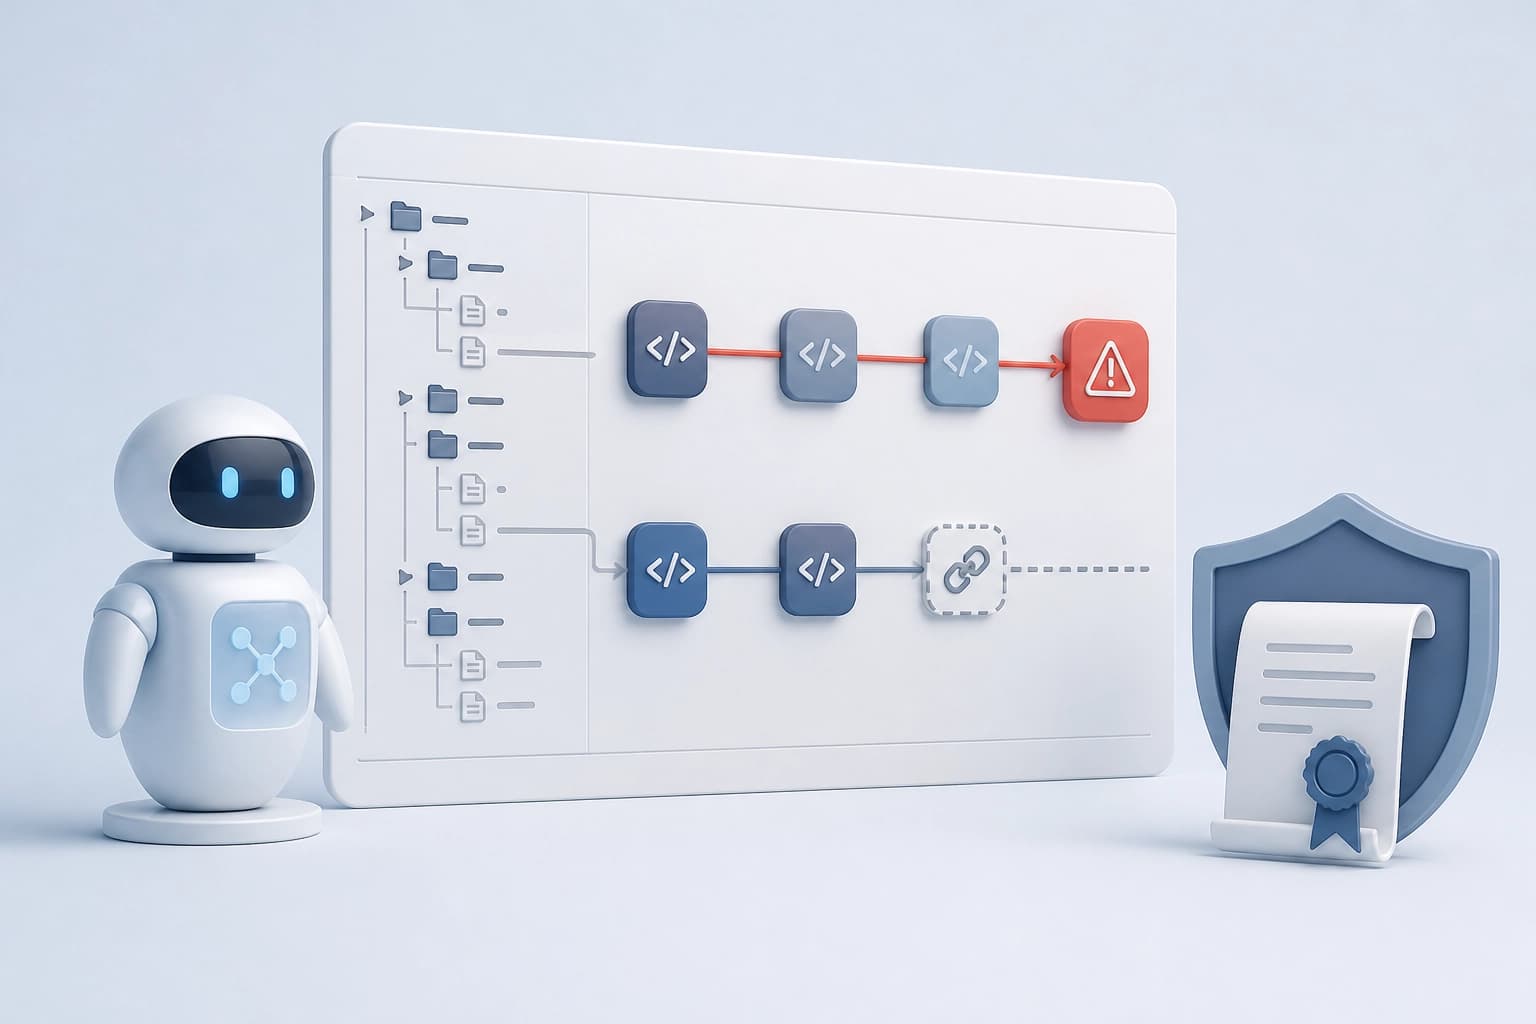
Автономные LLM-агенты ведут поиск уязвимостей на уровне репозитория. Они выдвигают много гипотез. При конечном бюджете агент проверяет только часть из них.
Проверка гипотезы включает несколько этапов:
- анализ достижимости;
- выполнение кода;
- создание proof-of-concept.
Эти действия дороже выдвижения гипотезы. Поэтому поиск уязвимостей становится процессом выборочной проверки. Затраты на проверку образуют отдельную поверхность защиты.
Практический критерий: бюджет защиты нужно оценивать по стоимости подтверждения кандидатов, а не по числу сгенерированных гипотез.
Приманка как объект с сертификатом
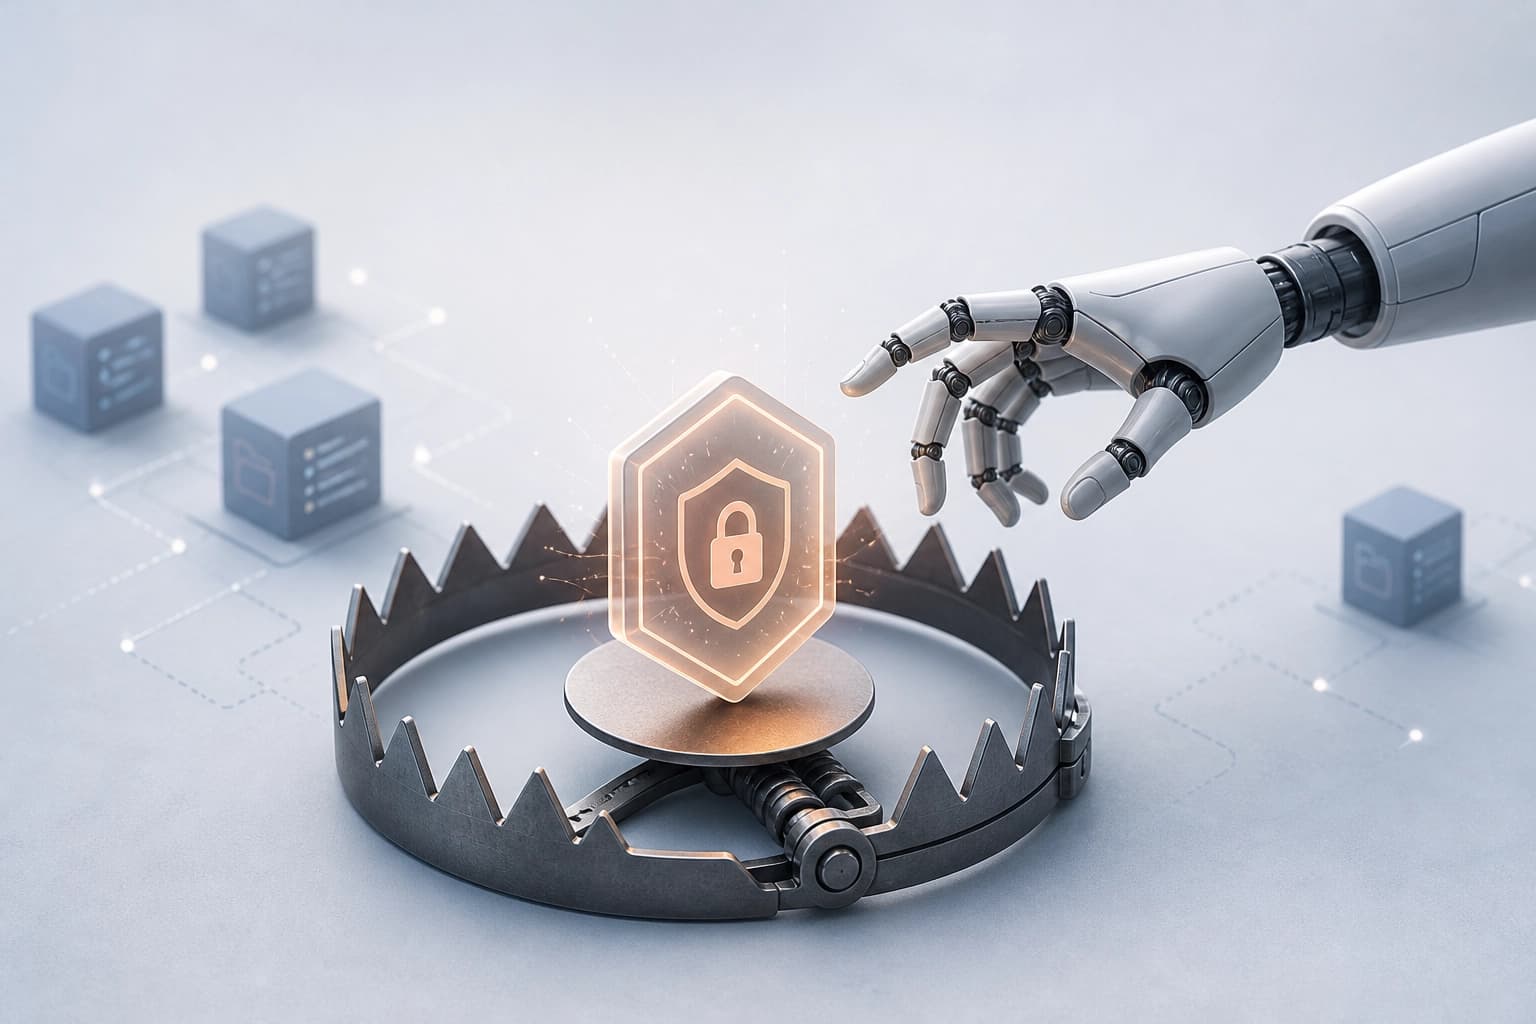
RedHerring добавляет сертифицируемо безопасные приманки. Приманка отвлекает усилия проверки от реальных уязвимостей. Каждая приманка объединяет два элемента:
- цепочку уязвимости, выведенную из CVE; она привлекает проверку;
- ложное связующее звено; из-за него опасный sink остаётся недостижимым.
Закрытый сертификат позволяет защитнику эффективно проверять это свойство. Установление того же факта по опубликованному репозиторию требует решения вычислительно сложной задачи.
| Задача проверки | Условие |
|---|---|
| Подтверждение защитником | закрытый сертификат |
| Установление того же факта по опубликованному репозиторию | решение вычислительно сложной задачи |
RedHerring адаптирует каждую приманку к целевому репозиторию. Приманка выглядит как обычная логика программы.
Практический критерий: приманка пригодна, если защитник подтверждает её безопасность сертификатом, а агент вынужден тратить бюджет на проверку.
Что показали испытания
Испытания проходили на 33 проектах OSS-Fuzz, 70 оценочных экземплярах и пяти моделях. Бюджеты были одинаковыми.
| Условие испытаний | Результат |
|---|---|
| Равные бюджеты, 33 проекта OSS-Fuzz, 70 оценочных экземпляров, пять моделей | сокращение найденных реальных уязвимостей на 38,7–60,4% |
| Агенты явно информированы о приманках | сокращение на 37,2% относительно informed Baseline |
Анализ траекторий показал дополнительную нагрузку:
- 30,6–51,5% completion tokens агенты тратят на проверку приманок;
- по оценке, 32,5–49,9% времени выполнения уходит на ту же проверку.
Информированные агенты адаптировали стратегию поиска. RedHerring всё равно сокращал число найденных уязвимостей. Авторы указывают, что эффективность метода не зависит от секретности приманок.
Практический критерий: приманки сохраняют эффект при раскрытии, поэтому защита опирается на структуру приманки, а не на её сокрытие.
Критерии внедрения в защиту репозитория
При внедрении приманок нужно проверять несколько условий:
- подтверждение кандидатов учитывается как отдельный ресурс защиты;
- приманка содержит цепочку уязвимости, выведенную из CVE, и привлекает проверку;
- ложное связующее звено оставляет опасный sink недостижимым;
- защитник хранит закрытый сертификат для быстрой проверки свойства;
- приманка адаптирована под обычную логику целевого репозитория;
- измеряется доля completion tokens и времени выполнения, уходящая на проверку приманок;
- секретность не считается обязательным условием: информированный агент меняет стратегию, но эффект сохраняется.
Критерий выбора: приманка пригодна, если защитник быстро подтверждает её свойство сертификатом, а агент тратит на её проверку бюджет. Если приманка не привлекает проверку или не поддаётся быстрой проверке защитником, она не выполняет роль защиты.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверка галлюцинаций LLM через SQL-представление источников без дообучения
Работа проверяет, способна ли LLM задействовать базовый символический навык — сборку SQL-базы по исходным документам — для привязки к источнику без учителя при детекции галлюцинаций. На RAGTruth и DiaHalu такой нейросимволический конвейер оказывается точнее прямого предсказания и сопоставим с передовыми методами, не требуя тонкой настройки под предметную область.
9 ноября 2026
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026
AffordanceWAM: аффордансы как посредник между прогнозом сцены и управлением манипулятором
Работа описывает генеративную модель, которая одновременно прогнозирует будущие RGB-наблюдения, скалярные поля и тепловые карты аффордансов и непрерывные команды робота, используя человеческие видео для расширения разнообразия взаимодействий без аннотаций действий и ретаргетинга. На RoboCasa, CALVIN ABC→D и реальных задачах подход даёт устойчивый выигрыш относительно базовых линий только на RGB и только на роботных данных.
9 ноября 2026