
AffordanceWAM: аффордансы как посредник между прогнозом сцены и управлением манипулятором
Работа описывает генеративную модель, которая одновременно прогнозирует будущие RGB-наблюдения, скалярные поля и тепловые карты аффордансов и непрерывные команды робота, используя человеческие видео для расширения разнообразия взаимодействий без аннотаций действий и ретаргетинга. На RoboCasa, CALVIN ABC→D и реальных задачах подход даёт устойчивый выигрыш относительно базовых линий только на RGB и только на роботных данных.
Что представляет собой модель
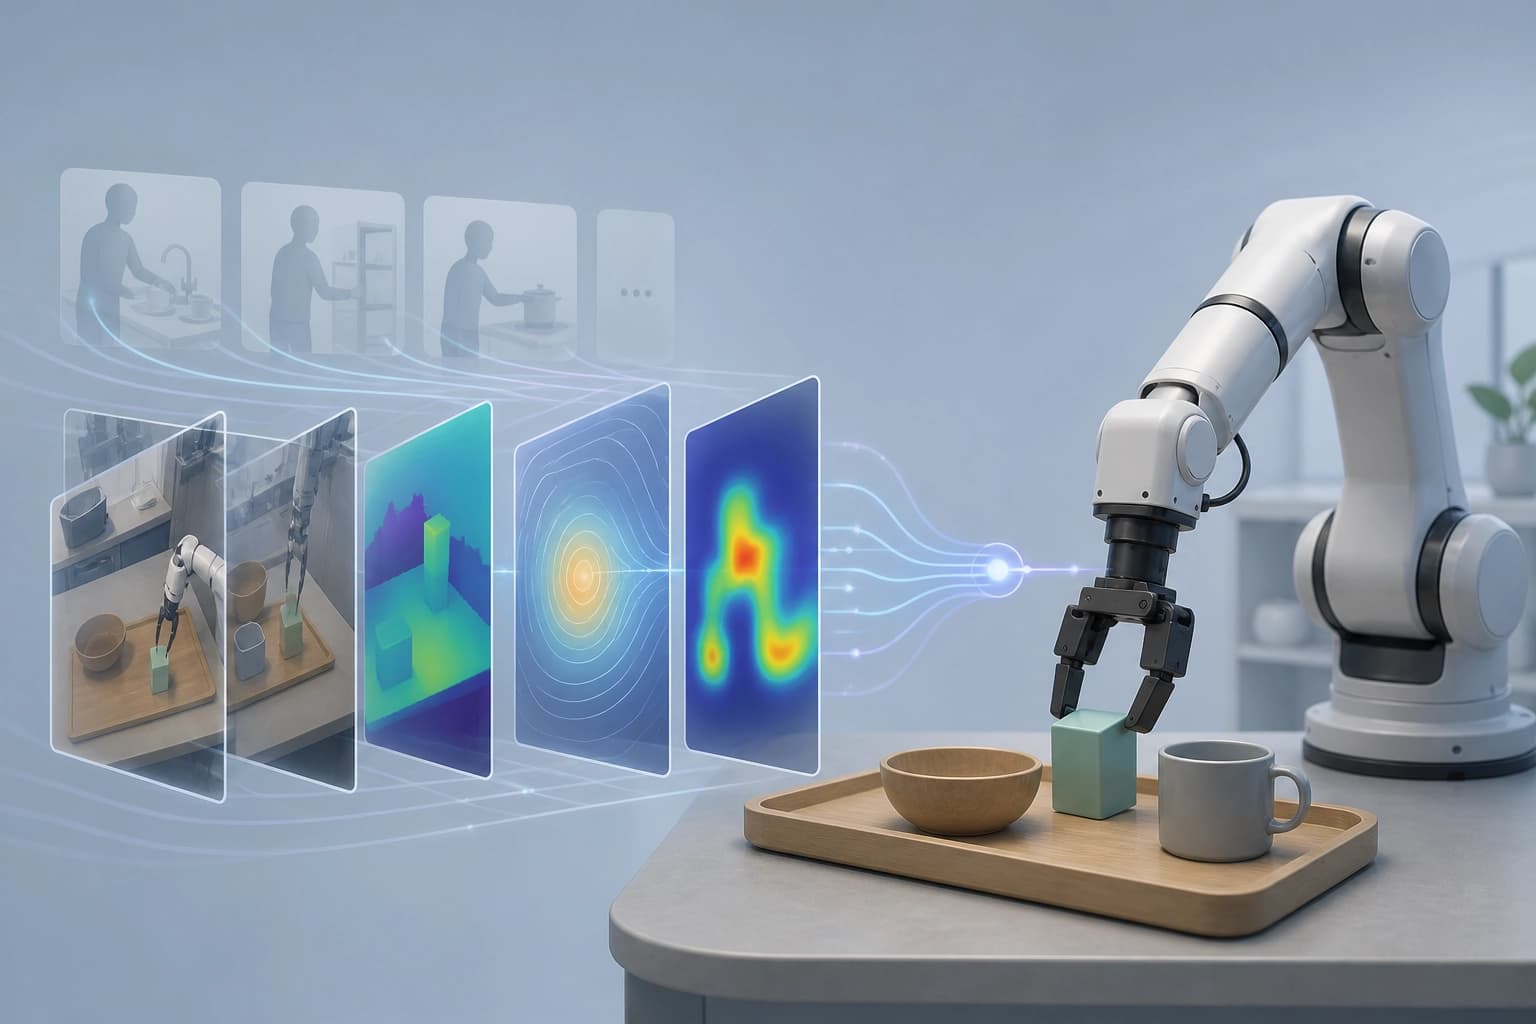
Статья arXiv:2609.22332 представляет AffordanceWAM — генеративную World Action Model с учетом аффордансов для роботизированных манипуляций. Первую версию подали 16 Sep 2026. Последняя указанная версия — v3, revised 18 Oct 2026. Модель представляет объектно-центрированные пространственно-временные аффордансы. Она использует два формата:
- Scalar Affordance;
- Affordance Heatmap.
Эти представления находятся внутри генерируемого будущего World. Аффордансы связывают визуальное предсказание с релевантными задаче объектами и областями взаимодействия. Они служат общей основой для взаимодействий в видео людей и роботов. Так аффордансы становятся посредником между прогнозом сцены и управлением манипулятором.
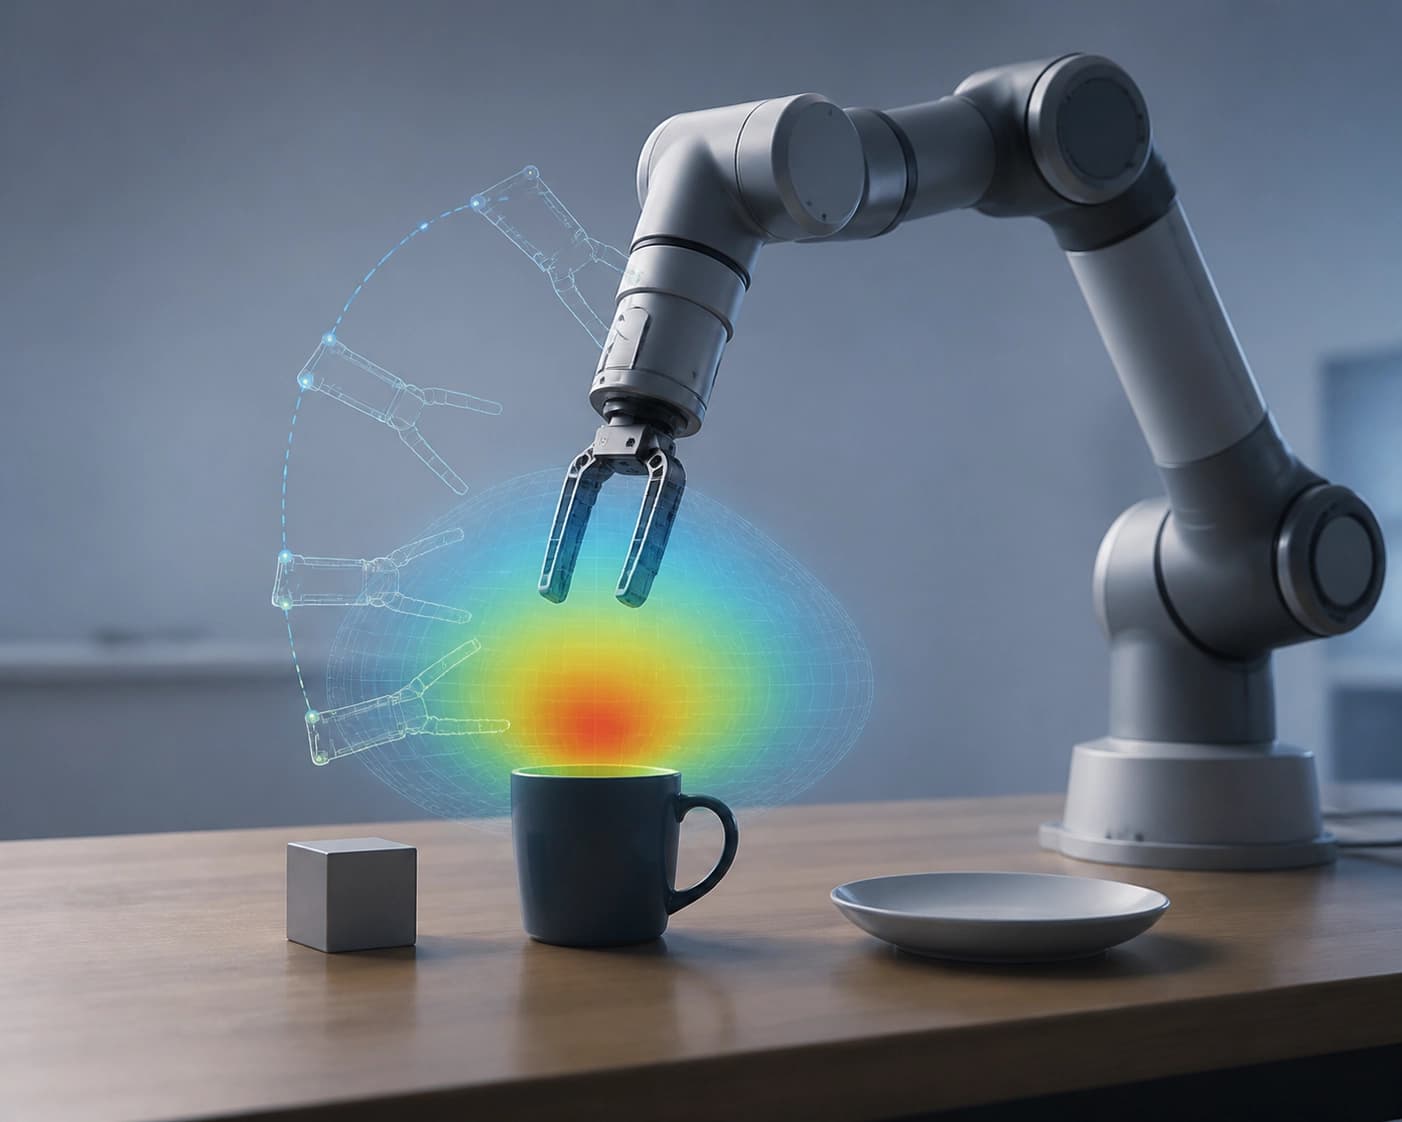
Вывод: модель дает явный формат для объектов и областей действия. Этот формат связывает прогноз будущего с управлением.
Архитектура: два эксперта и единая цель
В основе AffordanceWAM лежит предварительно обученный video diffusion Transformer. Модель использует отдельно параметризованные World Expert и Action Expert. Их связывает Masked Joint Self-Attention.
| Элемент | Роль по описанию статьи |
|---|---|
| World Expert | отдельно параметризованный эксперт мира |
| Action Expert | отдельно параметризованный эксперт действий |
| Masked Joint Self-Attention | связывает World Expert и Action Expert |
| Единая flow-matching objective | объединяет предсказание RGB, аффордансов и действий |
Модель совместно предсказывает будущие RGB-наблюдения, Scalar Affordance fields, Affordance Heatmaps и непрерывные действия робота. Все эти выходы объединяет единая flow-matching objective. Раздельные параметры экспертов не мешают совместному обучению. Их связь поддерживает совместное предсказание мира и действия.
Вывод: архитектура разводит параметры мира и действий. При этом Masked Joint Self-Attention и общая цель сохраняют совместное предсказание.
Обучение на видео людей и траекториях роботов
Обучение AffordanceWAM использует видео людей для всех трех потоков будущего World. Траектории роботов дополнительно дают супервизию действий. Перенос не требует меток человеческих действий или ретаргетинга.
| Источник данных | Что дает обучению |
|---|---|
| Видео людей | обучает все три потока будущего World |
| Траектории роботов | дополнительно дают супервизию действий |
Аффордансы служат общей основой для взаимодействий в видео людей и роботов. Поэтому видео людей можно использовать без меток человеческих действий. Авторы называют аффорданс эффективным интерфейсом для vision-language-action и переноса навыков от человека к роботу.
Вывод: аффордансы дают общий интерфейс для видео людей и роботов. Это снимает необходимость в метках человеческих действий и ретаргетинге.
Эксперименты: прирост и зависимость от данных
Авторы проверяли AffordanceWAM на RoboCasa, CALVIN ABC→D и в реальных манипуляциях. Эксперименты показывают устойчивый прирост относительно базовых методов. Базовые методы используют только RGB или только данные роботов.
На RoboCasa результат монотонно улучшается с ростом объема видео людей, аннотированных аффордансами. Это происходит при фиксированном объеме супервизии роботов. Такой эффект указывает на вклад аффордансов в обучение.
| Условие | Результат по статье |
|---|---|
| База только на RGB | устойчивый прирост у AffordanceWAM |
| База только на данных роботов | устойчивый прирост у AffordanceWAM |
| Больше видео людей с аффордансами при фиксированной супервизии роботов | монотонное улучшение на RoboCasa |
Практический критерий выбора — объем видео людей с аннотациями аффордансов. При фиксированной супервизии роботов рост этого объема дает монотонное улучшение на RoboCasa.
Часто задаваемые вопросы
Похожие материалы
Все материалы
MathAdv: что скрывает итоговая точность машинных доказательств
Диагностический набор задач по 13 университетским и аспирантским разделам математики оценивает системы машинного доказательства в Lean 4 не только по итоговому результату, но и по владению предметом, качеству неформальных рассуждений и устойчивости к переформулировкам условий. Покомпонентный разбор показывает, что перевод задачи в формальный вид по-прежнему остаётся главным препятствием, а успех сильно зависит от области математики и от способа постановки задачи.
9 ноября 2026
Правка презентаций как управляемые операции: фреймворк EditPPT и бенчмарк DeckEdit-Bench
Авторы разбирают редактирование слайдов на конкретные объекты, допустимые действия и проверку того, что постороннее содержимое осталось нетронутым, вместо свободной генерации кода. Для замера качества создан DeckEdit-Bench (183 задачи на 28 человеческих презентациях), а мультиагентная схема EditPPT на пяти базовых моделях показывает успех в 66,7–74,9% задач при сохранности выше 97%.
8 ноября 2026
Неевклидова геометрия факторов: карта FactoMap для разделения представлений
Предложен способ описывать пространство факторов через области, отождествления, задаваемые генератором, и локальные масштабы, что позволяет различать топологически близкие случаи с неодинаковой геометрией. Метод FactoMap обучает интерпретируемые прототипы на структурированной решётке и в экспериментах демонстрирует более устойчивое сохранение непрерывности факторов и их разделения.
8 ноября 2026