Бэкдор приходит из пайплайна, а не от пользователя
Мультимодальные модели всё плотнее встраиваются в прикладные сценарии: они читают скриншоты, разбирают фотографии товаров, отвечают на вопросы по сканам документов. Вместе с удобством в продукт переезжает и чужая уязвимость. Модель собирают из готовых компонентов — визуального энкодера, проекции, языковой части, — и на каждом шаге сборки туда может попасть скрытый триггер. Иногда он спрятан в картинке, иногда в тексте, а иногда требует сочетания обоих сигналов.
Дальше начинается неприятное. Инструменты, которые неплохо справлялись с «отравленными» классификаторами, на мультимодальных моделях заметно сдают: слишком много слоёв, слишком разные модальности, слишком сложная внутренняя геометрия представлений. А те решения, что создавались специально под MLLM, чаще всего работают на входе — отсеивают подозрительные запросы ещё до того, как они дойдут до сети. Фильтр может остановить конкретную атаку, но сама инфекция остаётся в весах. Обойти фильтр — вопрос изобретательности атакующего.
Послойная несогласованность как отпечаток атаки
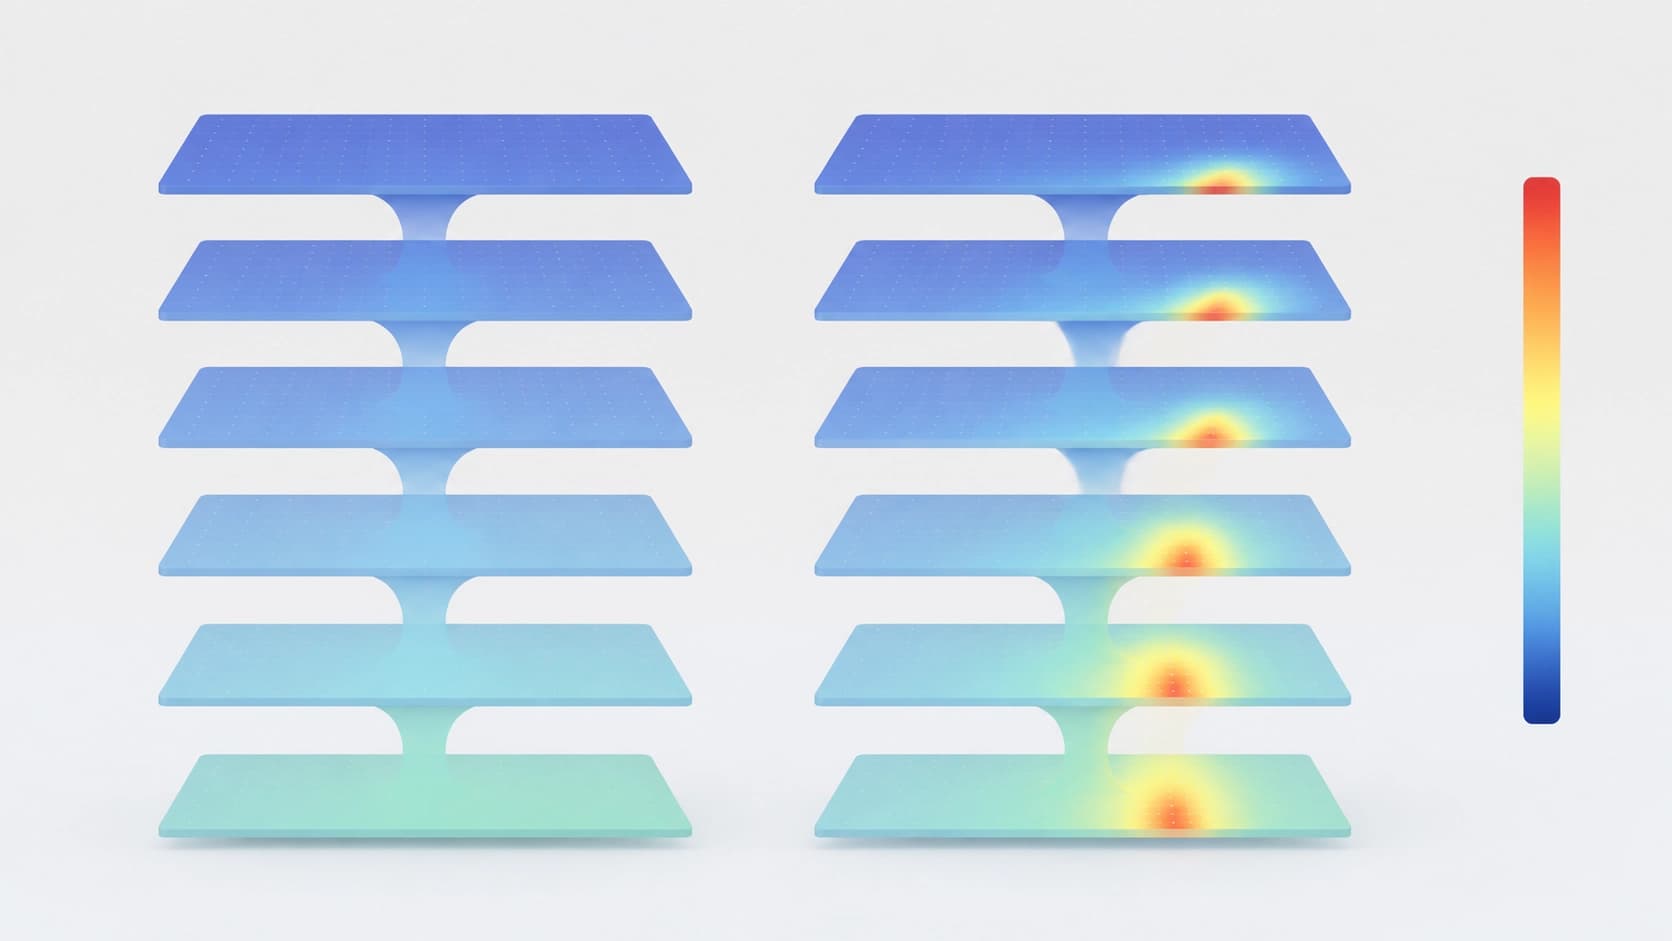
Авторы работы arXiv:2608.24354 (Jiali Wei и ещё восемь соавторов; категории cs.CR, cs.AI, cs.CL, подача — август 2026 года) обратили внимание на вещь, которую легко пропустить, если смотреть только на вход и выход. Бэкдор оставляет след не в одном слое, а в траектории: представления при проходе от слоя к слою меняются нетипично. Это назвали послойной аномалией несогласованности.
Ключевая деталь — аномалия не размазана ровным слоем по всей сети. Она привязана к модальности и, что важнее, локализована в той области токенов, где сидит признак триггера. Иными словами, модель «опирается» на узкий участок представления, и именно там возникает сдвиг, которого не бывает на чистых данных.
Отсюда практический вывод: если усреднять несогласованность по всему представлению, сигнал размывается шумом от полезных признаков. Нужно сначала разделить то, что модель уже смешала.
Как устроен RACER
Разделение по модальностям
Фреймворк восстановления на уровне модели — а не надстройка над инференсом — получил имя RACER (Region-Aware Consistency Repair). Логика такая: слитое представление раскладывают обратно на визуальную и текстовую токен-области, считают послойную несогласованность для каждой отдельно, а затем собирают обратно, но уже с весами, учитывающими модальность. Работа идёт в окне глубоких слоёв — там, где формируются устойчивые, направленные сдвиги.
Результат — регионально-осознанная целевая функция. Она чувствительнее к локальным аномалиям, чем общая метрика по всему вектору, и не даёт полезным признакам заглушить сигнал бэкдора.
Min-max вместо простого дообучения
Дальше включается состязательная схема. Через min-max оптимизацию фреймворк сначала ищет наихудшее возмущение — то, которое максимально усиливает обнаруженную несогласованность, — а затем дообучает модель так, чтобы это возмущение её не ломало. Проще говоря: атакуют сами себя, чтобы закалить те направления представлений, на которых держится вредное поведение.
Практическая сторона важна не меньше технической. Методу нужно всего 100 чистых примеров. Ему не требуется знать ни сам триггер, ни целевую метку атаки, ни даже того, заражена ли поданная модель вообще. Это принципиально: защита не превращается в задачу «угадай атаку».
Что показали измерения
Авторы прогнали метод по трём открытым мультимодальным моделям в 36 конфигурациях бэкдора — с триггерами в изображении, в тексте и в обоих каналах сразу. Средний ASR (доля случаев, когда атака всё-таки срабатывает) удалось свести к 1,1%, а в 32 конфигурациях из 36 показатель упал до нуля.
Второй результат не менее важен, хотя о нём говорят реже: полезность на чистых задачах сохраняется. Причём и у заражённых моделей, и у изначально чистых — то есть восстановление не превращает рабочую модель в осторожную, но бесполезную. Это типичная плата за агрессивные методы очистки, и здесь её, судя по замерам, удалось избежать.
Что это меняет на практике
Разница между фильтрацией входа и восстановлением весов — не академическая. Фильтр живёт в инфраструктуре вокруг модели: его надо поддерживать, обновлять под новые типы атак и всё равно можно обойти через другой канал. Правка на уровне весов убирает причину, а не симптом, и не добавляет задержки в инференс.
Есть и более широкий сюжет. Мы привыкли оценивать безопасность модели по её ответам на тестах, но RACER показывает, что информативный сигнал спрятан в промежуточных представлениях — в том, как сеть думает, а не в том, что она говорит. Если этот подход масштабируется за пределы трёх протестированных архитектур, у поставщиков MLLM появляется относительно дешёвый шаг гигиены: сотня чистых примеров и немного вычислений перед публикацией весов. Ограничения тоже понятны — работа смотрит на конкретный класс атак и требует доступа к внутренностям модели, поэтому для закрытых API-моделей схема напрямую не применима.