Коротко: что именно выложили
В конце августа 2026 года команда LAION опубликовала LAION-BVD — открытый видеокорпус, который в препринте описан как набор данных беспрецедентного масштаба для мультимодального обучения. Работа появилась на arXiv 25 августа 2026 года, рубрики — компьютерное зрение, искусственный интеллект и машинное обучение.
Сухие цифры выглядят так:
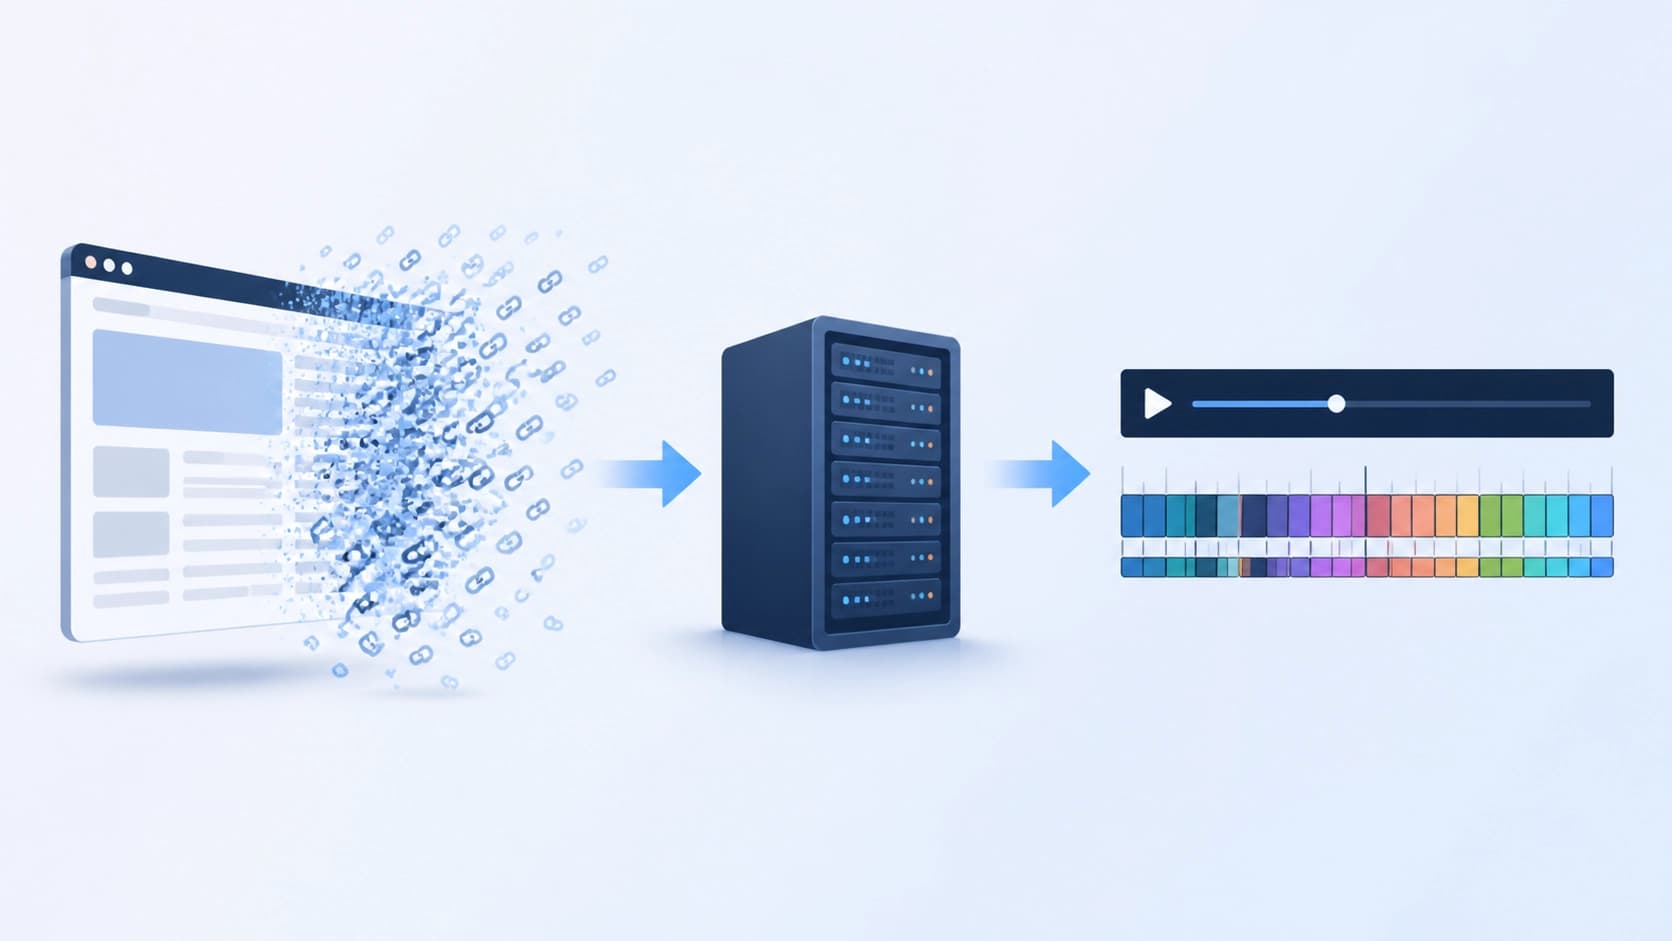
- 1,3 млрд ссылок на видео — исходная точка сборки, ссылки вытащены из веб-краула CommonCrawl и привязаны к конкретным платформам;
- 80 млн роликов реально скачано по этим ссылкам — не всё, что нашлось в индексе, дожило до загрузки;
- 10 млн часов суммарной длительности.
Последняя цифра плохо укладывается в голове: это больше тысячи лет непрерывного просмотра. Именно поэтому релиз называют сдвигом в том, что вообще доступно исследователям без корпоративного бюджета — раньше сопоставимые по объёму видеокорпуса оставались внутри закрытых лабораторий.
Как это собрано
От ссылок до готовых клипов
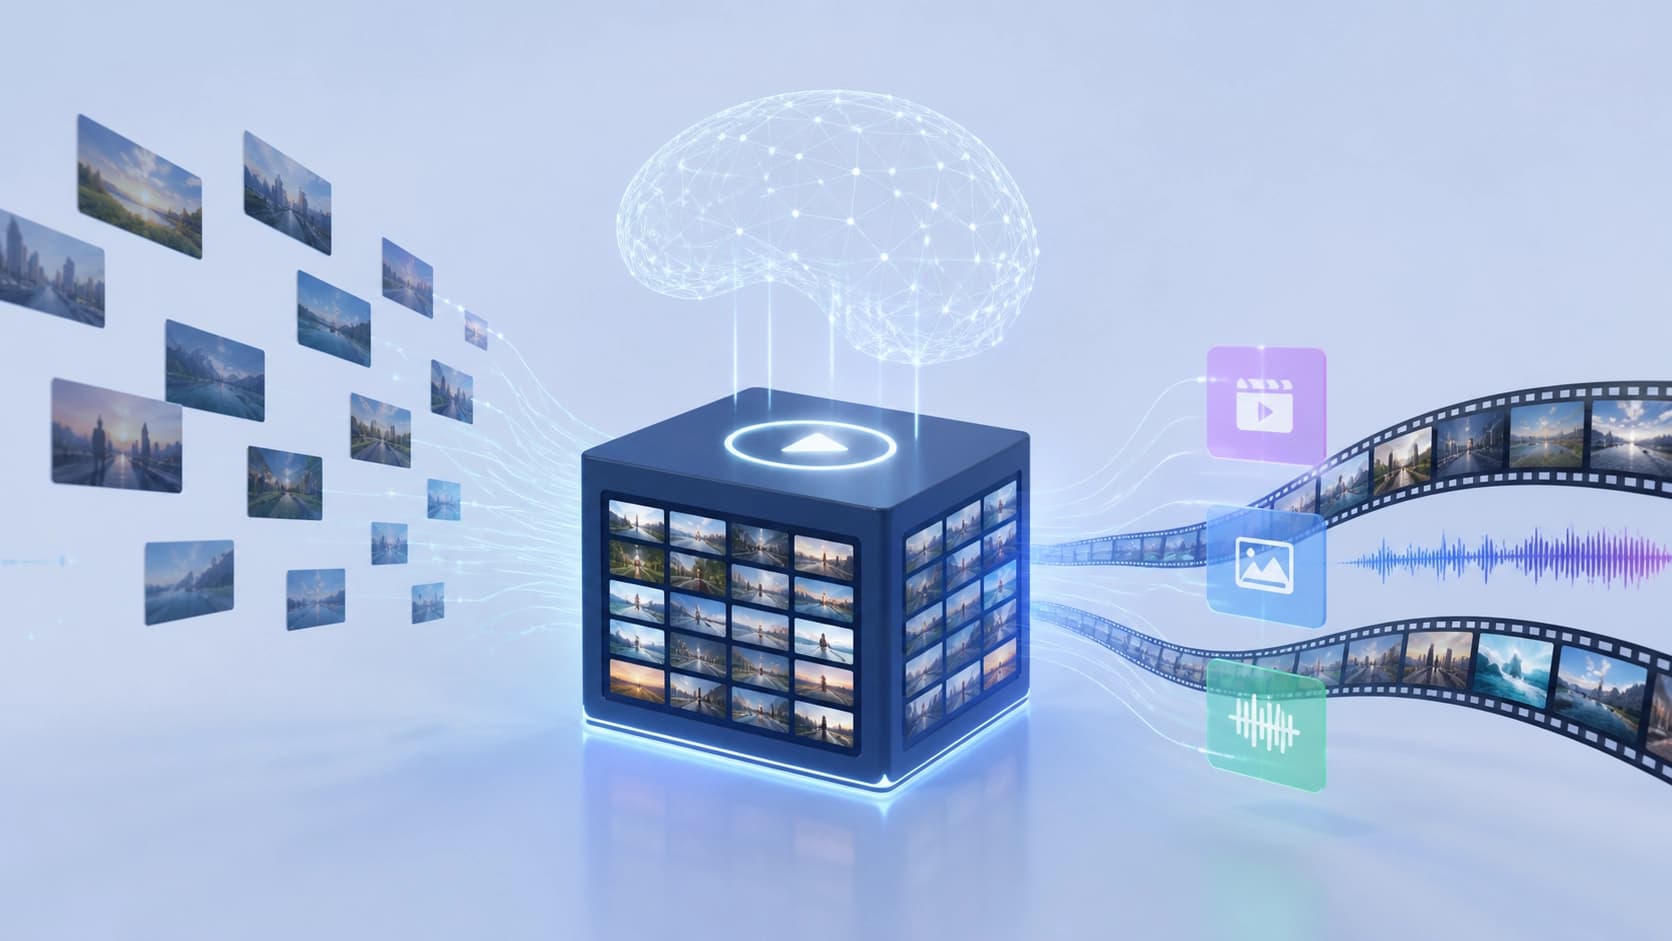
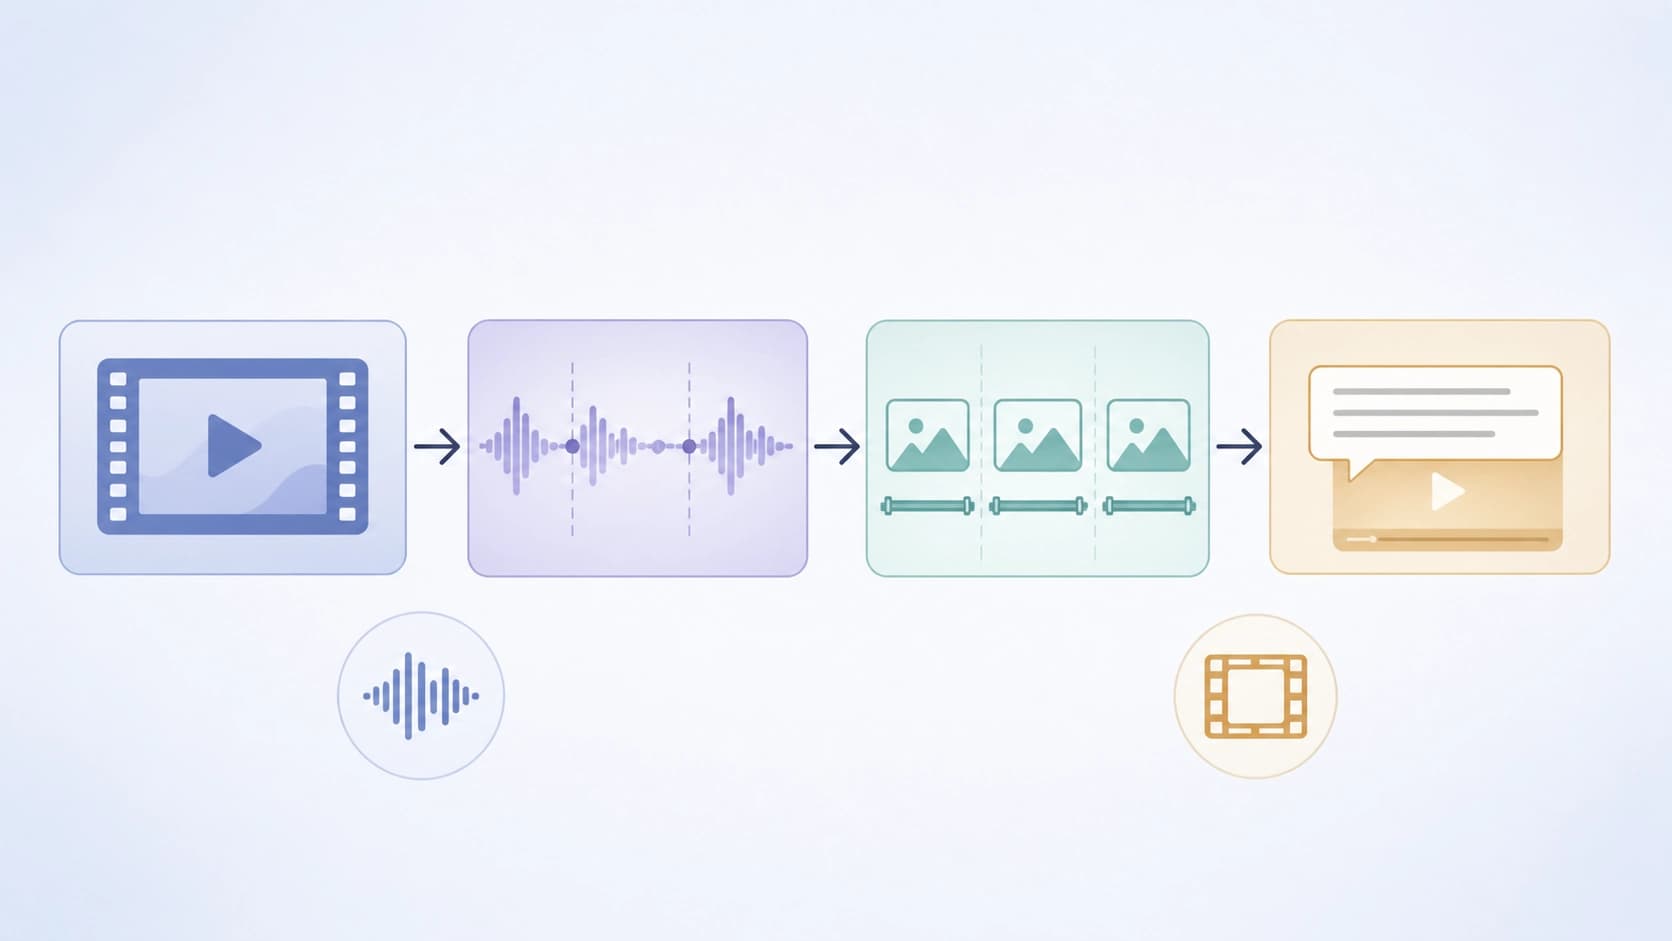
Пайплайн состоит из нескольких ступеней, и каждая важна по-своему. Сначала ссылки отбираются и приводятся к единому виду. Потом начинается массовая загрузка. Затем в дело вступает детекция сцен, чувствительная к содержимому кадра: длинное видео режется не по фиксированному таймкоду, а по реальным монтажным склейкам.
Дальше — самое интересное. Для полученных клипов подписи генерируются синтетически, автоматически и сразу в двух модальностях: текстовая пара к видеоряду и отдельная — к звуковой дорожке. То есть аудио здесь не побочный продукт, а полноценная обучающая сигналка.
Итоговая конструкция заточена под предобучение сразу на трёх типах данных: видео, аудио и изображения.
Кадры как отдельный ресурс
Авторы не ограничились клипами. Из сцен извлекаются кадры, соответствующие моменту смены, и подаются как самостоятельный источник пар «изображение — текст». Логика простая: видеоряд даёт другой срез визуального мира, чем обычные веб-подборки картинок, — с другим распределением сюжетов, ракурсов и бытовых деталей. Для задач поиска по изображению такой сдвиг распределения может оказаться полезнее, чем ещё миллион фотографий из тех же источников, что и раньше.
Что показали эксперименты
Видео и звук
Модели, обученные на новом корпусе, выходят на конкурентный уровень в стандартных бенчмарках на связку «видео — текст» и «аудио — текст». Важнее другое: при увеличении объёма данных или размера модели качество устойчиво растёт. Это тот самый признак, который отличает датасет, который «просто большой», от датасета, который стоит масштабировать дальше.
Картинки
Отдельная линия экспериментов — обучение на извлечённых кадрах. Здесь результат тоже положительный: сильные показатели в поиске по изображению. И это при том, что распределение кадров заметно отличается от привычных веб-корпусов — то есть выигрыш даёт не объём сам по себе, а другой характер визуальных данных.
О чём стоит помнить
- Подписи синтетические: они экономят тысячи человеко-часов, но приносят шум и систематические ошибки. Качество фильтрации здесь важнее, чем размер корпуса.
- Сборка идёт от веб-ссылок, а значит, встают обычные для таких проектов вопросы: долговечность ссылок, условия использования исходников, атрибуция. Открытая лицензия датасета не отменяет вопросов к первоисточникам.
- Корпус заявлен как исследовательский релиз — на практике это значит, что порог входа ниже, чем у внутренних корпоративных наборов, но воспроизводимость чужих результатов всё равно придётся проверять своими руками.
Почему это важно
До сих пор открытое мультимодальное видео в таком объёме было скорее обещанием, чем реальностью: академические наборы измерялись тысячами часов, а всё, что измерялось миллионами, принадлежало компаниям и наружу не выходило. LAION-BVD меняет эту арифметику — и вместе с ней планку для тех, кто строит свои модели.
Практических следствий несколько. Во-первых, появляется база для честных сравнений: если все обучаются на одном и том же открытом корпусе, споры о том, чей результат лучше, становятся содержательнее. Во-вторых, у небольших команд и университетов возникает альтернатива аренде чужих эмбеддингов — можно учить своё. В-третьих, аудио перестаёт быть приложением к видео и получает собственную обучающую линию.
Главный вопрос теперь не в том, хватит ли данных, а в том, кто первым научится их чистить. Синтетические подписи, десятки миллионов роликов и неизбежный мусор в выборке делают фильтрацию и оценку качества узким местом всей затеи. Датасет открыт — дальше всё зависит от сообщества.