Зачем вообще раскладывать ошибки конвейера
Оценивать RAG-систему одной цифрой удобно, но почти бесполезно. Сквозная метрика отвечает на вопрос «попал ли ответ в ожидание», а не на вопрос «почему он туда попал или не попал». Между тем RAG — это не монолитный блок, а цепочка: сначала что-то находится в базе, потом система решает, достаточно ли найденного, и только затем генератор пишет текст. Сбой на любом из звеньев даёт одинаково «неправильный» ответ на выходе, хотя причины у двух таких провалов могут быть прямо противоположными.
Именно эту проблему берёт на себя работа The RAT: A Unified Bayesian Model for RAG Evaluation (arXiv:2608.24753, раздел cs.CL, отправлена 25 августа 2026 года). Авторы — Pius von Däniken, Felix Matthias Saaro, Mark Cieliebak и Jan Deriu — предлагают не измерять конвейер целиком, а описать его как вероятностную модель, где каждый этап — отдельная случайная величина со своими связями. Дальше оценка системы превращается в задачу вывода: какие значения скрытых переменных правдоподобнее всего объясняют observed-ответы и разметку.
Что именно моделирует байесовский фреймворк
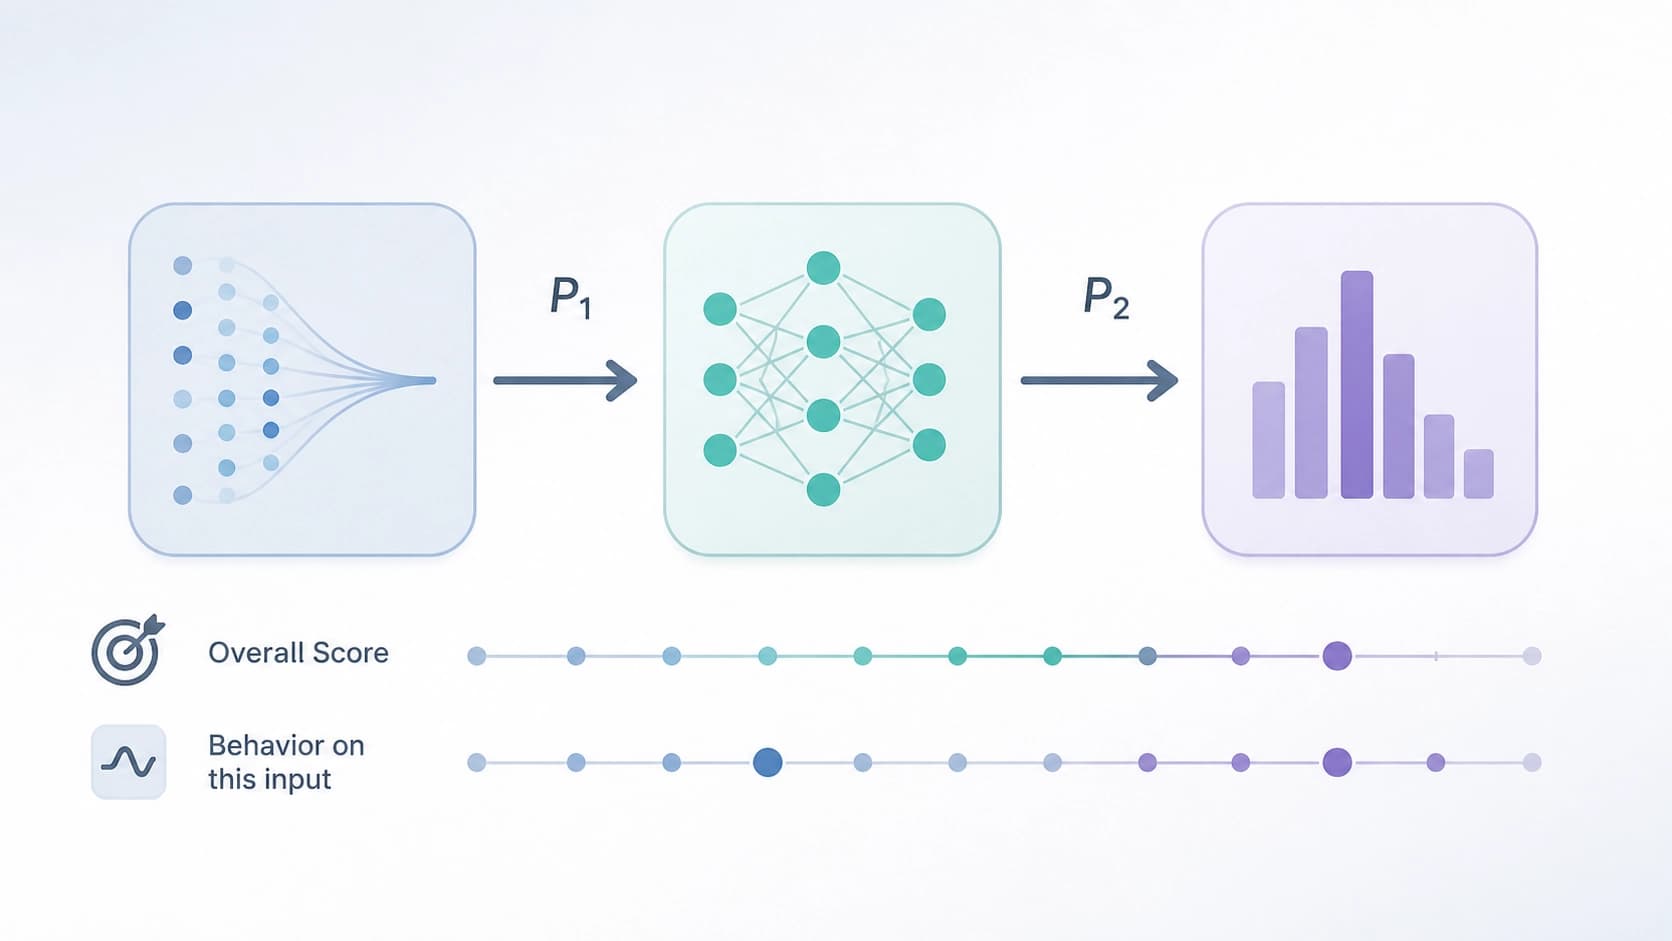
Ключевая идея — факторизация по информационному потоку. Переменные вводятся не «по компонентам пайплайна» механически, а в том порядке, в каком информация реально движется по системе: успех поиска влияет на то, как генератор должен себя вести, а поведение генератора вместе с исходом поиска определяет итоговую корректность ответа. Такая структура делает зависимости явными, а не спрятанными внутри агрегированной оценки.
Так модель The RAT получает три содержательных слоя, которые обычно сливаются в один показатель.
Task success и generator success — это разные вопросы
Первый слой — task success: получил ли пользователь в итоге правильный ответ. Второй — generator success: вёл ли генератор себя подобающе при том, что ему досталось на входе. Формально второе — это условное качество: насколько поведение модели адекватно данному исходу поиска, а не вообще.
Разница принципиальная. Система может выдать верный ответ вопреки плохому поиску — генератор догадался по параметрической памяти. Формально это успех задачи, но поведение при этом было некорректным: система отвечала, не опираясь на источники, и на другом запросе такая привычка обернётся галлюцинацией. И наоборот: поиск нашёл всё нужное, генератор аккуратно ответил — а итог всё равно неверный, потому что вопрос был понят не так. Сквозная метрика эти два случая не различает, условная — различает.
Воздержание — не сбой, а решение
Третий элемент модели — abstention behavior, поведение воздержания. В RAG-контексте отказ от ответа бывает единственно правильной реакцией: если в базе ничего релевантного нет, честное «не знаю» лучше уверенного вымысла. Но тот же отказ становится ошибкой, когда нужный документ был найден, а система им не воспользовалась.
Поэтому воздержание нельзя оценивать в отрыве от исхода поиска — только условно. Модель The RAT учитывает это напрямую: она смотрит, сочетается ли факт отказа или ответа с тем, что реально лежало в контексте. Такой взгляд полезен и для продуктовых решений: если система массово воздерживается при успешном поиске, проблема не в генераторе, а в том, как до него доносится контекст.
Почему маргинальные метрики обманывают
Авторы применили фреймворк к 27 конфигурациям — это три набора данных, три ретривера и три генератора, перебранные во всех сочетаниях. Полный перебор здесь не самоцель: он показывает, как ведёт себя декомпозиция, когда меняется ровно одно звено, а остальные остаются на месте.
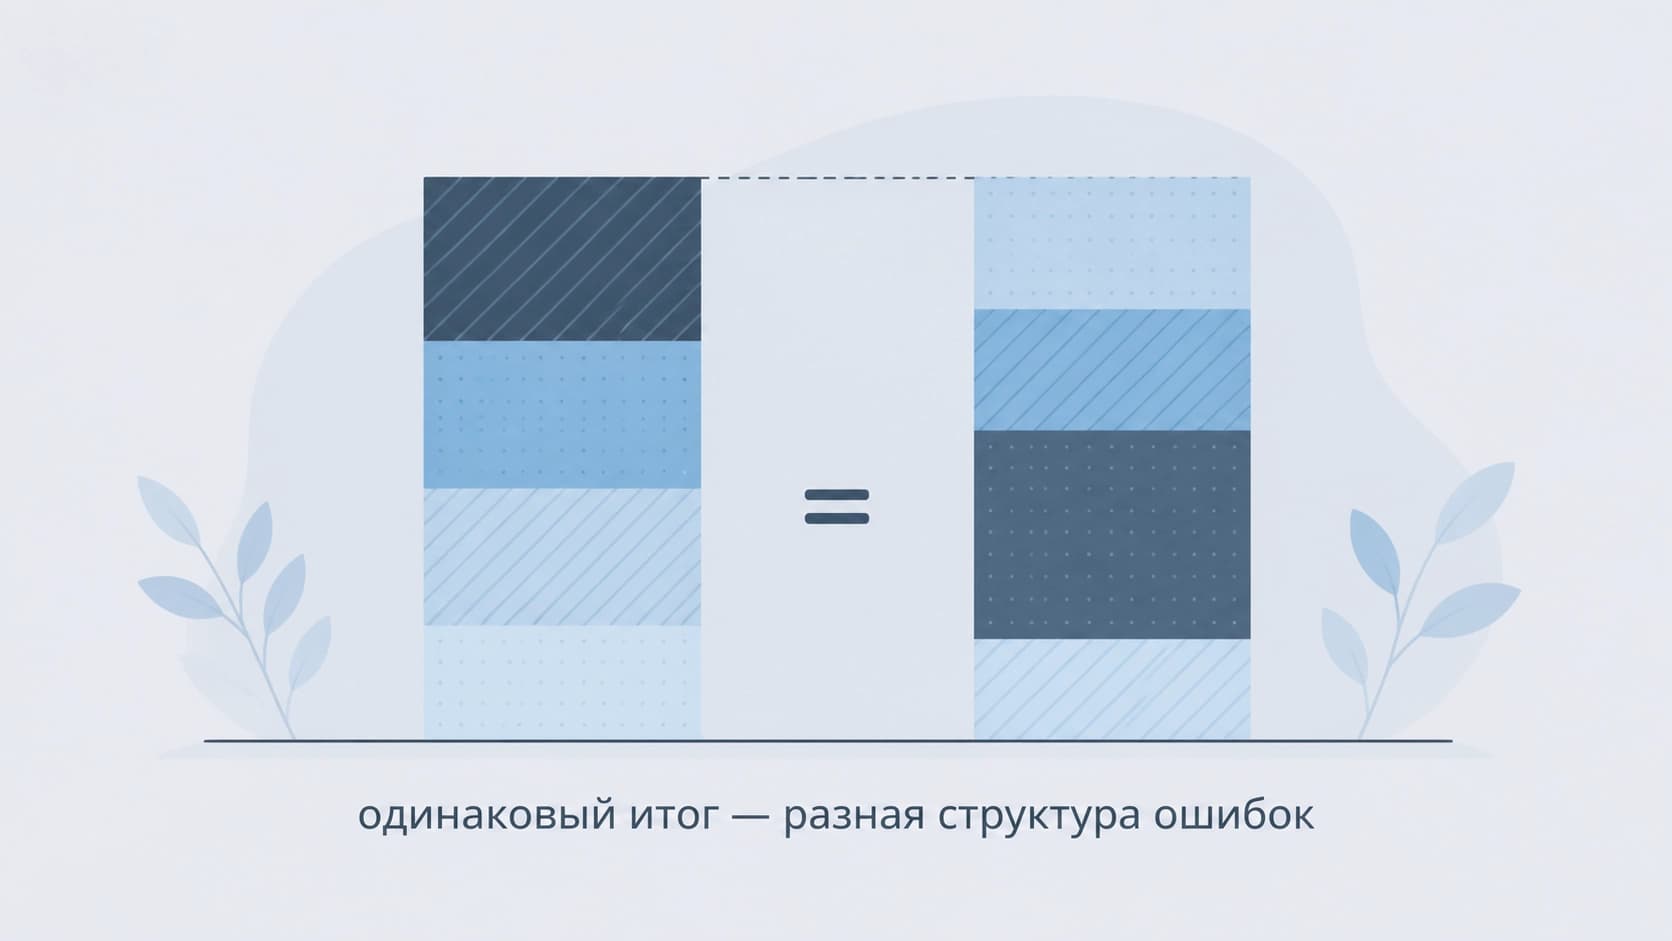
Результат, ради которого всё затевалось: условная декомпозиция выявляет заметные поведенческие различия между системами, которые по маргинальным метрикам выглядят эквивалентными. Два пайплайна могут показывать одинаковую долю правильных ответов и при этом расходиться в десятках процентов случаев по тому, где именно они ошибаются — на поиске, на политике отказа или на генерации. Для того, кто выбирает конфигурацию под продукт, это разные системы; для того, кто смотрит на одну цифру в таблице, — одинаковые.
Куда девать бюджет разметки
Отдельная часть работы посвящена распределению аннотаций. Разметка дорогая, и логично спросить: если людям можно задать только один вопрос про каждый пример, какой вопрос выбрать?
Ответ авторов: аннотации об успехе поиска информативнее аннотаций об успехе задачи, если цель — судить о соблюдении политики системы (policy adherence). Причина не в удобстве, а в структуре модели: разметка поиска ложится на переменную, стоящую в начале причинной цепочки, поэтому от неё «подсвечиваются» и нижележащие слои. Разметка итогового успеха — про переменную на выходе, и она куда меньше говорит о том, что происходило внутри. Авторы дают этому асимметричному эффекту информационно-теоретическое объяснение.
Практический вывод простой: если бюджет ограничен, спрашивать разметчиков стоит не «правильный ли ответ», а «нашлось ли нужное». Первое приятнее звучит в отчёте, второе полезнее для диагностики.
LLM-судья как шумное наблюдение
Третья часть — расширение модели на автоматические оценки. Схема The RAT позволяет подключать вердикты LLM-as-a-judge не как замену человеку, а как калиброванные шумные наблюдения: у судьи своя вероятность ошибиться, и она оценивается в рамках той же вероятностной модели.
Это снимает искусственное противопоставление «дорогая человеческая разметка против дешёвой автоматической». В одной модели можно держать небольшой корпус экспертных суждений, которые задают масштаб и калибровку, и большой поток автоматических оценок, которые уточняют параметры. Судья перестаёт быть оракулом и становится ещё одним источником сигнала — с известной и, что важно, измеримой погрешностью.
Что забрать в свою практику
- Не считайте конвейер одним узлом. Как только в отчёте появляется отдельная метрика для поиска, отдельная для поведения генератора и отдельная для отказа, споры «что сломалось» превращаются в диагностику, а не в перебор гипотез.
- Оценивайте поведение условно. Правильность ответа и уместность поведения при данном контексте — разные вопросы, и хороший итог не оправдывает плохой процесс.
- Стройте отчёт по срезам, а не по среднему. Две системы с одинаковым сквозным качеством могут требовать совершенно разных доработок.
- Выбирайте, что размечать. Если людской ресурс ограничен, разметка ранних этапов даёт больше информации о системе в целом.
- Держите автоматические оценки на поводке. LLM-судья полезен как наблюдение с моделью ошибки, а не как истина в последней инстанции.
Байесовский взгляд здесь ценен не математикой как таковой, а дисциплиной мышления: он заставляет заранее назвать, какие величины скрыты, какие наблюдаемы и как одно связано с другим. После этого любая таблица с результатами перестаёт быть набором цифр и становится описанием того, как система принимает решения.