Что выложили в опенсорс
Разговоры о том, «какая модель лучше», почти всегда упираются в одну проблему: цифры никто не проверял. Замеры делают на другой машине, при другом квантовании, в другой сборке рантайма — и сравнивать их между собой бессмысленно. Компания Liquid AI предложила лечить это открытостью и воспроизводимостью: она выпустила Pipette, платформу для бенчмаркинга фундаментальных моделей на edge-устройствах. Методологию независимо валидировала Artificial Analysis.
Главная мысль, на которой держится вся конструкция: поведение на устройстве — это свойство развёрнутой системы, а не модели в изоляции. Значит, и единицей измерения должна быть не «модель», а полная конфигурация: веса плюс схема квантования плюс среда выполнения плюс конкретное железо. Из этого тезиса вырастает и структура датасета, и то, как следует читать все сравнения ниже.
Что попало в стартовый датасет
- пять метрик производительности на устройстве;
- более тысячи конфигураций в комбинации модель × квантование × среда выполнения × устройство × длина контекста;
- свыше 30 моделей и несколько форматов квантования;
- сборки llama.cpp под macOS, iOS, Windows и Android;
- длины контекста от 256 до 8 192 токенов.
Первые опубликованные замеры сделаны на MacBook Pro с M5 Max, iPhone 17 Pro и Galaxy S26 Ultra. Для AMD Ryzen AI Max+ 395 и Radeon 8060S результаты пока помечены как «coming soon» — то есть платформа изначально заявлена как кроссплатформенная, но покрытие железом ещё растёт.
Четыре вывода из первых прогонов
Одинаковые параметры — разное поведение на длинном контексте
Хорошая иллюстрация того, зачем вообще нужен такой замер. Две модели по 350M параметров при одном и том же Q4_K_M на одном и том же телефоне ведут себя при росте входных токенов по-разному: Granite-4.0-H-350M сохраняет 78,4% пропускной способности декодирования при переходе от 256 к 4 096 входным токенам, а Granite-4.0-350M — только 33,8%. Число параметров здесь не подсказывает ничего: различие лежит в архитектуре и в том, как она ложится на конкретный рантайм и чип.
Разреженная активация экономит вычисления, но не память
LFM2.5-8B-A1B на том же телефоне при 2 048 входных токенах декодирует в 2,4 раза быстрее, чем Qwen3.5-4B, и в 2,6 раза быстрее, чем Ministral-3-3B-Instruct-2512. Секрет — в разреженной активации: на каждый токен задействуется примерно 1,5B из 8,5B параметров. Но пиковое потребление памяти при этом 5,29 GiB, потому что все веса экспертов всё равно должны лежать в памяти целиком. Практический вывод: MoE-подобные архитектуры выигрывают по времени, но не спасают бюджет RAM — а на телефоне лимит часто упирается именно в память.
Быстрее — не значит качественнее
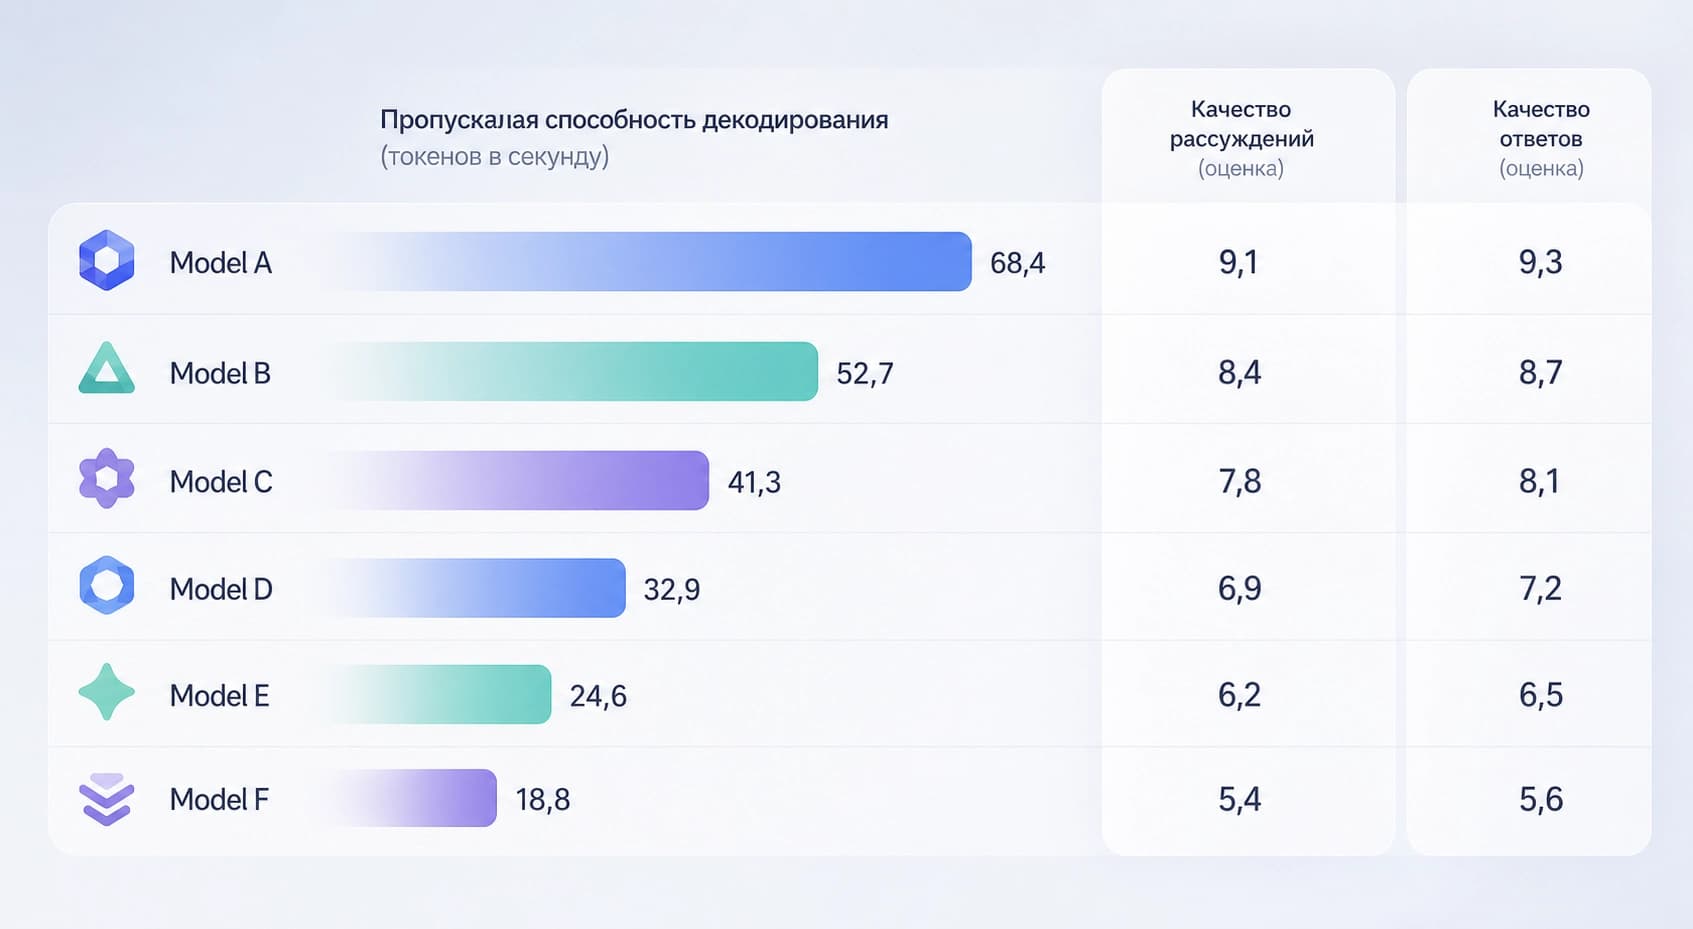
На iPhone 17 Pro при Q4_K_M MiniCPM5-1B выполняет нагрузку 2 048 входных / 256 выходных токенов за 3,47 с, тогда как LFM2.5-1.2B-Instruct — за 4,12 с, то есть первая быстрее на 15,8%. Однако на тех же артефактах LFM набирает на 9,0 пункта больше на MATH-500. Пропускная способность и качество — разные оси, и выбирать модель по одной цифре в таблице бессмысленно.
Почти идентичные профили системы могут скрывать разворот на задачах
На M5 Max при Q4_K_M и 2 048 входных токенах Granite-4.1-8B и Ministral-3-8B-Instruct-2512 расходятся всего на 2,4% по пропускной способности декодирования и на 1,2% по пиковой RAM. Но по задачам картина меняется: Granite выигрывает 7,3 пункта на IFBench, тогда как Ministral опережает его на 14,0 пункта на GPQA Diamond. Разница в «железном» профиле — в пределах шума, разница в поведении — принципиальная.
Как устроены замеры
Прогоны производительности построены на фиксированных формах токенов, жадном декодировании, отбрасываемом прогреве и пяти измеряемых повторениях. Перед каждым повторением срабатывает readiness gating: платформо-специфичная проверка убеждается, что тепловые условия и фоновая нагрузка соответствуют норме. Проваленные прогоны в публикацию не попадают — это как раз то, что отличает воспроизводимый бенчмарк от разового скрипта.
Отдельный сюжет — качество. Оно измеряется не тем же прогоном: для этого используются IFBench, GPQA Diamond и MATH-500, а оценки берутся из запусков оценки llama.cpp на референсных системах с NVIDIA H100 80GB. Дальше они сопоставляются с прогонами на устройстве для той же модели и того же квантования. Важное следствие: число качества, стоящее рядом с пропускной способностью телефона, получено не на телефоне. Это удобная метрика для сравнения моделей между собой, но не измерение того, что происходит на конкретном смартфоне.
Что именно отдают в опенсорс
Pipette поставляется целиком, без листа ожидания:
- инфраструктура под Apache 2.0 — репозитории pipette-mgmt, pipette-clients и pipette-scores;
- публичный датасет результатов;
- хостируемый дашборд;
- нативные приложения для бенчмаркинга на iOS и Android.
Единственная часть, которая ещё не готова к общему доступу, — публикация результатов, присылаемых сообществом: она в бете. Всё остальное можно запускать самостоятельно, включая развёртывание конвейера внутри своего периметра.
Кому и зачем это нужно
Проще всего описать целевую аудиторию так: это любая команда, которая выпускает модель на оборудование, которым сама не владеет. Дальше варианты расходятся по масштабу.
- Соло-разработчику и стартапу на seed-стадии хватит дашборда и мобильных приложений — своя инфраструктура не нужна.
- Продуктовая команда среднего размера может развернуть клиенты на внутреннем парке устройств и получить замеры на своей конфигурации.
- Крупные OEM, производители чипов и предприятия могут держать весь конвейер за файрволом — что снимает вопросы о том, куда уходят данные замеров.
Типовые задачи тоже понятны без лишних объяснений: выбрать модель и формат квантования до того, как задачи спринта зафиксированы; обосновать закупку SoC или оборудования; отловить регрессию при обновлении рантайма, ОС или драйвера; спланировать ёмкость по длине контекста; независимо проверить рекламные обещания вендоров. Отрасли — потребительская электроника и смартфонные OEM, автомобильная сфера, промышленность и робототехника, медицинские устройства, финансовые услуги, оборона: везде, где латентность, приватность или отсутствие связи вынуждают считать модель прямо на устройстве.
На что смотреть, прежде чем доверять цифрам
Три вещи, о которых легко забыть при чтении любой таблицы с замеров.
Во-первых, цифры качества и цифры производительности приходят из разных мест. Пропускная способность измерена на устройстве, качество — на референсной системе с H100 и затем сопоставлено. Для сравнения моделей это корректно, для прогноза поведения в конкретном приложении — нет.
Во-вторых, квантование нельзя вынести за скобки. Один и тот же формат на разных моделях и разных рантаймах даёт разный результат, а ограничение по памяти часто становится решающим — как в примере с разреженной активацией, где скорость выросла, а 5,29 GiB никуда не делись.
В-третьих, одинаковая производительность ничего не говорит о том, как модели отработают конкретные задачи. Разворот Granite и Ministral на IFBench и GPQA Diamond при почти идентичных профилях системы — ровно тот случай, когда сначала надо определиться с задачей и только потом смотреть на таблицы.