Зачем агентам понадобился ещё один замер
Большинство агентных бенчмарков отвечают на понятные вопросы: верный ли инструмент выбрала модель, правильно ли собрала аргументы, дошла ли до нужного результата. Почти все такие замеры построены вокруг последовательного исполнения — один вызов за другим, без спешки и конкуренции за ресурсы.
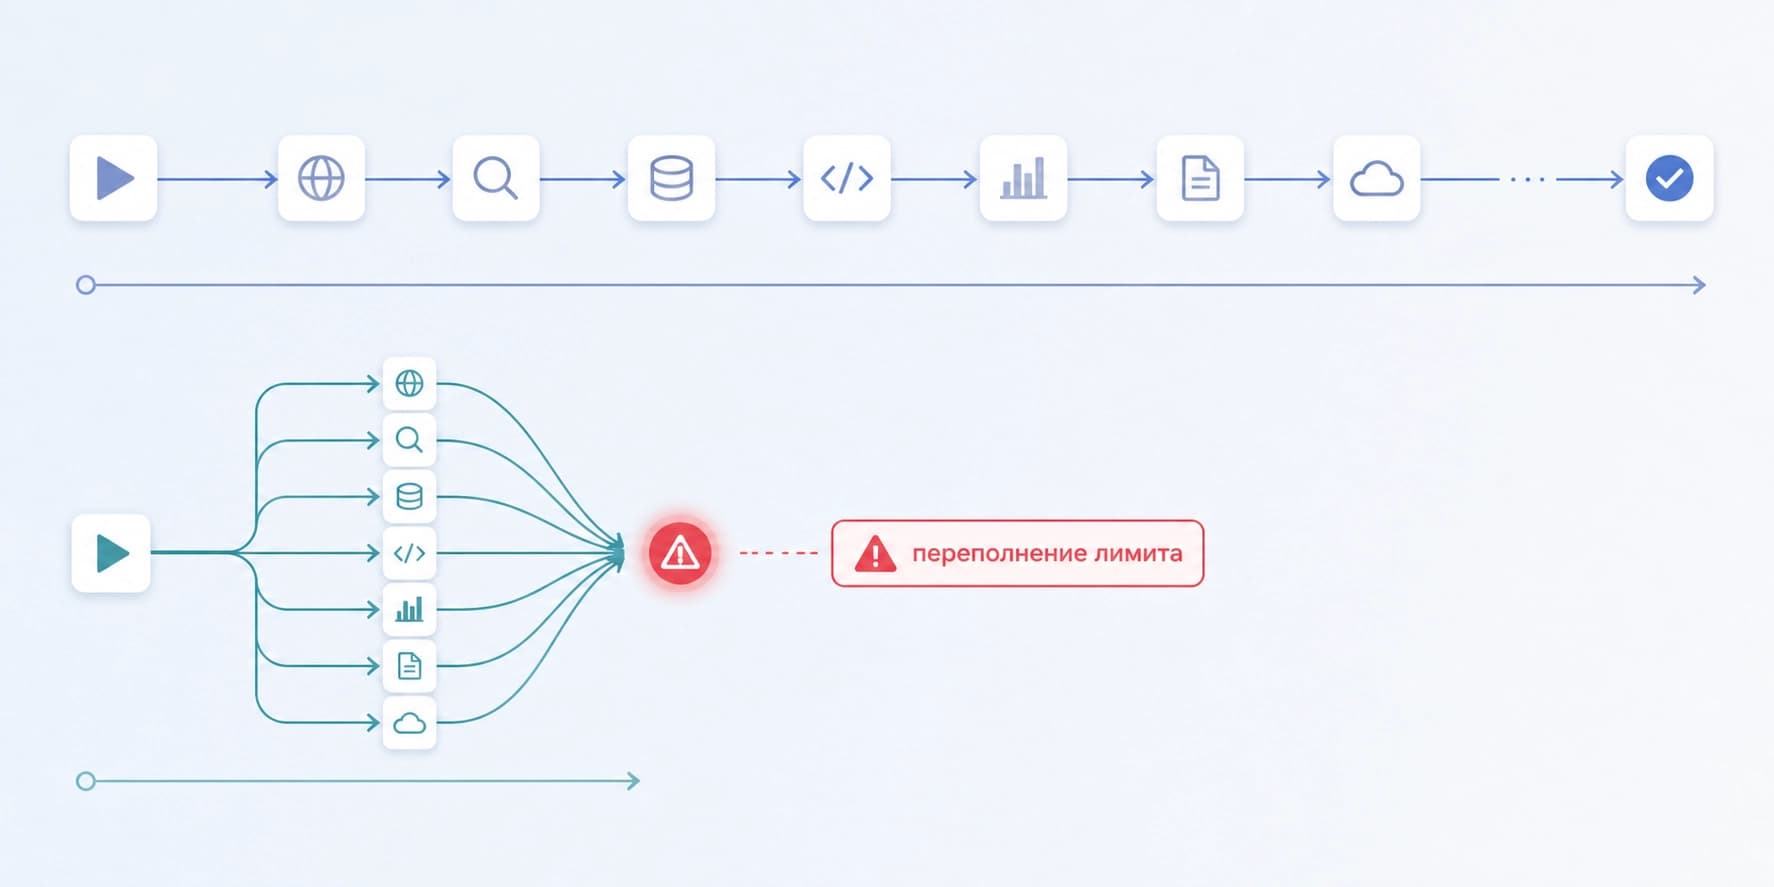
Эксплуатация выглядит иначе. Чтобы уложиться в приемлемую задержку, агенту приходится запускать независимые вызовы параллельно. Но параллелизм без оглядки на лимиты упирается в другую стену: исчерпанные квоты, переполненная память, отвалившийся внешний сервис.
PeakBench — как раз про эту слепую зону. Авторы Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan и Han-Jia Ye описывают её в препринте arXiv:2608.24509 (v1 от 25 августа 2026, категории cs.AI и cs.SE); код обещают выложить вместе со статьёй.
Ключевая мысль, из которой растёт вся работа: у агента есть два способа провалиться, и они противоположны. Последовательное исполнение безопасно, но медленно — лимиты не превышаются просто потому, что ничего не делается одновременно. Параллельное без учёта ресурсов быстрое, но приводит к переполнениям, которых легко было избежать. Между этими полюсами и находится то, что никто толком не измерял.
Что представляет собой бенчмарк
Вместо статичных задач с эталонными ответами здесь используются исполняемые многоинструментные рабочие процессы. У каждого есть две важные пристройки: аннотации зависимостей, показывающие, какие шаги действительно связаны между собой, и измеренные профили ресурсов — сколько памяти, времени или квоты съедает конкретный вызов.
Такая конструкция меняет сам предмет оценки. Вопрос «получился ли правильный ответ» отходит на второй план, а на первый выходит вопрос «как агент разложил работу во времени и не вышел ли он за бюджет».
Логическое планирование против физического
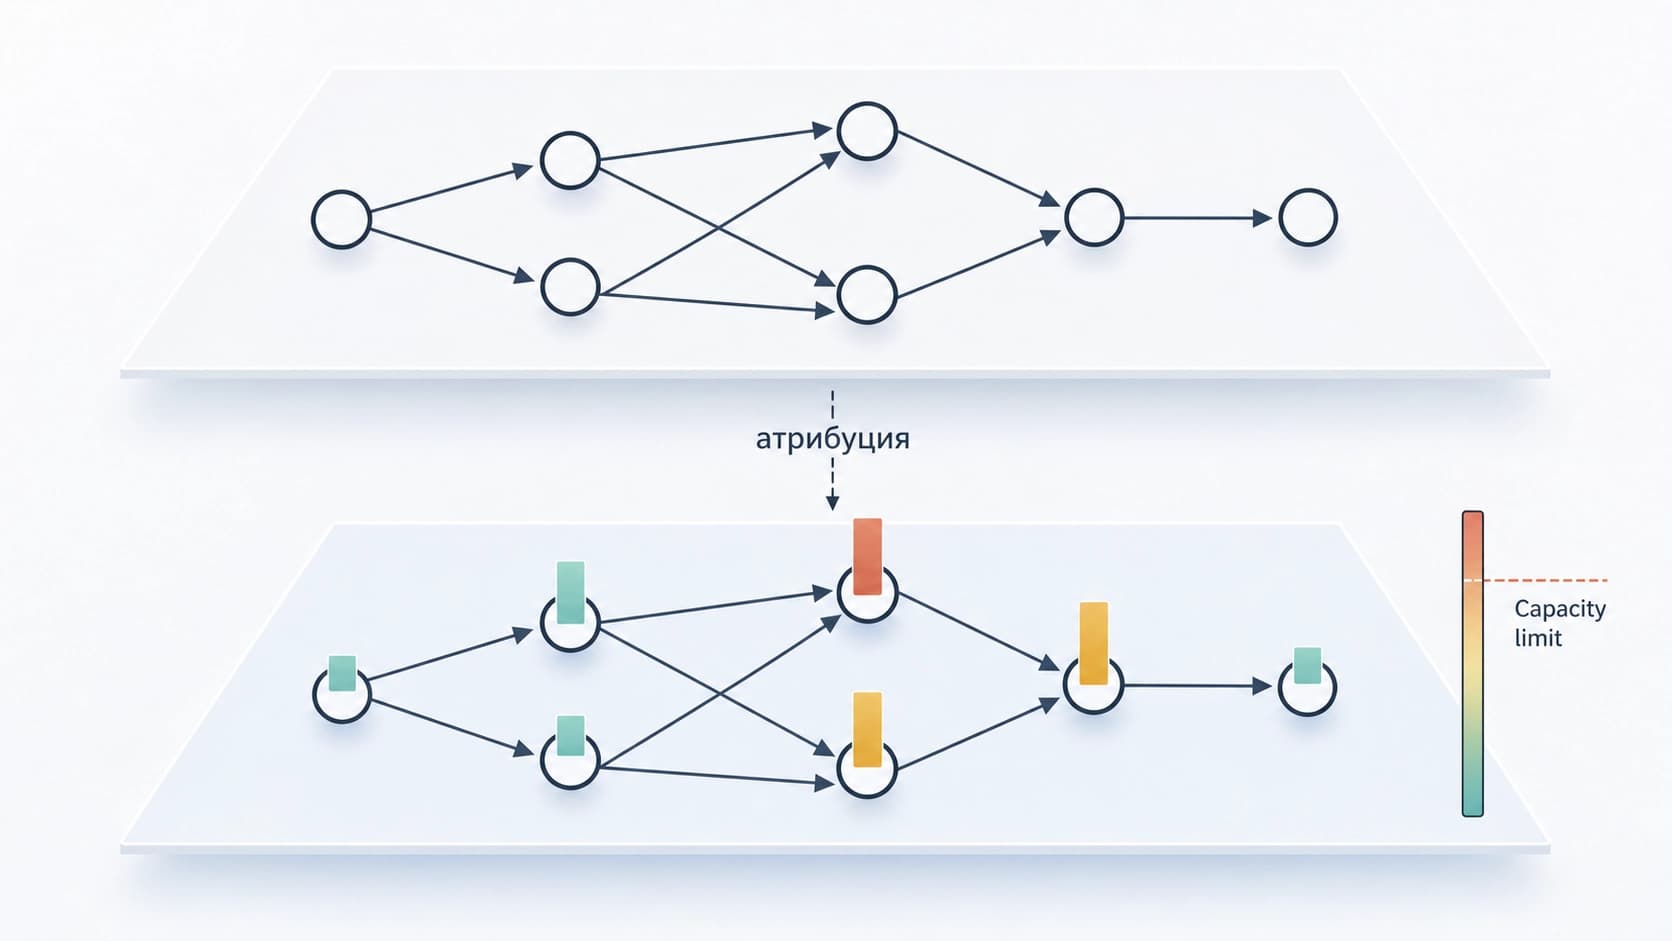
Центральная сложность при оценке подобных процессов — атрибуция. Когда прогон развалился, неясно, что именно виновато: агент неверно разобрал зависимости, или разобрал верно, но не посчитал доступные ресурсы, или и то и другое сразу. Свалить всё в одну метрику успеха — значит потерять самое полезное.
Поэтому оценка разделена на две части. Одно измерение отвечает за логическое планирование: порядок шагов, корректность зависимостей, отсутствие выдуманных связей. Другое — за физическое планирование, то есть за расписание с учётом реальных ограничений. Метрики у этих измерений свои, иFailure в одном не маскирует успех в другом.
Неверный порядок и неверный бюджет — разные болезни
Двухчастная схема нужна не ради красивой таксономии, а ради диагностики. Если агент ошибся на уровне логики, ему бесполезно рассказывать про размер квоты — он не понял, что от чего зависит. Если логика в порядке, а исполнение падает, проблема в планировщике или в том, как агенту сообщили о доступных ресурсах.
Практический вывод для тех, кто делает агентные системы: прежде чем что-то чинить, стоит понять, к какому из двух слоёв относится сбой. Промпт-инжиниринг, обучение на траекториях и правка инструментов будут лечить совершенно разные поломки.
Главный результат: аккуратная логика не спасает от перегрузки
Самый неприятный из выводов работы звучит так: сильное логическое планирование не гарантирует ни безопасного, ни эффективного исполнения в условиях ресурсных ограничений. Агент может безупречно выстроить граф зависимостей — и всё равно уронить систему, запустив разом всё, что не связано рёбрами.
Раскрытие ресурсов снижает число preventable-переполнений
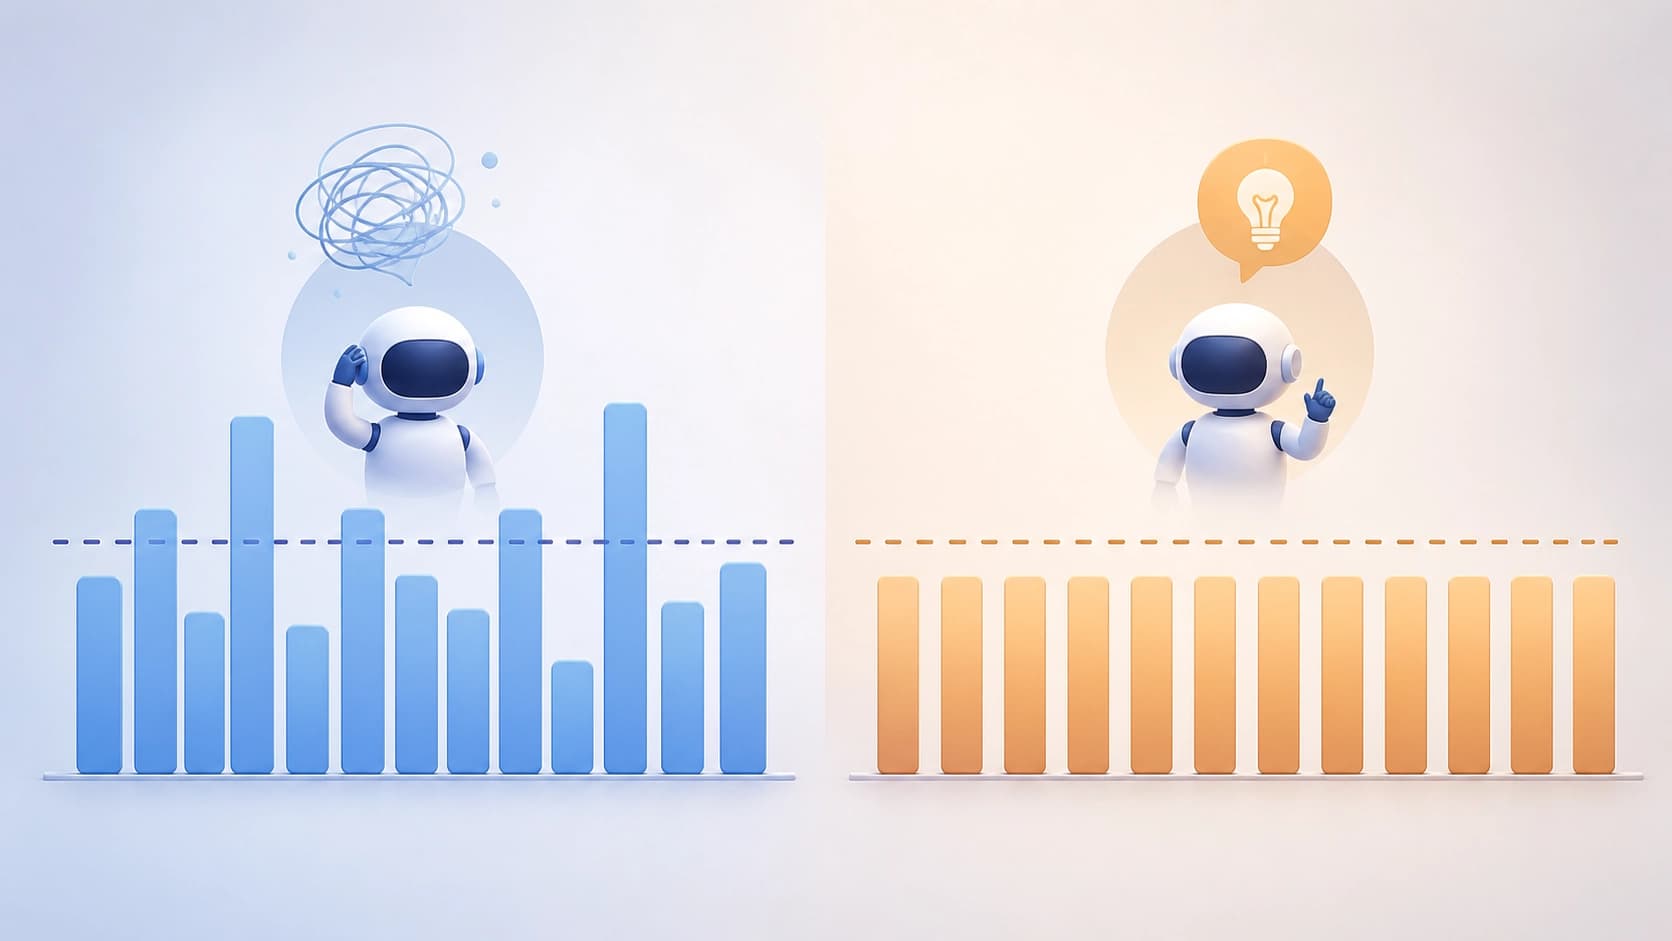
Второе наблюдение: если дать агенту информацию о доступных ресурсах, количество предотвратимых переполнений падает, а утилизация растёт. Это не магия и не новая архитектура — просто в контекст попадают не только описания инструментов, но и бюджеты, в которые нужно уложиться.
Здесь важно не переоценить эффект. Речь о том, что прозрачность по ресурсам — дешёвое и рабочее вмешательство, а не о том, что оно решает проблему целиком: агент всё ещё должен распорядиться этой информацией грамотно.
Кому это пригодится
Бенчмарк задуман как стенд для диагностики ресурсо-осведомлённого поведения агентов, и это его главное назначение. Он не столько выдаёт финальный балл, сколько показывает, где именно у модели рвётся: на понимании зависимостей или на дисциплине расходов.
Отсюда несколько сценариев использования. Разработчикам агентных фреймворков — способ проверить планировщик до продакшена, а не после инцидента. Исследователям — воспроизводимая постановка для экспериментов с бюджетами в контексте. Тем, кто выбирает модель под задачу с жёсткими лимитами, — возможность увидеть разницу между моделями, которую обычные тесты на успешность просто не показывают.
Что стоит держать в голове
У подхода есть очевидная цена входа: профили ресурсов нужно измерять, а зависимости — размечать. В реальных системах лимиты шумят, внешние сервисы меняют поведение под нагрузкой, а стоимость вызова не всегда известна заранее. Лабораторная аккуратность здесь выше, чем в бою, и переносить выводы один в один на прод не стоит.
Но сама рамка полезна и без бенчмарка. Два вопроса — «правильно ли агент понял, что от чего зависит» и «уложился ли он в бюджет» — разумно задавать к любой агентной системе, даже если под рукой нет готового стенда для их проверки.