Скалярное произведение как узкое место
Почти все современные архитектуры внимания устроены одинаково: запрос и ключ сопоставляются через скалярное произведение (или его нормированную версию), результат превращается в веса, а выход собирается как взвешенная сумма значений. Приём универсальный, но у него есть цена — геометрия признакового пространства в такой схеме задаётся жёстко: сходство измеряется «по прямой», без учёта того, что разные направления в пространстве могут иметь разную значимость и разный масштаб.
Именно на это ограничение нацелена работа arXiv:2608.24462 «Mahalanobis-Based Multi-Head Attention for Complex State Propagation» (автор — Xiaohe Li; раздел cs.AI). Вместо привычного произведения в ней используется RBF-ядро, построенное на расстоянии Махаланобиса. Проще говоря, сходство между элементами последовательности считается не «в лоб», а с поправкой на ковариационную структуру данных — как если бы пространство перед сравнением слегка растянули и повернули так, чтобы коррелирующие направления не считались независимыми.
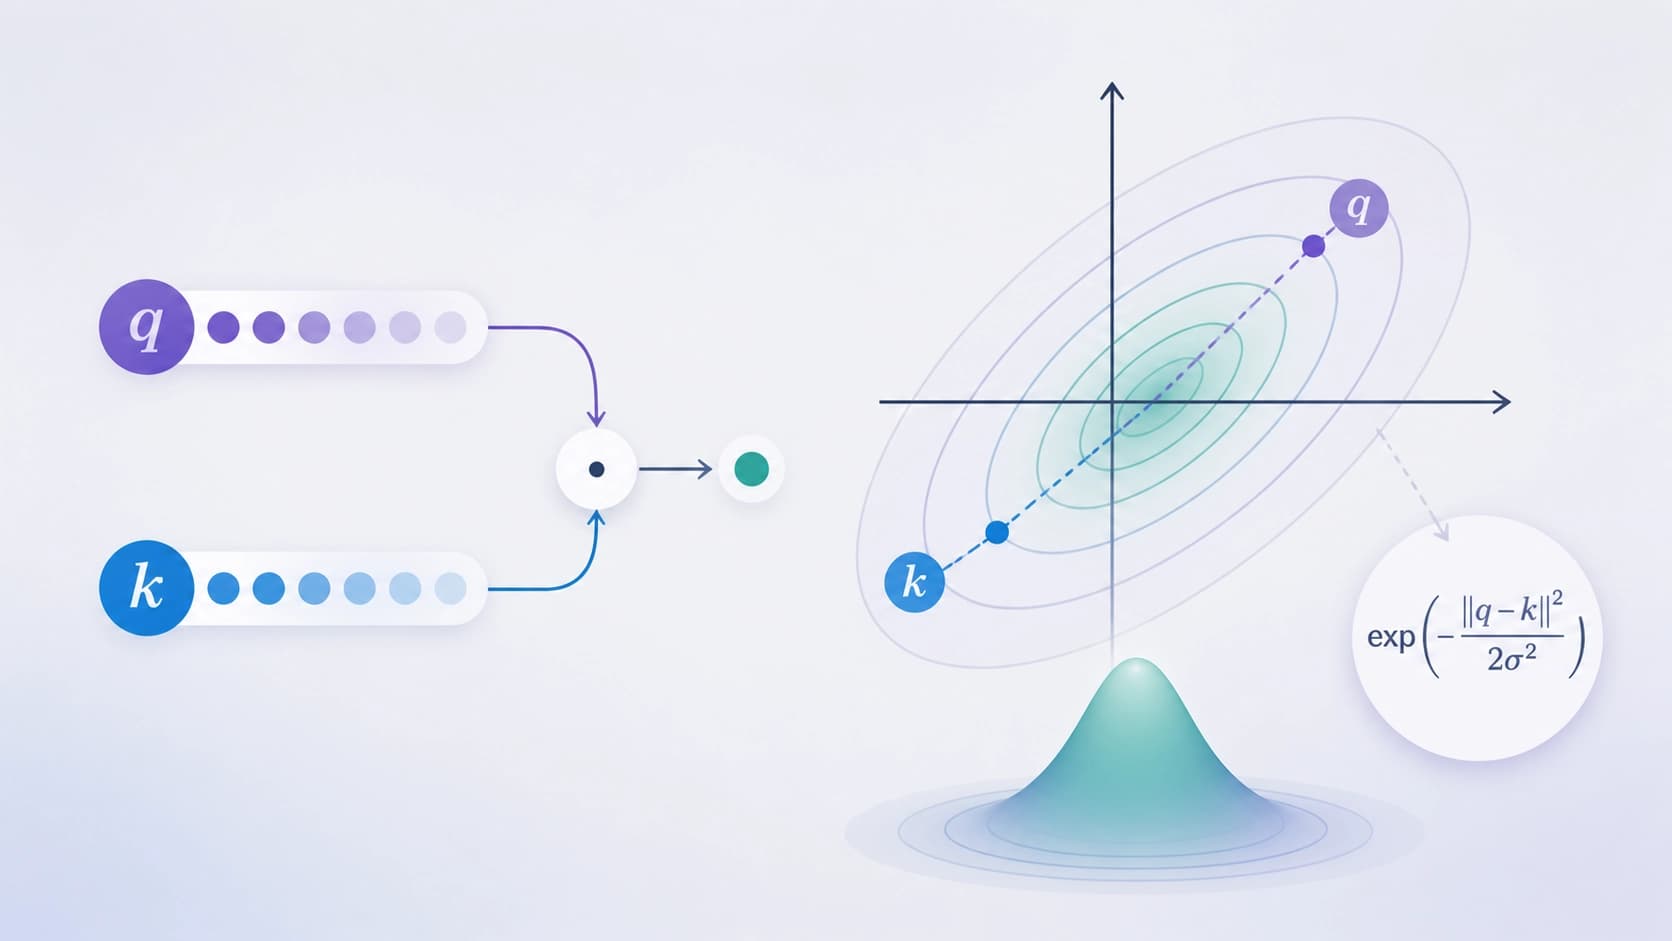
Что даёт расстояние Махаланобиса
Внимание в бесконечномерном пространстве без роста параметров
Ключевое утверждение автора: RBF-ядро над расстоянием Махаланобиса позволяет вычислять внимание так, будто оно живёт в бесконечномерном признаковом пространстве, но при этом число обучаемых параметров не растёт. Это не магия, а следствие того, что ядро уже само по себе задаёт нелинейное отображение — отдельный слой для разворачивания признаков не нужен. Для практики это означает более скромные требования к памяти и оптимизации, что в эпоху гигантских моделей выглядит почти вызывающе.
Положительная определённость и Tree Attention
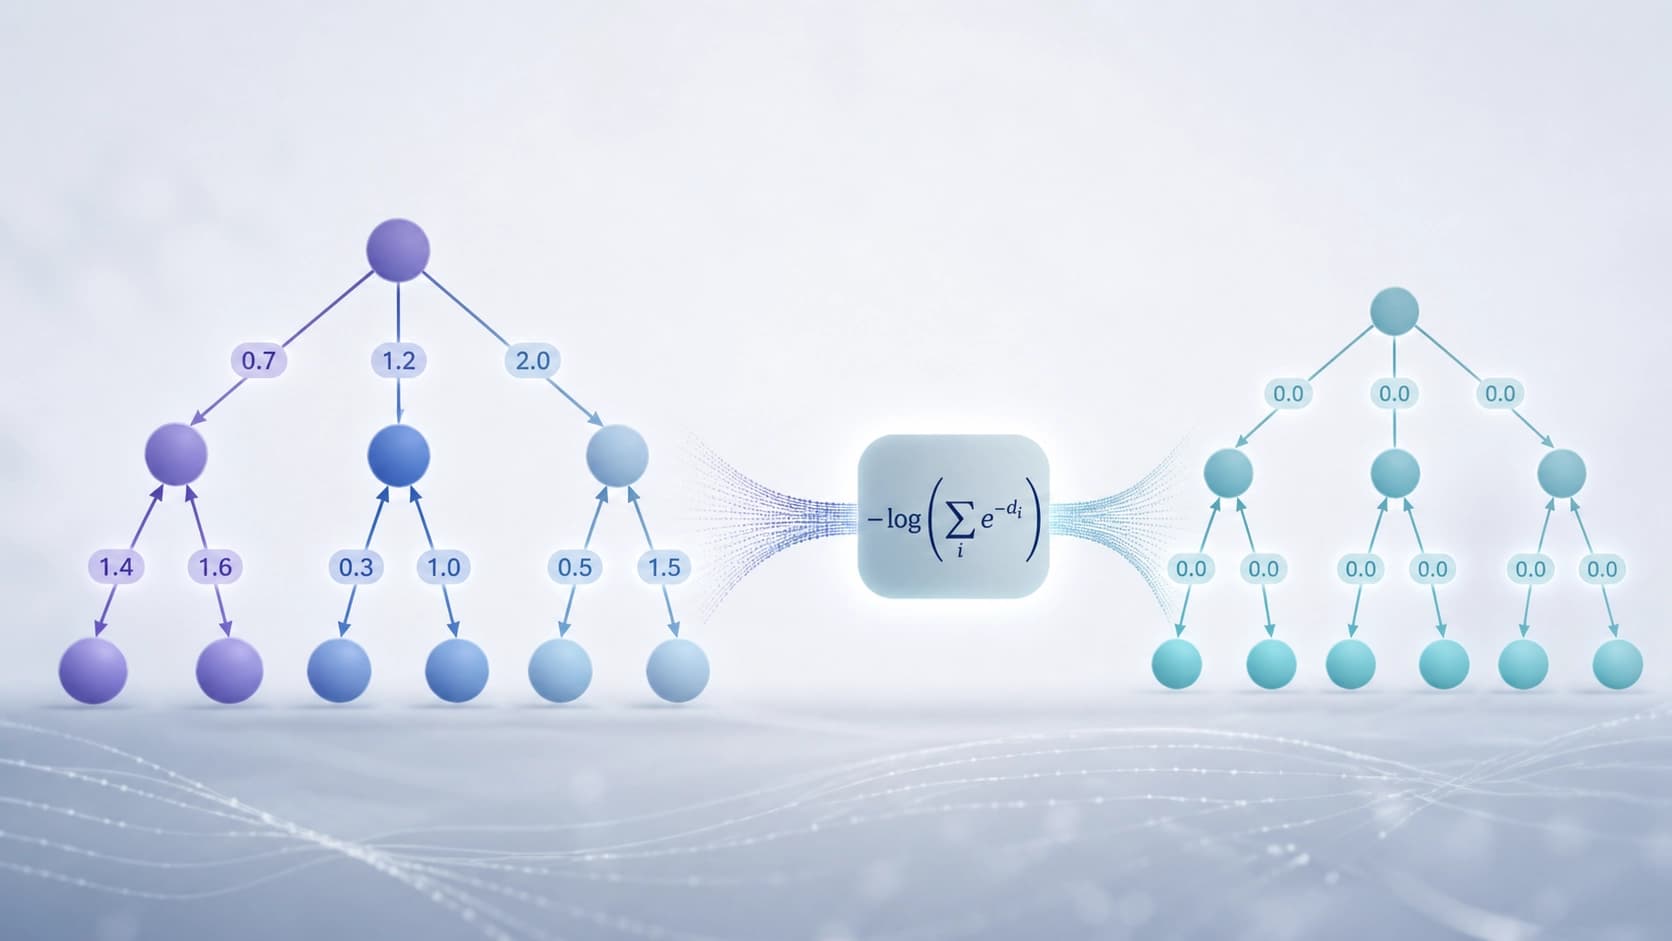
Второй слой идеи опирается на математическое свойство расстояния Махаланобиса: оно положительно определено. Из этого можно напрямую строить то, что в статье называется Tree Attention — оценки внимания конструируются не из «сырых» похожестей, а из накопленных по дереву расстояний. Чтобы такие накопления не разъезжались численно, применяется коррекция через LogSumExp: из расстояния вычитается логарифм суммы экспонент по рёбрам. По сути, это способ согласовать вклады разных путей в дереве, не потеряв их относительный вес.
Для читателя, не знакомого с деталями, полезная аналогия такая: вместо того чтобы складывать «похожести» как попало, модель аккуратно нормирует их по мере продвижения вглубь структуры. Это ближе к бухгалтерии, чем к интуиции, — но именно такая аккуратность позволяет рассуждению оставаться устойчивым на длинных цепочках зависимостей.
Attention meshing: головы начинают разговаривать друг с другом
Обычно многоголовое внимание устроено как набор почти независимых экспертов: каждая голова считает своё, а смешивание происходит только на выходе, линейной проекцией. В MHA-CSP матрицы расстояний Махаланобиса переиспользуются повторно — на их основе строится механизм «attention meshing», который заставляет ядра разных голов взаимодействовать напрямую. Автор заявляет двойную выгоду: и точность выше, и обучение идёт эффективнее, поскольку одна и та же вычислительная работа не дублируется.
Эксперименты: 119K параметров против больших базовых моделей
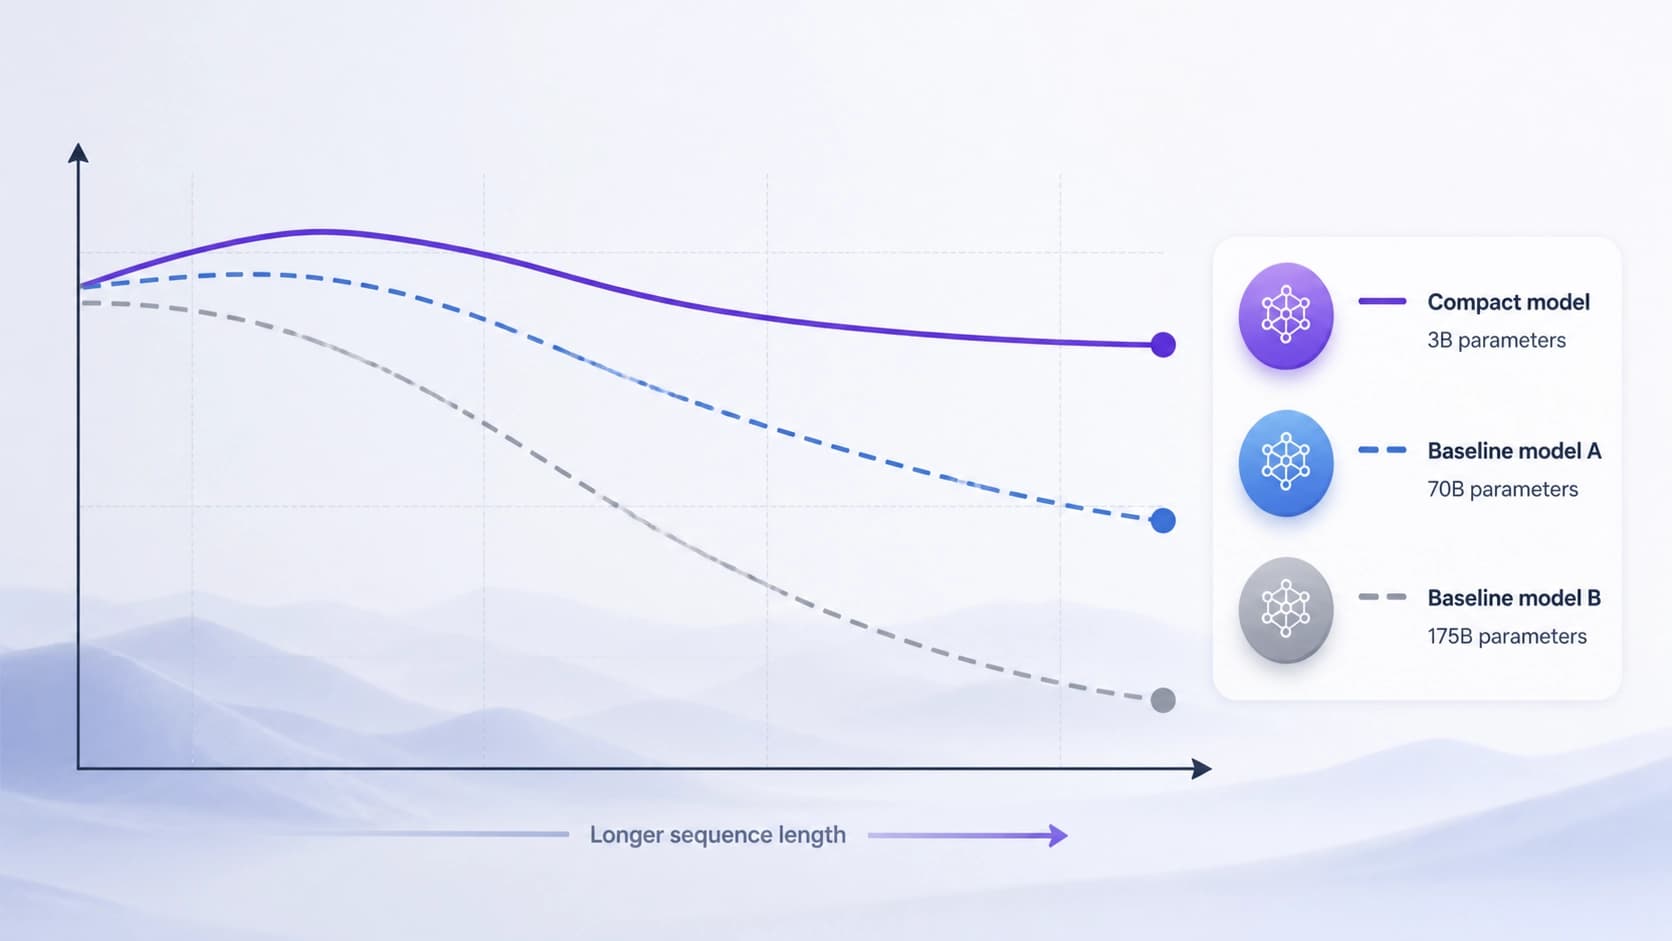
Самая громкая часть работы — сравнение. MHA-CSP с всего 119 тысячами параметров сопоставляется с базовыми трансформерами и графовыми свёрточными сетями, обученными с нуля в идентичных условиях. Задача — отслеживание состояний на длинных последовательностях. Причём teacher forcing применялся исключительно на финальном скрытом состоянии, то есть модель не получала подсказок на каждом шаге, как это часто делают при обучении поучительнее.
По заявлению автора, MHA-CSP стабильно обходит конкурентов. Базовые модели при этом опираются либо на плотное внимание (трансформер), либо на распространение информации по графу (GCN), тогда как MHA-CSP добивается структурированного рассуждения за счёт синтетической коррекции расстояний и экономного обхода информации, унаследованного от backbone CSP.
Стоит подчеркнуть: речь не о том, что маленькая модель «догоняет» большие на всём подряд. Речь о конкретном классе задач — длинные последовательности с внутренней символьной структурой, где важно не просто запомнить контекст, а удержать его состояние. Именно там геометрия расстояний и древовидная нормировка начинают работать.
Что это меняет на практике
Главный вывод работы формулируется так: комплекснозначное распространение состояний (complex-valued state propagation) в сочетании с совместной многоголовой коррекцией оказывается рабочим инструментом для улавливания символьных структур. И задаёт новый компромисс между эффективностью и качеством для задач структурированного рассуждения.
Если смотреть шире, здесь прослеживается тенденция последних лет: вместо того чтобы наращивать параметры, исследователи ищут более удачные индуктивные смещения — то есть закладывают в архитектуру правильные допущения о природе данных. Скалярное произведение было удобным, но довольно грубым допущением. Замена его на ядро с ковариационной метрикой — попытка сказать модели: «не все направления в пространстве равны, учитывай это с самого начала».
Осторожный взгляд со стороны
Есть причины не бросаться переписывать пайплайны. Во-первых, результаты получены на конкретном наборе задач отслеживания состояний; переносить их на генерацию текста, мультимодальность или диалоговые сценарии без отдельной проверки не стоит — в абстракте таких экспериментов нет. Во-вторых, единственный автор и первая версия препринта (v1, подана 25 августа 2026 года) означают, что независимой репликации мы пока не увидели: файл размером 377 КБ доступен в PDF, HTML и TeX-исходниках, но воспроизведение — отдельная история.
И всё же направление выглядит продуктивным. Уход от скалярного произведения, прямая работа с геометрией расстояний, переиспользование вычислений между головами — это ровно те ходы, которые снижают стоимость модели, не жертвуя выразительностью. Если результаты подтвердятся на других доменах, у «маленьких, но правильно устроенных» сетей появится ещё один весомый аргумент.