Товар не сводится к одной точке в пространстве
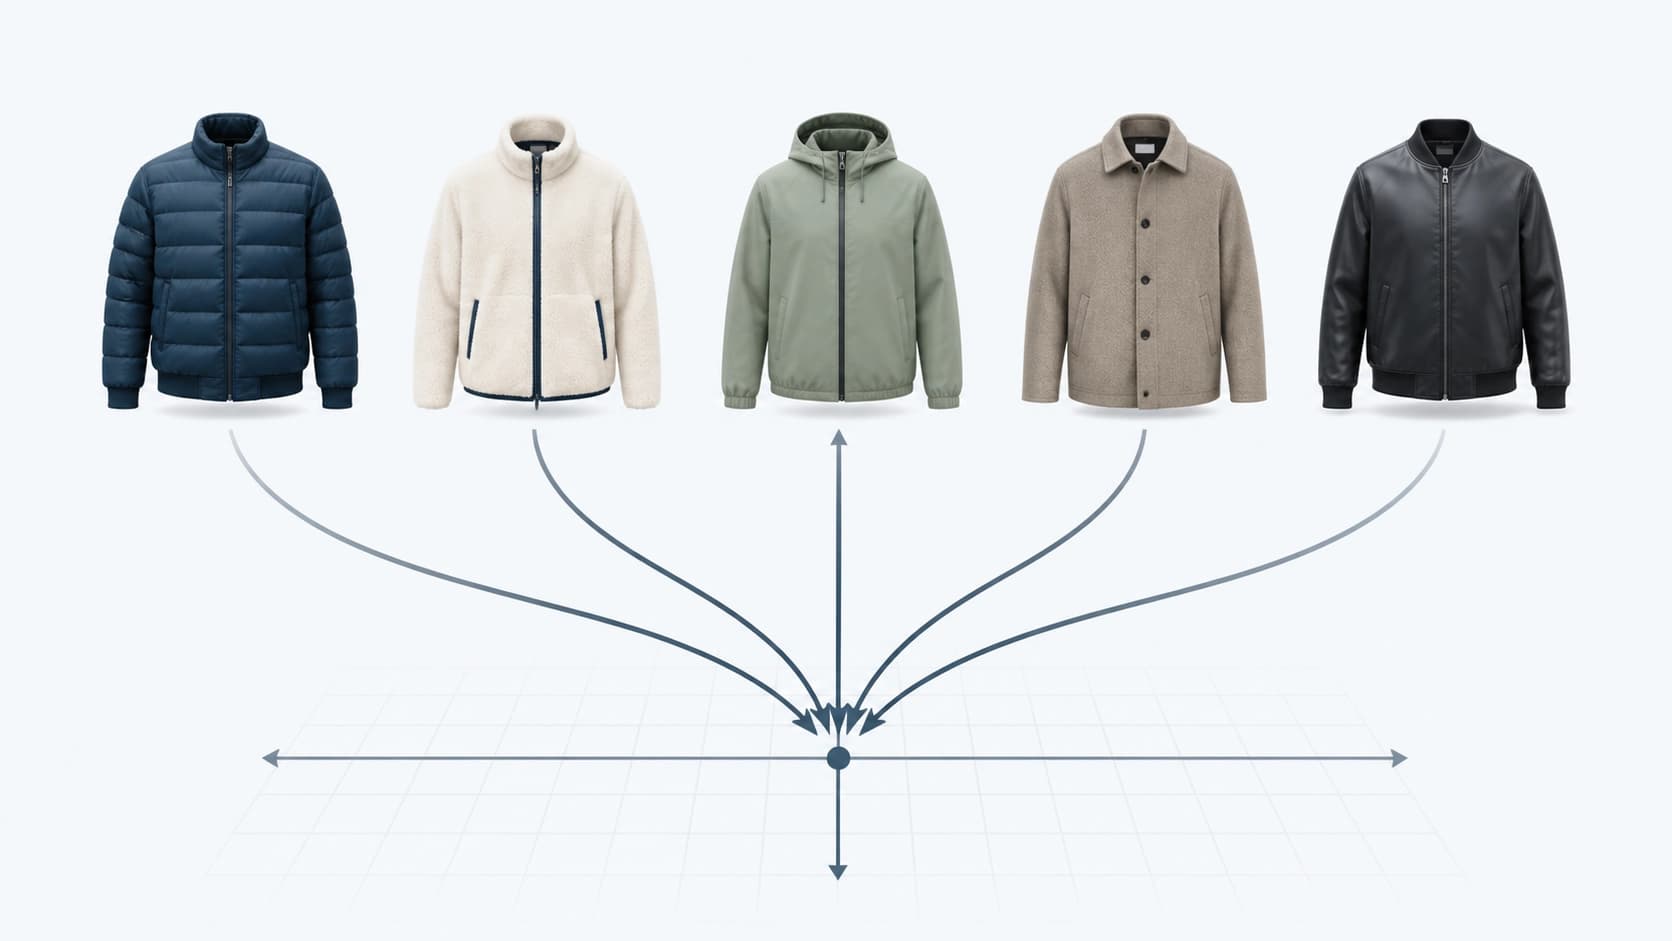
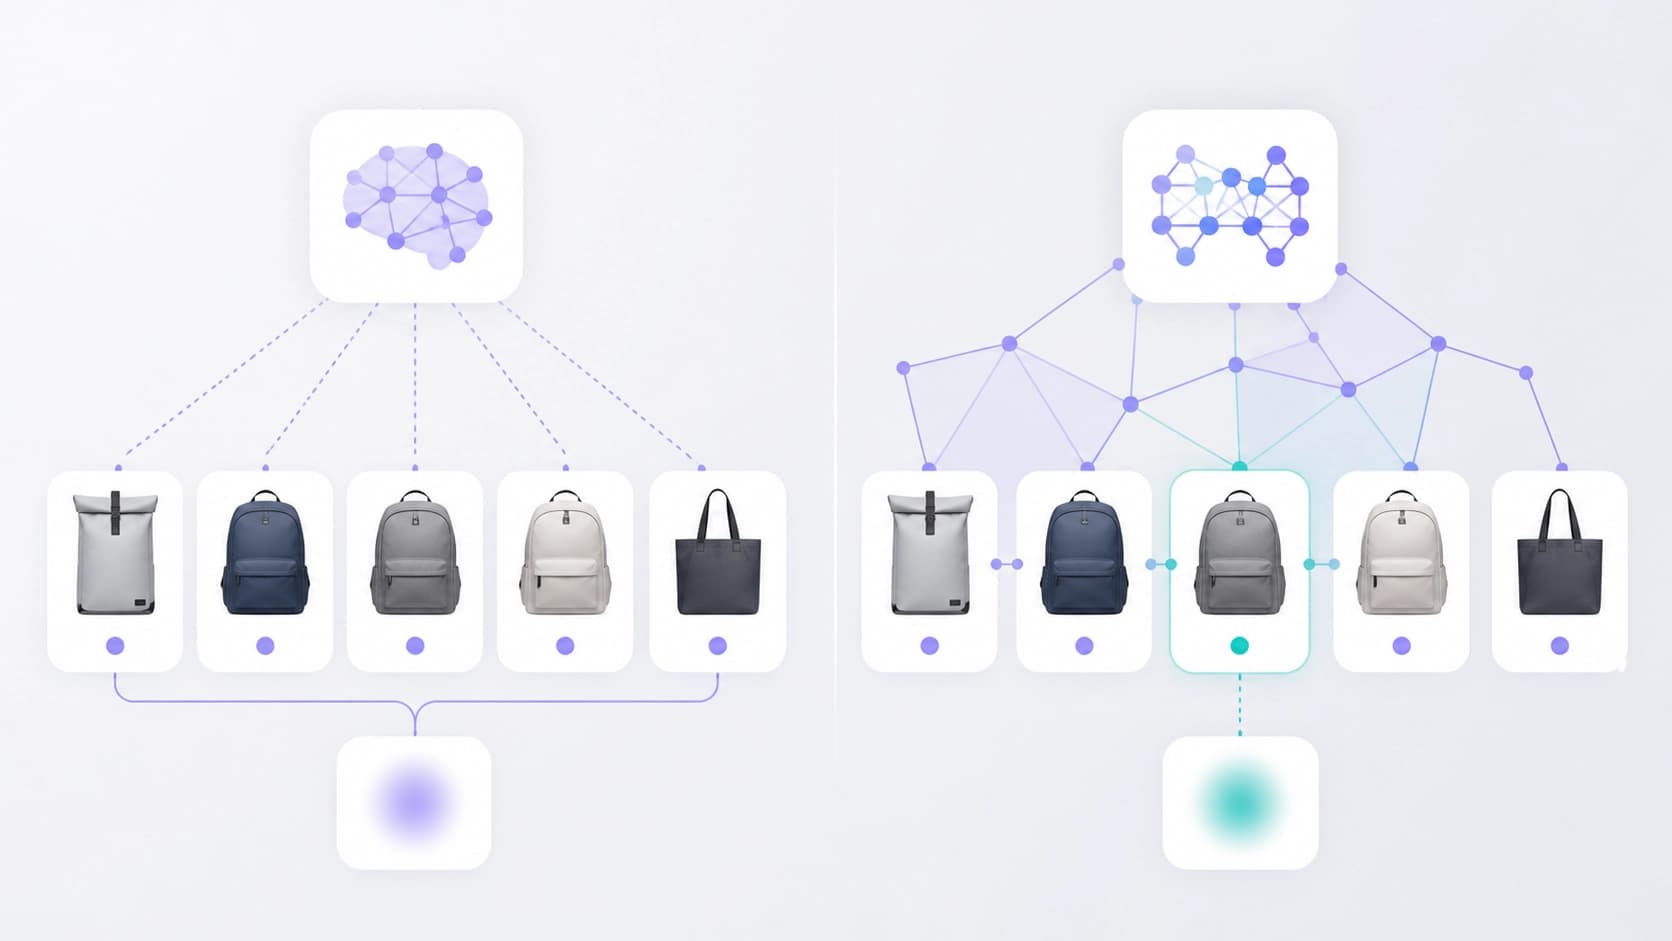
Мультимодальные большие языковые модели научились довольно неплохо «понимать» карточки товаров: они связывают фотографию, название и описание в единое смысловое поле. Но у этой схемы есть скрытая издержка. Информация о товаре сжимается в один глобальный эмбеддинг — усреднённый вектор, где растворяются детали. Чем больше модель старается охватить сразу всё, тем меньше в итоговом векторе остаётся от конкретики.
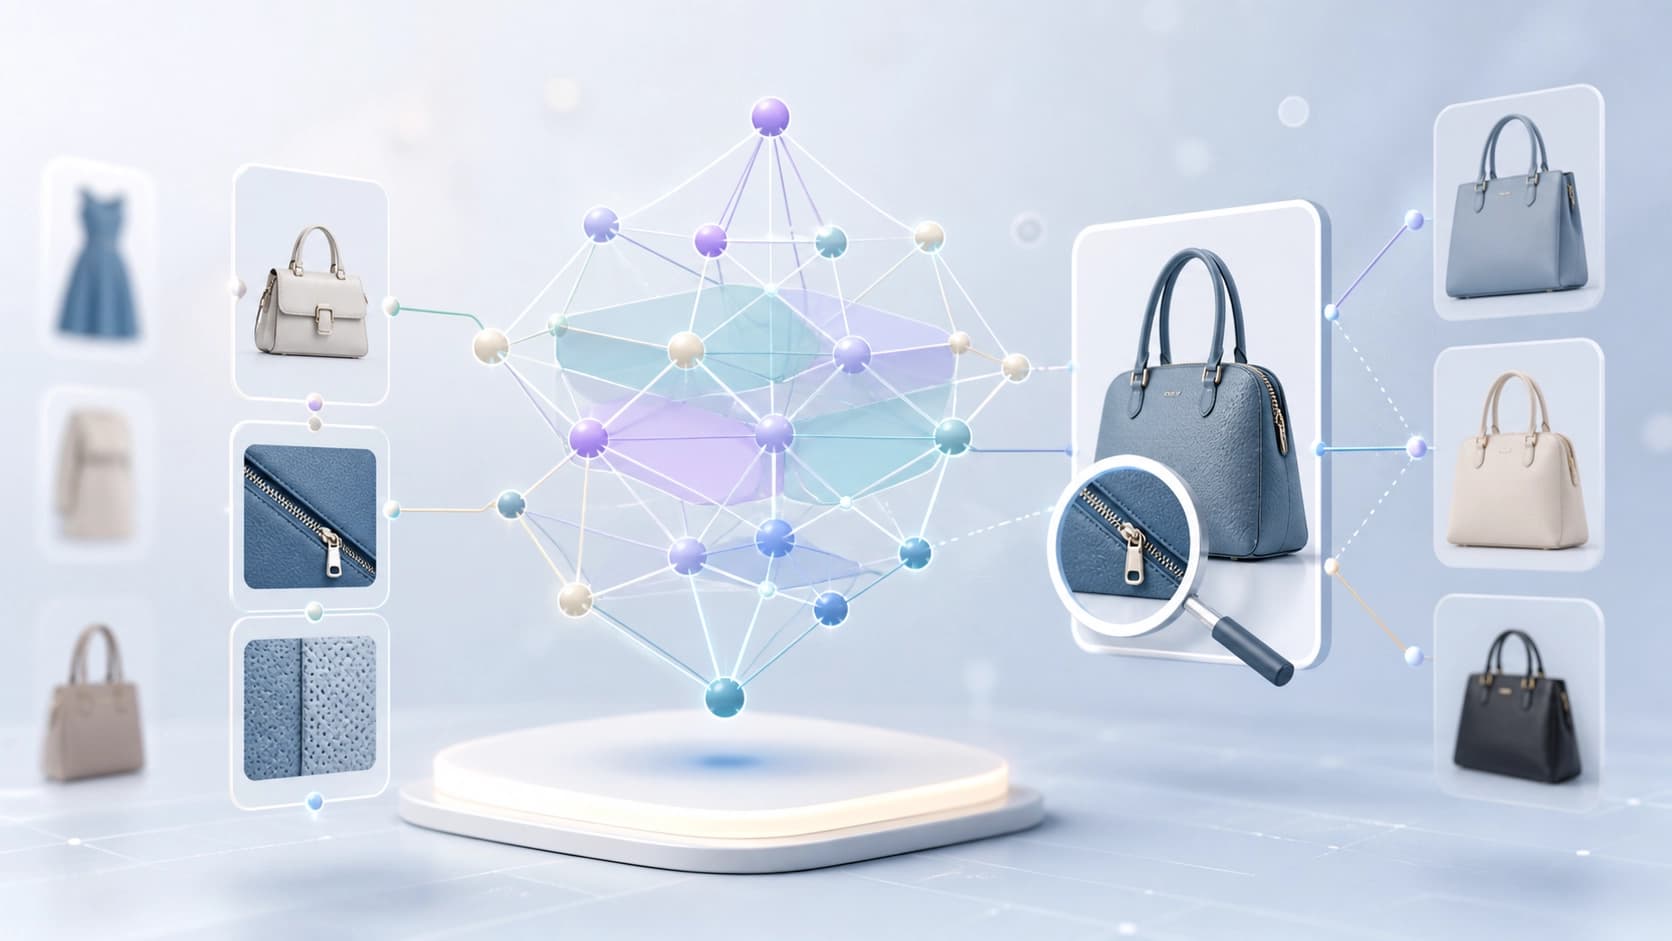
Цена такой компактности видна на задачах, где важны именно мелочи. Две куртки из разных материалов, две кружки с почти одинаковой глазурью, два кабеля с разными разъёмами — визуально они почти близнецы, и в пространстве эмбеддингов оказываются почти в одной точке. Пользователь при этом ищет не «что-то похожее», а конкретный материал, совместимость или характеристику. Именно на таких запросах усреднение начинает мешать: модель не различает атрибуты, а значит, и ранжирование получается приблизительным.
Статья arXiv:2608.24467 (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, август 2026 года) ставит диагноз прямо: глобальные эмбеддинги неявно кодируют товар целиком, и это ограничивает улавливание мелкогранулярных атрибутов. Лечится ли это простым «сделаем вектор побольше»? Судя по логике работы — нет, проблема не в размерности, а в способе представления.
Гиперграф вместо плоского списка эмбеддингов
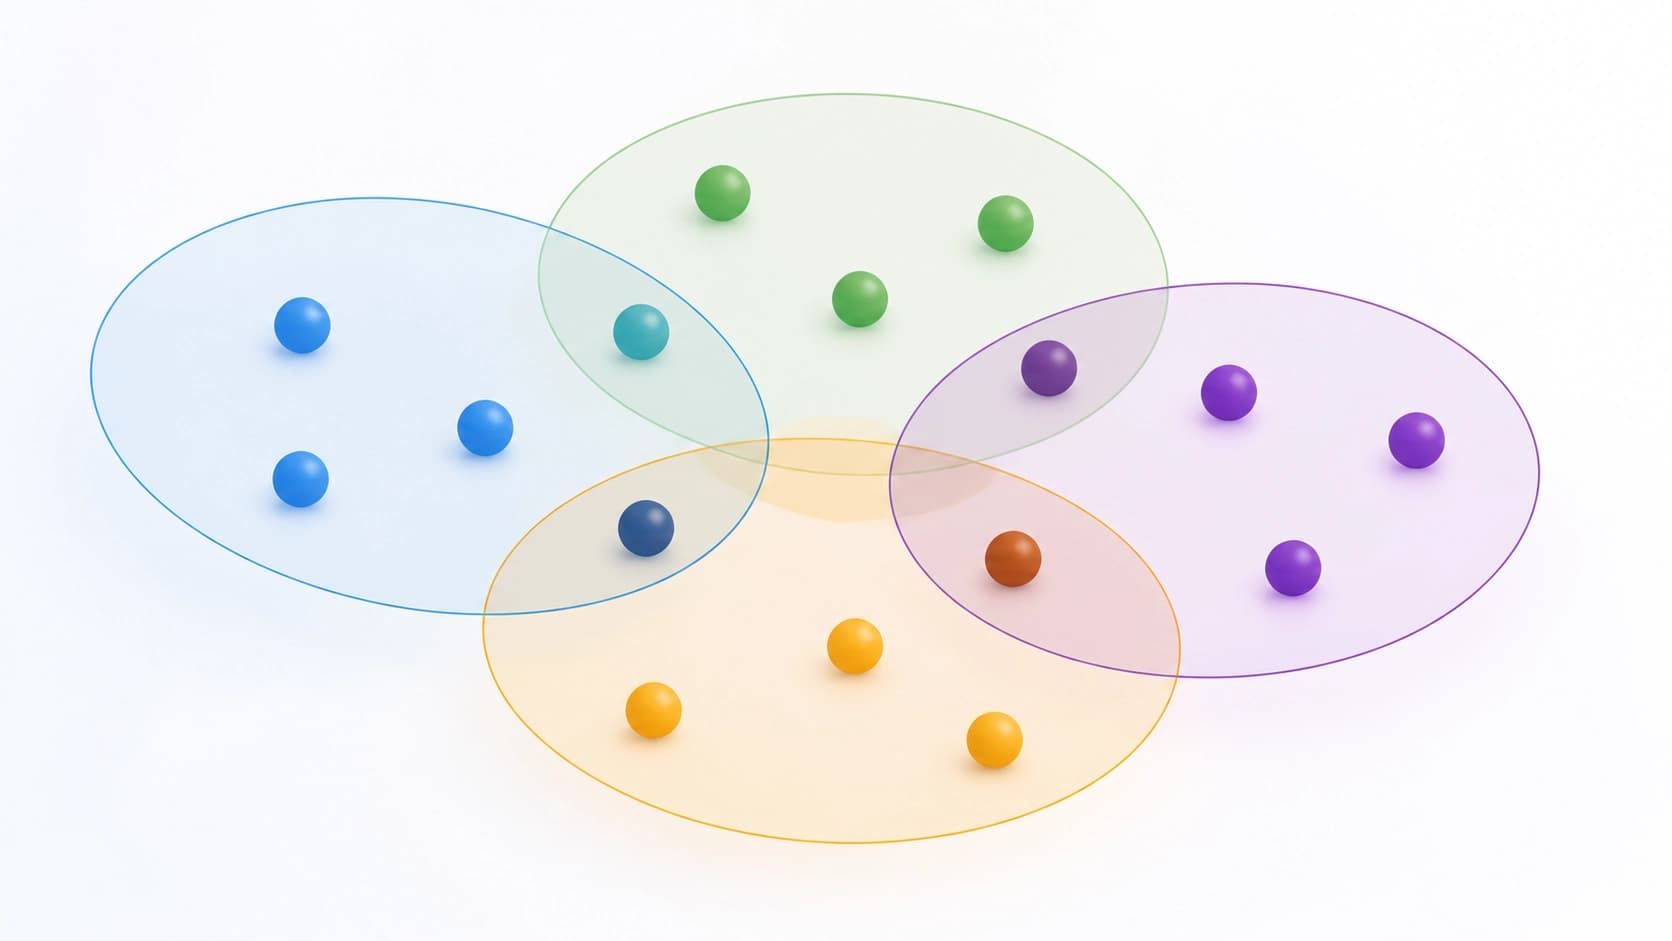
Авторы предлагают HMGCLIP — фреймворк мультимодальных эмбеддингов, в основе которого лежит гетерогенный гиперграф. Разница с привычным графом принципиальная. Обычное ребро соединяет два объекта; гиперребро связывает сразу группу — например, все товары одной категории, объединённые общим атрибутом. Такая конструкция позволяет описывать отношения, которые нельзя разложить на пары: «эти семь позиций — одна линейка материалов», «эти четыре — взаимозаменяемые аналоги».
Дальше топология гиперграфа работает в двух направлениях. Во-первых, из неё извлекаются структурно осознанные сложные негативы — те похожие, но неправильные примеры, на которых модель учится различать. Это важный момент: сложные негативы не выбираются случайно из корпуса, их подсказывает сама структура связей. Во-вторых, через гиперграф согласуется многогранулярная семантика — и на уровне отношений, и на уровне гиперрёбер. Проще говоря, модель выравнивает между собой не только отдельные товары, но и целые смысловые группы.
Зачем нужен механизм двухгранулярного инференса
Отдельная деталь — dual-granularity inference. На выходе система динамически объединяет атрибутивные свидетельства так, чтобы одинаково уверенно работать и с мелкогранулярными, и с крупногранулярными задачами. Практический смысл в том, что одному запросу нужен общий уровень («покажи кроссовки»), а другому — предельно узкий («кроссовки с мембраной и конкретным типом подошвы»). Модель, заточенная только на детали, теряет в широте; заточенная только на общее — в точности. Здесь предполагается, что система сама решает, на каком уровне смотреть.
Датасет и проверка
Авторы не ограничились архитектурой: они выпустили комплексный мелкогранулярный датасет электронной коммерции, чтобы у задачи появился воспроизводимый бенчмарк для будущих сравнений. Это, пожалуй, не менее ценная часть работы — без публичного набора данных спорить о мелкогранулярном различении бессмысленно, каждый измеряет на своём.
Эксперименты проводились на новом датасете и на публичном бенчмарке MAVE. Результат заявлен однозначно: подход обходит сильные мультимодальные энкодеры, мультимодальные LLM и базовые решения для электронной коммерции. Конкретные цифры и таблицы — в самой работе; здесь важен вывод, что структурный подход к представлению даёт выигрыш, которого не удаётся достичь простым усложнением модели.
Где это пригодится на практике
Первое и самое очевидное — поиск и подбор аналогов. Когда покупатель ищет замену вышедшей из строя вещи, ему нужна совместимость по атрибутам, а не общее сходство картинки. Второе — рекомендации: они выигрывают, если умеют отличать вариант с другим материалом от того же товара в другой комплектации. Третье — чистота каталога: дубликаты и почти-дубликаты, которые сейчас склеиваются автоматикой наугад, при мелкогранулярном представлении разделяются осмысленнее.
Есть и менее очевидный слой — объяснимость. Гиперрёбра формируют структуру, по которой видно, почему товары оказались рядом. Для команд, которые разбираются с ошибками ранжирования, это полезнее, чем вектор непонятной природы.
Что пока остаётся открытым
Любая работа с графовой структурой упирается в стоимость: гиперграф нужно построить, а при обновлении каталога — поддерживать в актуальном состоянии. Насколько это дёшево на миллионах карточек и как часто его придётся перестраивать, авторы в аннотации не раскрывают.
Второй вопрос — переносимость. Датасет собран в одной предметной области, и неизвестно, насколько хорошо схема поведения гиперрёбер сохранится при переходе, скажем, от одежды к электронике, где атрибуты устроены совсем иначе. Третий — как такой подход уживается с уже работающими продакшн-пайплайнами: замена способа представления обычно означает переиндексацию всего поискового индекса.
Как бы то ни было, направление обозначено внятно. Спор идёт не о том, чья модель крупнее, а о том, как правильно хранить смысл товара: в одной усреднённой точке или в сети связей, где детали не растворяются.