
Мудрость толпы упирается в однообразие
Когда нужно предсказать что-то про будущее — поведение рынка, исход события, судьбу технологии, — приходит простая мысль: чем больше моделей спросить, тем надёжнее будет ответ. Логика вроде бы железная: разные системы ошибаются по-разному, значит, усреднение сгладит случайные промахи.
Но у этой схемы есть подвох. Если все участники «толпы» рассуждают похожим образом, их голоса — не независимые свидетельства, а одно и то же мнение, размноженное копированием. Десять почти одинаковых ответов не добавляют информации по сравнению с одним; они лишь создают ощущение уверенности и увеличивают счёт за инференс.
Именно вокруг этой проблемы построена работа «Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction» — её подготовили Нирупам Четлапалли, Имин Ляо, Минь-Чунь Чэнь и Кеке Чэнь. Препринт arXiv:2608.24001 появился 25 августа 2026 года, уже на следующий день вышла пересмотренная версия, а сама статья подана на IEEE BigData 2026.
Просто «побольше моделей» не решает задачу
Ключевое наблюдение авторов: разные большие языковые модели могут вести себя избыточно похоже. Они обучены на сопоставимых данных, тяготеют к схожим формулировкам и типовым ходам рассуждения. В итоге механическое расширение списка участников не даёт того разнообразия, ради которого всё затевалось.
Тут важно развести два понятия. Количество — это сколько моделей мы опрашиваем. Разнообразие — это насколько по-разному они приходят к выводам. Второе не вытекает из первого автоматически: можно собрать двадцать участников и получить двадцать вариаций одной и той же мысли.
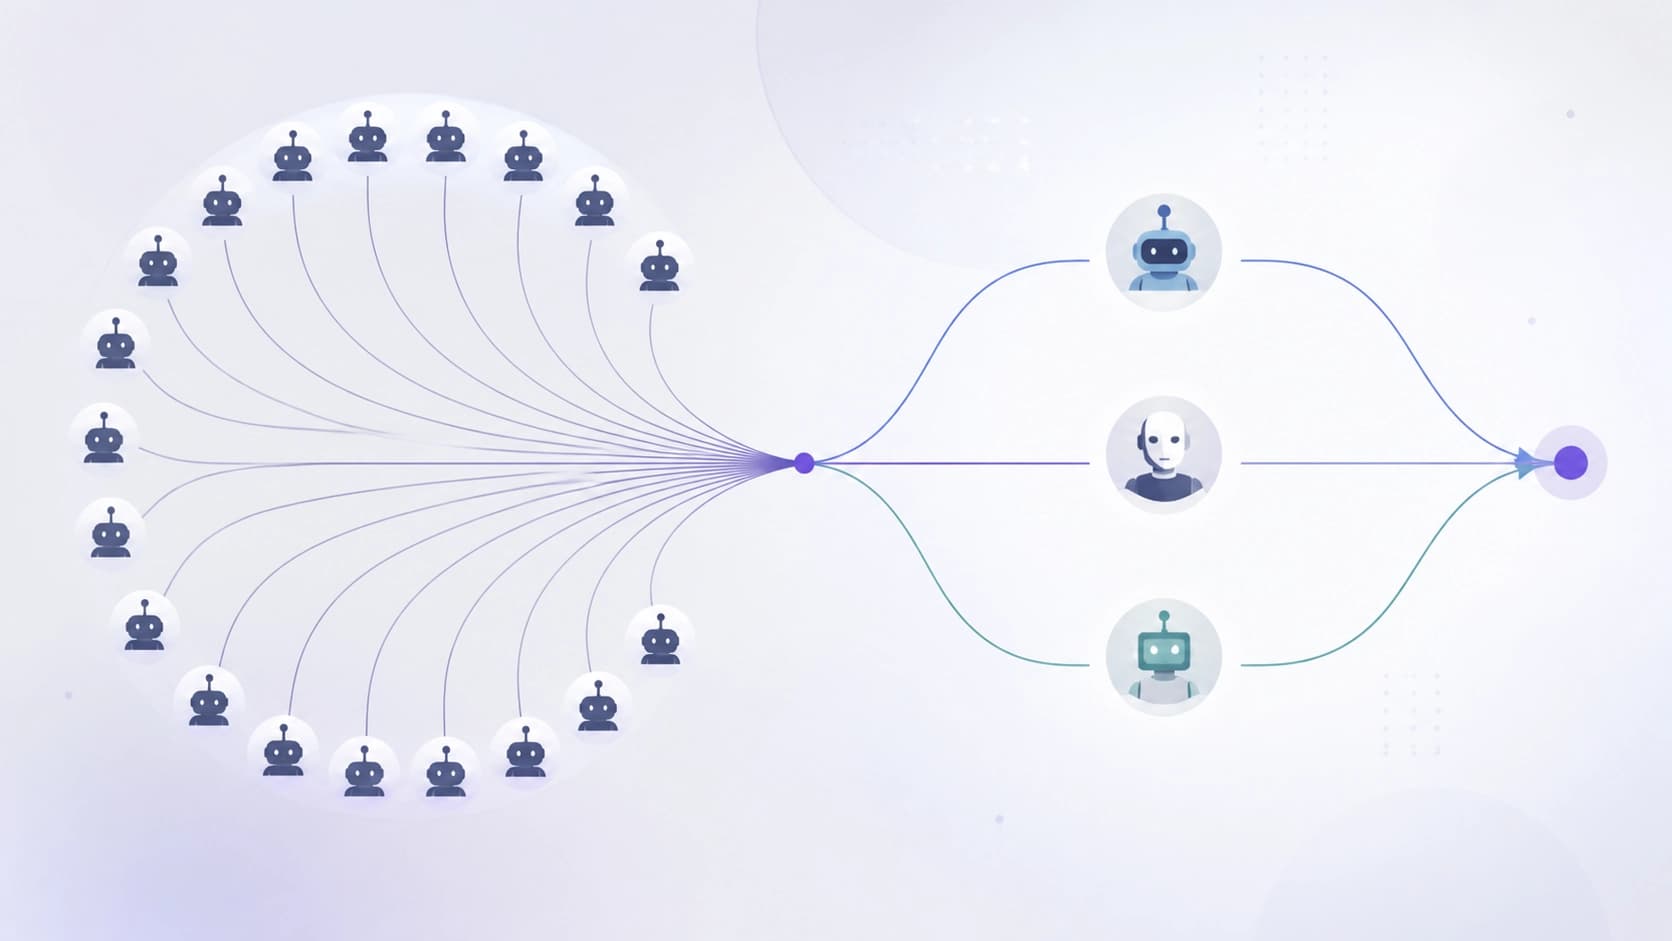
Метод: модели отбирают по стилю рассуждений, а не по ответам
Как выглядит поведенческий отбор
Авторы предлагают фреймворк, который они называют поведенчески-ориентированным. Суть не в том, чтобы сравнивать модели по правильности финальных ответов, а в том, чтобы понять, как они думают.
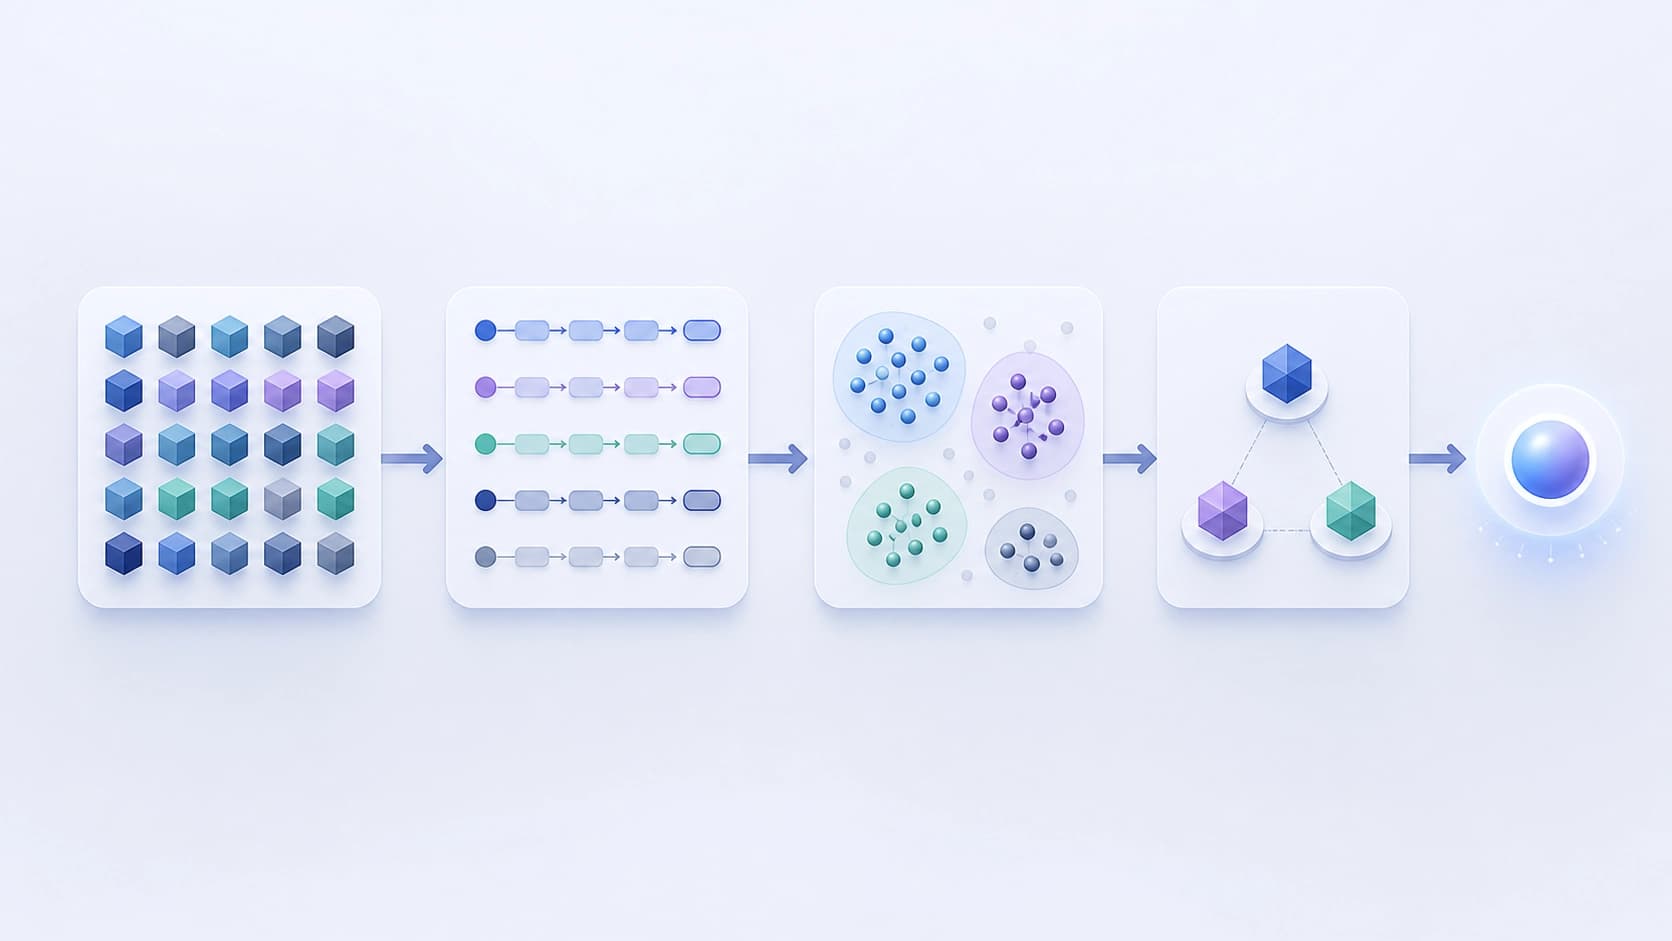
Схема такая:
- Каждую из моделей прогоняют по набору независимых задач, не связанных с прогнозированием будущего. Собираются не столько ответы, сколько цепочки рассуждений — те самые reasoning traces.
- На основе этих следов строится поведенческий профиль: какие шаги модель делает, как разбивает задачу, где ошибается, к каким аргументам прибегает.
- Модели группируются в кластеры по схожести поведения. Для этого используется алгоритм K-means++.
- Из каждого кластера берётся один представитель — медоид, то есть модель, наиболее типичная для своей группы.
- Уже эта компактная «толпа» медоидов выносит коллективный прогноз.
Идея, если вдуматься, не нова — так поступают в статистике, когда из коррелирующих признаков оставляют по одному представителю, чтобы не дублировать одну и ту же информацию. Новизна здесь в том, что «признаком» становится манера рассуждения языковой модели, а не числовая характеристика.
На чём проверяли
Эксперимент построен на 25 моделях. Семь бенчмарков разработки использовались, чтобы описать и развести модели по поведению, а два отдельных бенчмарка — уже на прогнозирование будущего — чтобы оценить качество получившихся «толп». Такое разделение принципиально: задачи, по которым строится профиль, не совпадают с задачами, по которым считается результат. Иначе получилось бы обучение с подглядыванием, и цифры не значили бы почти ничего.
Результат: три модели обходят двадцать пять
Самое громкое в работе — итог сравнения. «Толпа» всего из трёх моделей-медоидов, собранная через поведенческую кластеризацию, показала себя лучше, чем обычное голосование по всем 25 моделям сразу. И это справедливо для обоих бенчмарков прогнозирования.
При этом экономия получилась внушительной: количество обращений к моделям сократилось на 88%, а расходы на инференс — примерно на 80%. Для практики это едва ли не важнее самого прироста точности. Прогнозные системы часто упираются не в качество ответа, а в его цену: если на каждый вопрос нужно опросить два десятка моделей, решение становится нерентабельным гораздо раньше, чем неточным.
Отсюда вытекает неочевидный вывод: состав «толпы» весит больше, чем её размер. Двадцать пять моделей — не автоматическое преимущество перед тремя, если эти двадцать пять в сущности повторяют друг друга.
Не любое разнообразие одинаково полезно
Авторы делают ещё один аккуратный вывод, который легко упустить. Оказывается, важна не максимизация разнообразия как таковая, а репрезентативность — то, насколько выбранные участники отражают разные полюса поведения, встречающиеся среди моделей.
Разница принципиальная. Можно набрать три модели, которые отличаются друг от друга случайно и по мелочам, — и получить шум вместо сигнала. А можно отобрать по одной из действительно разных поведенческих групп — и получить компактный набор, покрывающий пространство решений. Первое — разномастность, второе — разнородность. Работает второе.
Здесь напрашивается параллель с обычной экспертизой. Хорошая комиссия — не та, где больше людей, а та, где представлены разные подходы и точки зрения. Пять специалистов из разных областей обычно полезнее пятнадцати выпускников одной кафедры.
Что это значит на практике
Для тех, кто строит прогнозные сервисы на языковых моделях, выводы статьи дают довольно конкретный рецепт:
- Не гнаться за длиной списка моделей. Расширять пул без анализа поведения — значит платить за дублирующиеся ответы.
- Сначала измерить поведение, потом выбирать состав. Прогон по посторонним задачам и кластеризация дают понятную картину того, кто в наборе действительно отличается.
- Экономить осознанно. Сокращение числа вызовов на порядок при сохранении или улучшении точности меняет экономику продукта, а не только его технические характеристики.
- Помнить об ограничениях. Всё это проверено на конкретном наборе из 25 моделей и двух прогнозных бенчмарках; переносить цифры один в один на другие домены и другие модели не стоит.
Главная мысль работы звучит почти по-человечески: ценность коллективного мнения держится не на количестве голосов, а на том, что эти голоса действительно разные. Применительно к языковым моделям это означает, что измерять нужно не список названий, а стиль мышления — и уже по нему собирать команду.


