
Почему «покажи, где это» — неправильный вопрос
Классический тест на визуальное ориентирование выглядит почти по-школьному: даётся картинка и фраза вроде «синяя папка на нижней полке», а модель должна указать, где находится нужный объект. Один запрос, один ответ, метрика — попала или нет.
Схема удобная, но она описывает не разговор, а команду. В живой коммуникации человек редко выдаёт исчерпывающее описание с первого раза. Он говорит «ну эта штука рядом с окном» и рассчитывает, что собеседник либо догадается, либо переспросит. Взаимопонимание достраивается по ходу диалога — иногда за два хода, иногда за пять.
Авторы работы arXiv:2608.23978 (Zhengxiang Wang и Owen Rambow, статья принята на EMNLP 2026) предлагают считать именно этот пропущенный этап предметом измерения. Их вопрос звучит так: умеет ли модель не только смотреть, но и спрашивать, когда картинки и слов не хватает для однозначного вывода.
Как устроен эксперимент
Управляемый дефицит информации
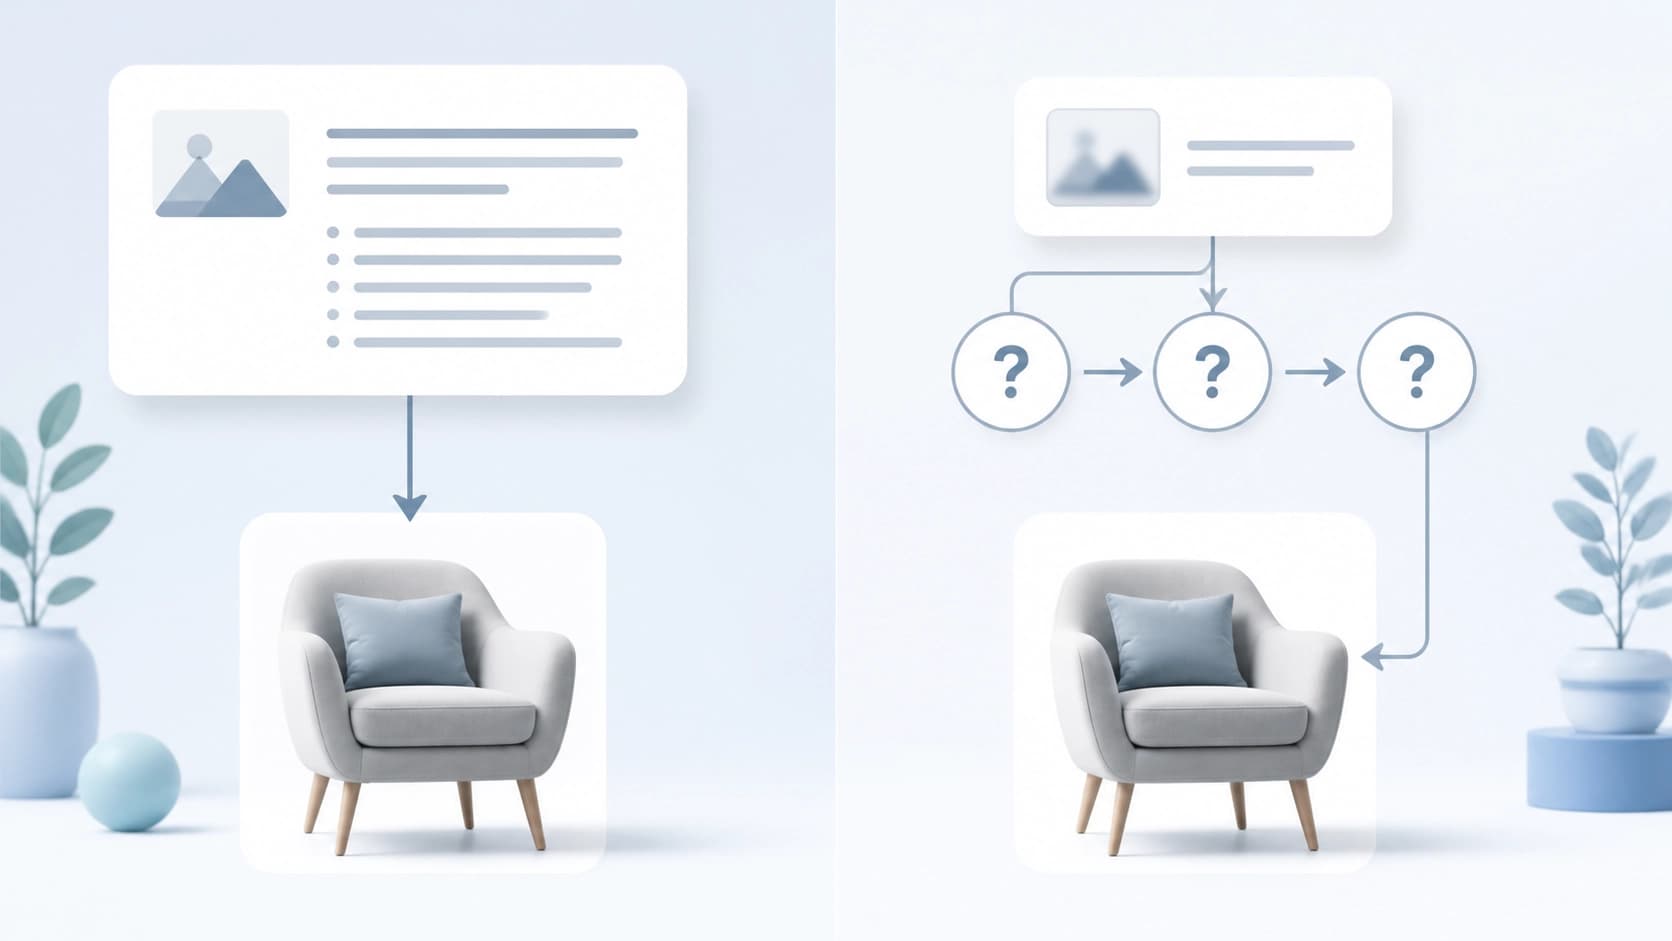
Ключевая идея — не измерять точность «в среднем», а плавно регулировать, сколько сведений о цели выдано заранее, а сколько модель обязана добыть сама. На одном конце шкалы задача почти не отличается от обычного одношагового теста: описание подробное, цель очевидна. На другом — исходной формулировки нет вообще, и всё, что модель знает о нужном объекте, она должна вытащить из собственных уточняющих вопросов.
Такая конструкция позволяет отделить навык распознавания от навыка вести диалог. Модель, которая идеально находит объект по точной подсказке, может полностью провалиться, когда подсказку нужно собрать по кусочкам.
Четыре контекста и четыре протокола
Экспериментальная среда опирается на четыре визуальных контекста, приближенных к человеческим сценариям, и четыре разных протокола взаимодействия. Это важно: результат не сводится к одной удачной или неудачной конфигурации. Заодно проверялось, кто именно формулирует описание — человек или другая модель, а также как влияют объём рассуждений, повторные попытки и смена поставщика описаний. Закономерности, о которых речь ниже, воспроизвелись во всех этих вариантах.
Где именно ломается
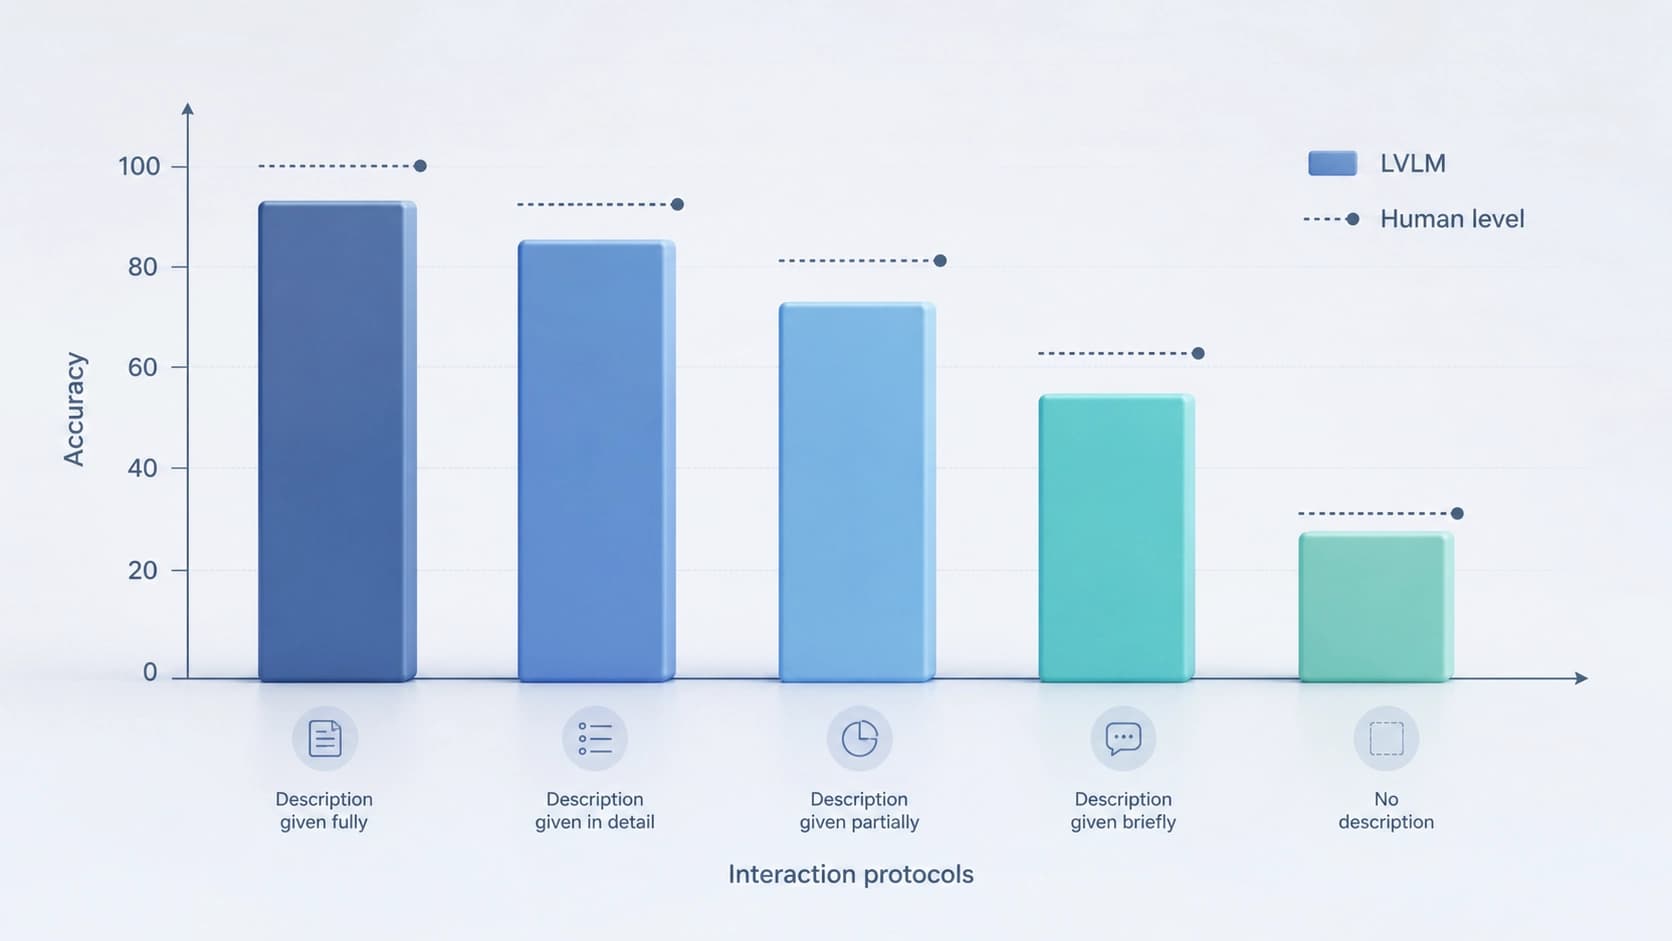
Разрыв с человеком держится на всех протоколах
Главный вывод невеселый: ни в одном из режимов текущие большие визуально-языковые модели не подошли близко к человеческим базовым показателям. Разрыв сохраняется и тогда, когда задача выглядит почти тривиальной, и тогда, когда она требует настоящего диалога. Речь идёт не о нескольких процентных пунктах, а о качественной разнице в надёжности.
Хуже всего — когда описания нет вовсе
Самые низкие результаты зафиксированы в сценарии, где исходная формулировка цели отсутствует. Модели приходится самой строить гипотезу о том, что искать, задавать вопросы и по ответам сужать область поиска. Это уже не про распознавание, а про проактивное поведение: нужно самому решить, что информации не хватает, и сформулировать запрос, который эту нехватку закроет.
Здесь и проявляется провал, который вынесен в название работы: смотреть модель умеет, а спрашивать — нет. Она либо делает ставку на догадку, либо задаёт вопросы, которые ничего не уточняют.
Уточнение работает, но не всегда
Взаимодействие не бесполезно. Когда уточняющий вопрос корректирует или дополняет изначальное описание, точность заметно подрастает. То есть механизм диалога в модели присутствует и приносит пользу — но только в роли редактора чужой формулировки. Как только формулировку нужно создать с нуля, преимущество исчезает.
Уверенность впереди точности
Отдельная линия анализа — калибровка. Модели систематически заявляют уверенность выше той, которую подтверждает их фактическая точность. Практически это означает, что по ответу модели нельзя судить, стоит ли ему доверять: и верный, и неверный выбор сопровождаются одинаково бодрым тоном.
Для приложений это опаснее, чем просто ошибки. Если система ошибается, но честно сигналит о неуверенности, её можно переспросить или позвать человека. Если она ошибается с убеждённым видом — встроить такую страховку не получается.
Почему задача сложнее, чем кажется
Интерактивное визуальное ориентирование требует одновременной работы трёх механизмов:
- визуальное сопоставление — связать слова с объектами на изображении, включая пространственные отношения и свойства;
- поиск информации — понять, каких сведений не хватает, и получить их через вопрос, а не через перебор;
- синтез — собрать разрозненные ответы в единую гипотезу и не потерять её по дороге.
Каждый навык по отдельности у современных моделей в той или иной степени есть. Ломается стык между ними: увиденное не превращается в вопрос, а ответ на вопрос не перестраивает картину мира.
Что это значит на практике
Если вы собираете продукт на базе мультимодальной модели — скажем, GPT-4o или любого другого API с поддержкой изображений, — выводы работы легко переложить в инженерные решения:
- Не полагайтесь на первое описание. Если пользователь формулирует запрос размыто, закладывайте цикл уточнений, а не единственный запрос-ответ.
- Не доверяйте заявленной уверенности. Калибровку лучше строить на собственной разметке под конкретную задачу, а не на самооценке модели.
- Проектируйте вопросы за модель. Если система не умеет сама понять, чего ей не хватает, роль спрашивающего придётся взять на себя внешнему слою логики.
- Тестируйте на своём дефиците информации. Полезно проверить, как пайплайн ведёт себя ровно в тех режимах, где, по данным авторов, точность проваливается.
Итог
Работа фиксирует не отсутствие способностей, а несовпадение навыков. Модели видят достаточно, чтобы отвечать на хорошо поставленные вопросы, но не настолько понимают ситуацию, чтобы задавать их самим. До тех пор, пока этот разрыв не закрыт, интерактивное визуальное ориентирование останется задачей, где человек продолжает быть самым надёжным звеном диалога.


