Три модели, одна лицензия и никаких оговорок
Granite 4.2 — это уже не ассистент, заточенный под следование инструкциям, какими были предыдущие релизы линейки. IBM перестроила семейство вокруг явного рассуждения: любая из моделей сначала проговаривает цепочку шагов, а затем формулирует ответ. В релизе три размера — 3B, 8B и 30B параметров.
Главная новость для бизнеса не в бенчмарках, а в лицензии. Все три модели распространяются под Apache 2.0: скачивание, дообучение и запуск в продакшене не требуют ни дополнительных согласований, ни ограничений на коммерческое применение. Для компаний из регулируемых отраслей возможность держать веса on-prem часто перевешивает любые строчки в таблицах с метриками.
Параллельно вышли две речевые модели Granite Speech 5.0 Turbo CTC по 470 млн параметров — о них ниже отдельно.
Режим работы переключается прямо в chat-шаблоне. Есть thinking, есть non-thinking, а между ними — low-effort: короткий бюджет рассуждения для простых вопросов, чтобы не тратить токены там, где задача этого не стоит. По сути, одна и та же модель закрывает и «подумай как следует», и «ответь быстро».
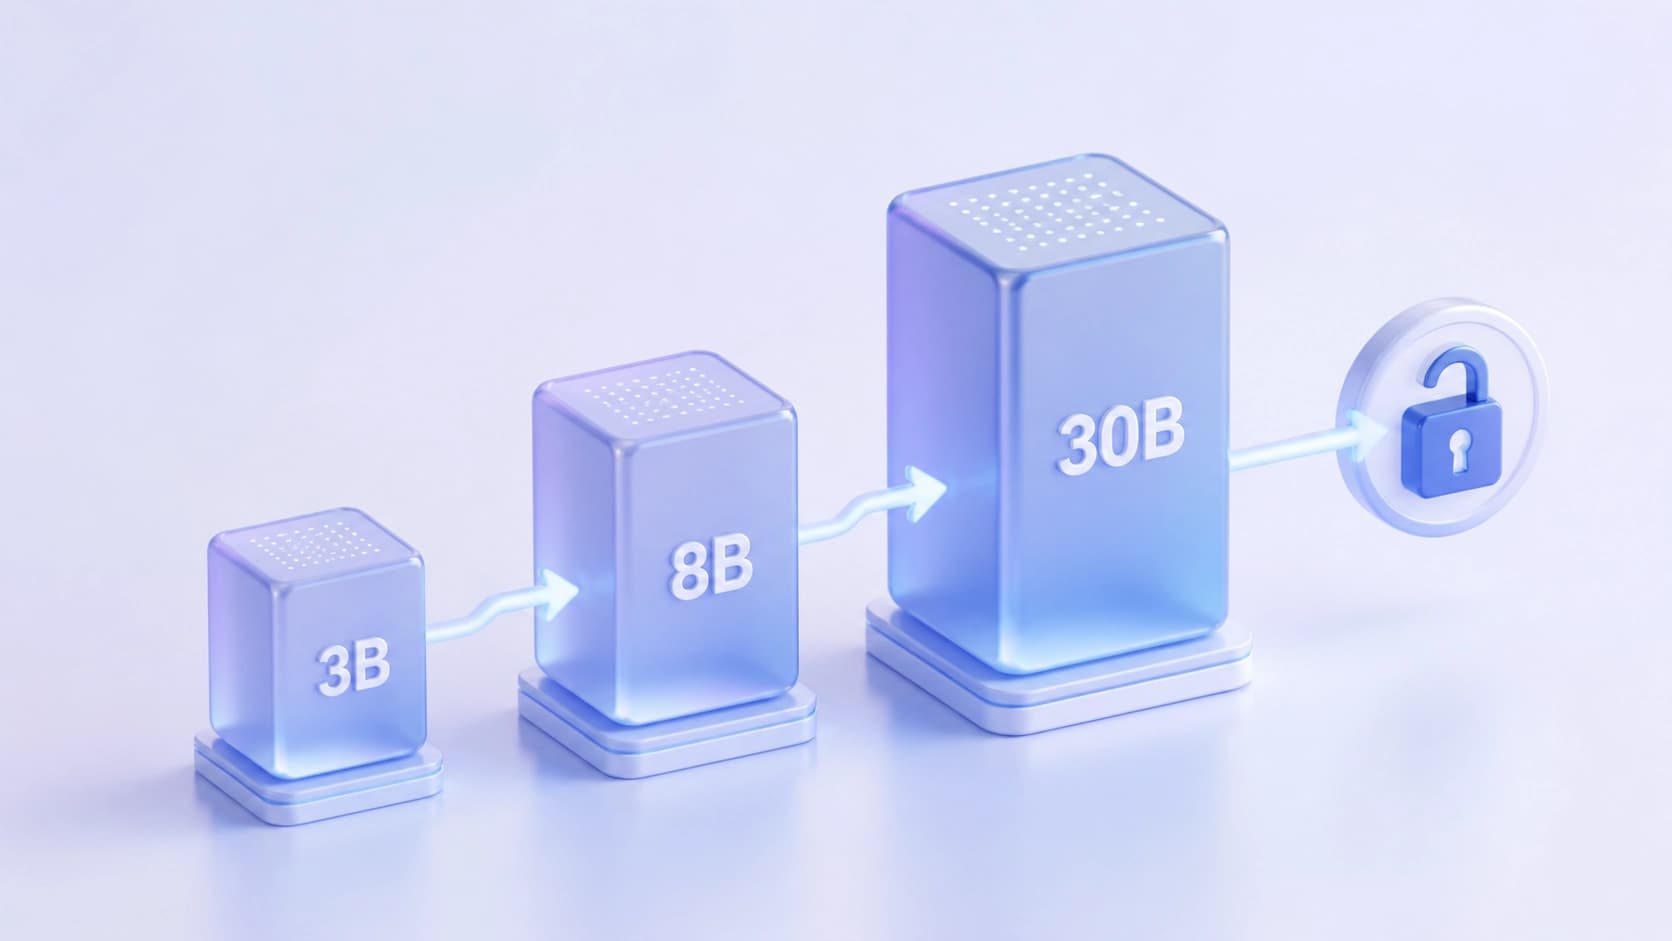
Кому какой размер
3B — ноутбук отдельного разработчика
Младшая модель рассчитана на индивидуальных разработчиков и небольшие стартапы. Запускать её можно локально через Ollama или LM Studio, в том числе на опубликованных GGUF-квантах вплоть до Q4_K_M. Это сценарий «поставил на ноутбук и экспериментируешь без счёта за API».
8B — одна современная GPU на команду
Средний размер адресован командам среднего рынка: одной актуальной видеокарты достаточно, чтобы держать модель в рабочем контуре.
30B — корпоративный контур
Старший вариант требует мощностей уровня A100 или H100, а также обслуживания в FP8 или NVFP4 на vLLM. Зато это тот случай, когда модель можно поставить внутри периметра и не отдавать данные наружу.
Отрасли, под которые IBM явно целится: разработка ПО и инструменты для разработчиков, финансовые услуги, здравоохранение, телеком, госсектор и контакт-центры — последние как раз под новые речевые модели. Типовые сценарии — агенты для написания кода, автоматизация терминала и DevOps, глубокое исследование и поиск, RAG по длинным документам, структурированный вызов инструментов и массовая транскрибация.
Архитектура: плотный трансформер без хитростей
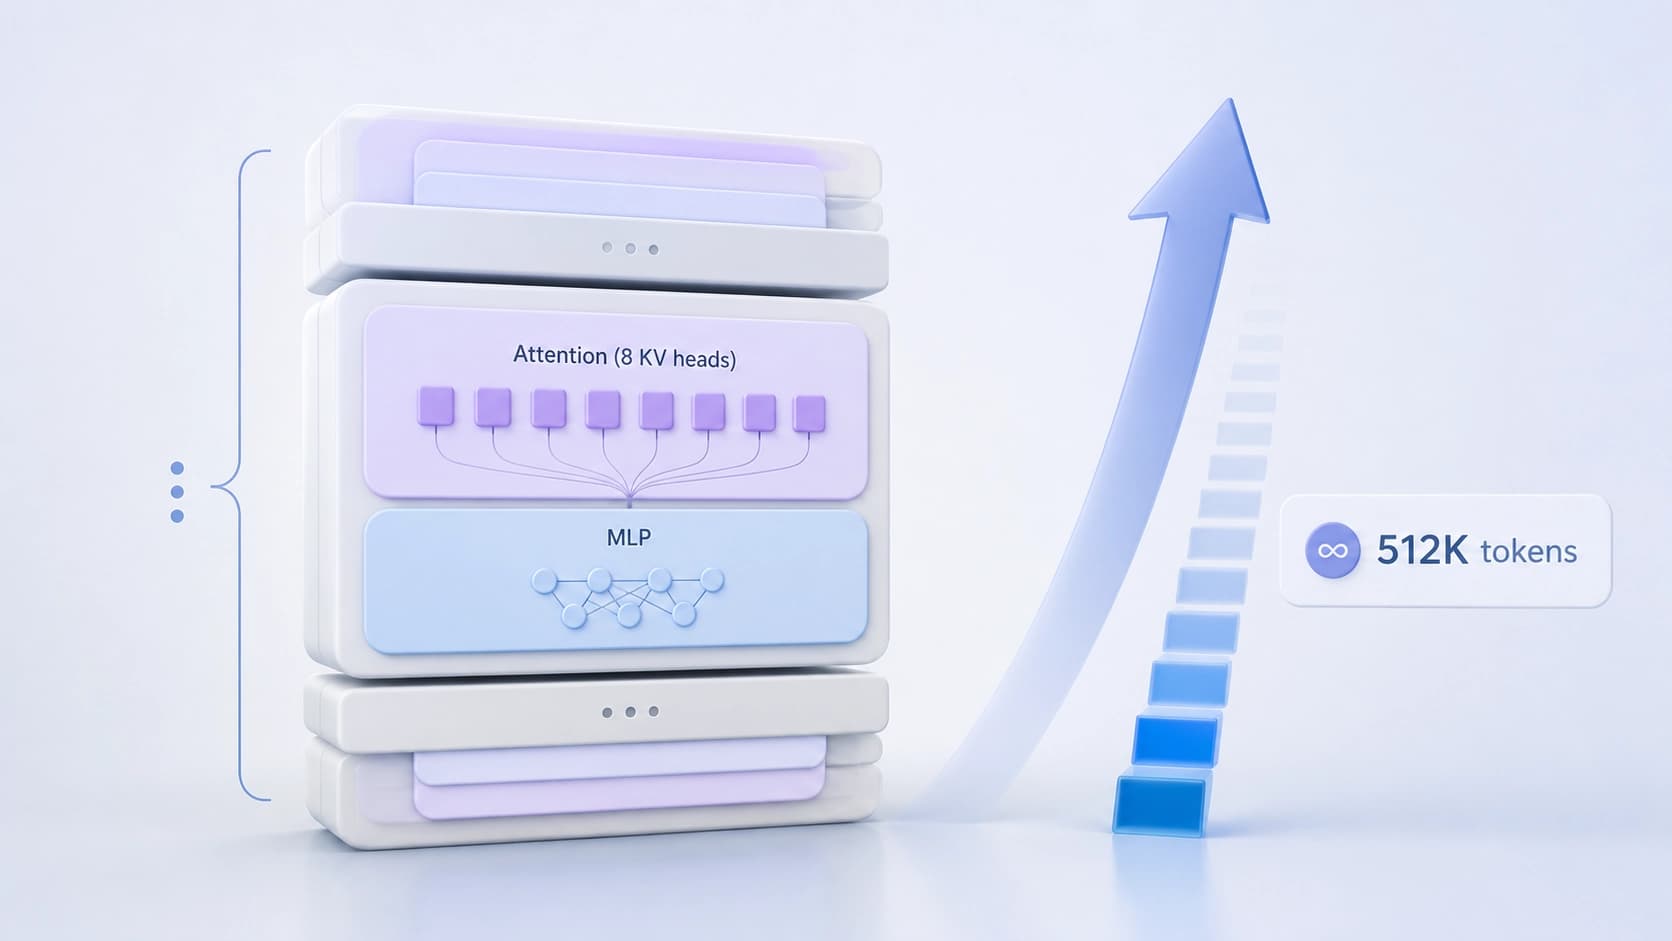
Granite 4.2 — это decoder-only плотный трансформер. Никакой гибридности, никакого mixture-of-experts: ставка сделана на предсказуемость поведения и простоту развёртывания, что для корпоративного контура логично.
Из технических деталей:
- Grouped Query Attention с 8 KV-головами;
- RoPE с θ = 10 000 000;
- SwiGLU в MLP;
- RMSNorm с ε = 1e-5;
- несвязанные входные и выходные эмбеддинги;
- точность bfloat16.
Размеры различаются так: у 3B — 40 слоёв и эмбеддинги на 2560, у 8B — те же 40 слоёв, но эмбеддинги 4096, у 30B — 64 слоя и скрытый размер MLP 32 768.
В опубликованной таблице архитектуры указана длина последовательности 131 072 токена, то есть 128K. При этом предобучающий прогон состоял из пяти фаз и включал этап длинного контекста до 512K токенов. Обучение с нуля шло примерно на 15 трлн токенов.
Обучение: SFT, а затем многоэтапный RL
Этап supervised fine-tuning опирался примерно на 7,2 млн сэмплов — около 100 млрд токенов, из которых обучаемых порядка 65 млрд. Смесь данных распределена так: 31,6% агентных примеров против 68,4% неагентных, причём на программную инженерию приходится 69% агентной части.
Траектории собирали в харнессах — среди них OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex и Goose. Качество фильтровали двумя способами: в роли судей выступали GPT-OSS-120B и Gemma 4, плюс шла дедупликация по SHA-256 по полям tools и messages.
Постобучение — не один проход, а цепочка RL по нескольким средам. Каждый этап представляет собой отдельный асинхронный прогон GRPO, который warm-start'ится от чекпоинта предыдущего; вместо value-сети используется leave-one-out базовая линия, а усечённая важностная выборка ограничивает дрейф в off-policy. Порядок такой: сначала RLVR, затем skill boosters, потом SWE, Terminal и Search, и в финале RLHF.
Здесь кроется самое важное ограничение релиза: блок агентного RL применяли только к 8B и 30B. Младшая 3B проходит лишь базовый RL и выравнивание — и именно этим во многом объясняется разрыв в возможностях между размерами. Обучение велось на NeMo-RL и NeMo-Gym на кластере NVIDIA GB200 NVL72, размещённом у CoreWeave. Дополнительно в пайплайн заложили 1 трлн токенов синтетического кода из CodeAlchemy и слой спекулятивного декодирования для ускорения обслуживания.
Что показывают метрики IBM
Цифры заявлены самой IBM, поэтому их стоит читать как ориентир, а не как независимую проверку. Порядок значений — 3B / 8B / 30B:
- SWE-Bench Verified: для 3B оценки нет, у 8B — 47.6, у 30B — 57.00;
- Terminal-Bench 2.1: 20.56 и 29.24 соответственно;
- τ³-bench: 50.99 / 66.34 / 68.05;
- BFCL v4: 52.41 / 50.29 / 61.39;
- AIME25: 78.33 / 86.67 / 89.17;
- GPQA: 54.80 / 64.14 / 66.41;
- MMLU-Pro: 67.84 / 74.04 / 77.60;
- RULER 128K: 55.30 / 71.41 / 81.38.
Любопытная деталь — в тесте на вызов функций 8B слегка уступает 3B (50.29 против 52.41). Это напоминание о том, что размер сам по себе не гарантирует преимущества в каждом отдельном навыке, и выбор модели под задачу важнее, чем погоня за старшим чекпоинтом.
Речь: 470 млн параметров без LLM-бэкбона
Речевые Granite Speech 5.0 Turbo CTC устроены принципиально иначе, чем привычные ASR-системы на базе языковых моделей: здесь LLM-бэкбон не используется вовсе, а преобразование аудио в текст выполняется через connectionist temporal classification. Отсюда и компактность — 470 млн параметров.
IBM заявляет RTFx около 12 600 на одной H200, тогда как текущие лидеры скорости в Open ASR leaderboard показывают примерно 6 000. Для контакт-центров с большими объёмами записей разница в пропускной способности конвертируется в деньги напрямую. Попробовать модель можно в демонстрации на WebGPU.
Что в итоге
IBM собрала предсказуемый продукт для корпоративного рынка: плотные модели без архитектурной экзотики, открытая лицензия, развёртывание на своём железе и режимы рассуждения под разные типы задач. Агентные возможности сосредоточены в 8B и 30B, поэтому 3B логично воспринимать как недорогую точку входа и модель для простых сценариев, а не как «младшего брата» без потерь. Подробности стоит сверять по блогу IBM Research, техническому описанию и репозиторию на GitHub, ссылки на которые приводятся вместе с релизом.