
Где заканчивается перенос: масштаб данных, разнообразие миров и размер модели для игровых агентов
На 120 конфигурациях проверено, сохраняются ли преимущества продолжительного предобучения при переходе между виртуальными средами с разной графикой, физикой, управлением и задачами. Увеличение корпуса помогает в освоенных мирах, вариативность расширяет перенос на близкие среды, а рост модели повышает отдачу от данных, но при обучении в одном мире ухудшает адаптацию к далёким; авторы заключают, что одной предварительной подготовки недостаточно для универсальных агентов.
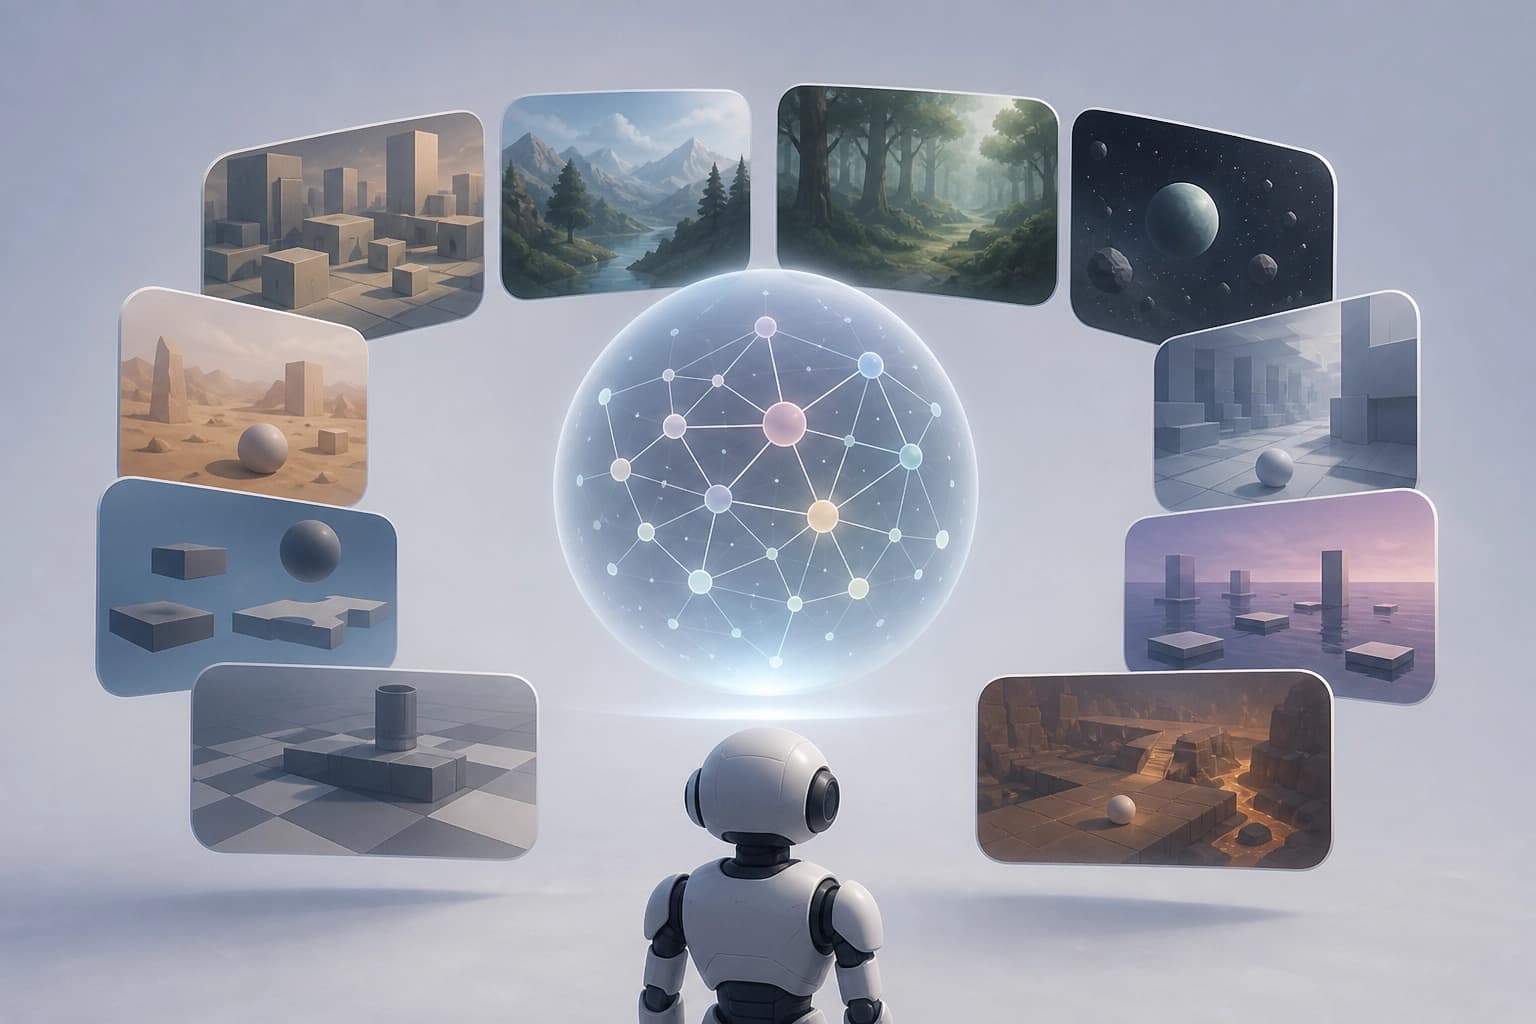
Что проверяли и как измеряли перенос
Исследование посвящено continued pre-training (CPT) для воплощённых агентов в виртуальных мирах. Авторы проверяли, переносятся ли улучшения от масштабирования данных, их разнообразия и размера модели. Работа охватывает 120 конфигураций обучения.
| Фактор | Что варьировали |
|---|---|
| Размер модели | четыре значения от 0.8B до 27B |
| Объём данных | шесть значений от 50 до 1,600 hours |
| Смесь данных | пять вариантов: от данных одного мира до разнообразных многомировых корпусов |
| Оценка | трёхуровневые валидационные потери и игровые бенчмарки |
Оценка идёт на трёх уровнях: миры из обучения, родственные миры и невиданные миры. Такой дизайн отделяет выигрыш в знакомой среде от переноса. Практический критерий: включать в валидацию все три группы миров. Иначе рост в обученных мирах скроет разрыв в далёких.
Объём данных: эффект в знакомых мирах
Увеличение объёма данных улучшает производительность в мирах, входивших в обучающие данные. Это подтверждённый эффект масштаба на знакомой территории. Для далёких миров авторы не сводят перенос к одному объёму данных.
Объём данных — не универсальный рычаг для любой цели. Он даёт понятный выигрыш там, где мир уже представлен в обучении. Для нового мира нужно отдельно проверять, какую часть разрыва закрывает объём.
Критерии выбора:
- целевой мир входит в обучение — увеличивать объём данных;
- целевой мир далёк — не полагаться только на объём;
- состав миров неясен — сначала разделить миры по близости.
Разнообразие: перенос на родственные, но не на далёкие миры
Разнообразие данных улучшает перенос на родственные миры. На далёких мирах прирост ограничен. Этот эффект отделяет разнообразие от простого увеличения объёма.
| Степень близости мира | Наблюдаемый эффект разнообразия | Практический вывод |
|---|---|---|
| Родственные миры | улучшает перенос | разнообразная смесь оправдана |
| Далёкие миры | ограниченный прирост | разнообразия недостаточно как самостоятельного средства |
Разнообразие расширяет зону переноса, но не делает агент универсальным. Смесь данных работает как мост к похожим мирам. Для далёких миров этот мост короче, чем нужно.
Практический критерий: оценивать близость целевых миров к обучающим. Для родственных миров разнообразие смеси — рабочий инструмент. Для далёких миров разнообразия недостаточно.
Размер модели: эффективность данных и риск узкого обобщения
Увеличение размера модели повышает эффективность использования данных. При обучении на одном мире размер модели ухудшает обобщение на далёкие миры. Это делает размер зависимым от состава данных.
Большая модель лучше использует доступные данные. Но в узком обучении она сужает перенос. Один и тот же рост параметров даёт разный эффект в зависимости от смеси миров.
Критерии выбора:
- обучение на одном мире — не ждать роста переноса от размера модели;
- разнообразные данные — размер модели усиливает использование данных;
- выбор размера — только вместе с выбором смеси.
Две фазы обучения: интерфейс и мир
Авторы наблюдают раннюю фазу интерфейса (early interface phase). В этой фазе модель получает широкие преимущества в разных мирах. Позже наступает поздняя фаза мира (later world phase). В ней улучшения сужаются до миров из обучения и родственных миров.
Фазы задают разную ширину переноса. Ранняя фаза формирует общий интерфейс для разных миров. Поздняя фаза привязывает улучшения к знакомой и близкой среде. Это не ошибка обучения, а смена зоны действия.
Критерии выбора:
- нужен широкий интерфейс — ранняя фаза;
- нужен целевой мир — поздняя фаза;
- нужны далёкие миры — ранняя фаза не удерживает перенос.
Границы continued pre-training
Авторы отмечают ограничения имитационного обучения и сохраняющийся разрыв в далёких мирах. По их выводу, универсальные воплощённые агенты требуют более содержательных этапов обучения за рамками CPT. CPT даёт конкурентоспособный результат, но не закрывает все уровни переноса.
Модели из работы конкурентоспособны со специализированными моделями для игровых 3D-миров и frontier-моделями. Они показывают лучшие результаты в режиме реального времени. Эти результаты не отменяют разрыв в далёких мирах. Они задают границу применимости CPT.
Критерии выбора:
- универсальный агент — планировать этапы за рамками CPT;
- далёкие миры — не считать CPT финальным решением;
- близкие к обучению миры — CPT остаётся рабочим этапом.
Часто задаваемые вопросы
Похожие материалы
Все материалы
SpecEvo: согласование лёгких и передовых LLM для удешевления эволюционного поиска
Фреймворк SpecEvo перераспределяет эволюционный поиск: рядовые кандидаты дорабатывают недорогие модели, а сильные подключаются лишь на стратегических контрольных точках с опорой на историю успехов и тупиков. В экспериментах на 176 задачах такой режим позволил не отставать от дорогих аналогов или обходить их при снижении затрат на API на 80%.
21 ноября 2026
Алгоритмы и роботы в поле: точечные воздействия и наблюдение за культурами
Статья показывает, как данные сенсоров, аэрофотосъёмка и автоматизированные платформы позволяют обнаруживать угрозы на ранних стадиях, направлять обработку только в проблемные зоны и уточнять прогнозы сбора. Рассматриваются и барьеры внедрения — цена техники, надёжность данных, обучение персонала и доступ к связи.
21 ноября 2026
Fig: контролируемые игровые вмешательства для проверки социального поведения ИИ-агентов
Fig получает словесное описание искомого поведения, делит его на разновидности и направленно меняет условия игры, чтобы вызвать нужные действия у моделей. В валидных сценариях для шести социальных паттернов вмешательства повысили среднюю долю попыток целевого поведения на 10,9% относительно контролей, а авторы предлагают рассматривать мультиагентные среды как настраиваемый стенд для воспроизводимой оценки.
21 ноября 2026