
Метод CHOIR: свободное перечисление вскрывает несовпадающие позиции моделей внутри коллективных систем
Авторы предлагают подход CHOIR, при котором ансамбли многократно запрашивают ранжированные перечни ответов, а затем сопоставляют заметность объединённых понятий между моделями, формулировками промптов и ролевыми условиями. Работа показывает, что высокая внешняя схожесть открытых ответов ещё не означает единомыслия: идентичность базовой модели остаётся самым устойчивым различительным признаком, а персонажные установки смещают проявляемые понятия.
Что даёт CHOIR
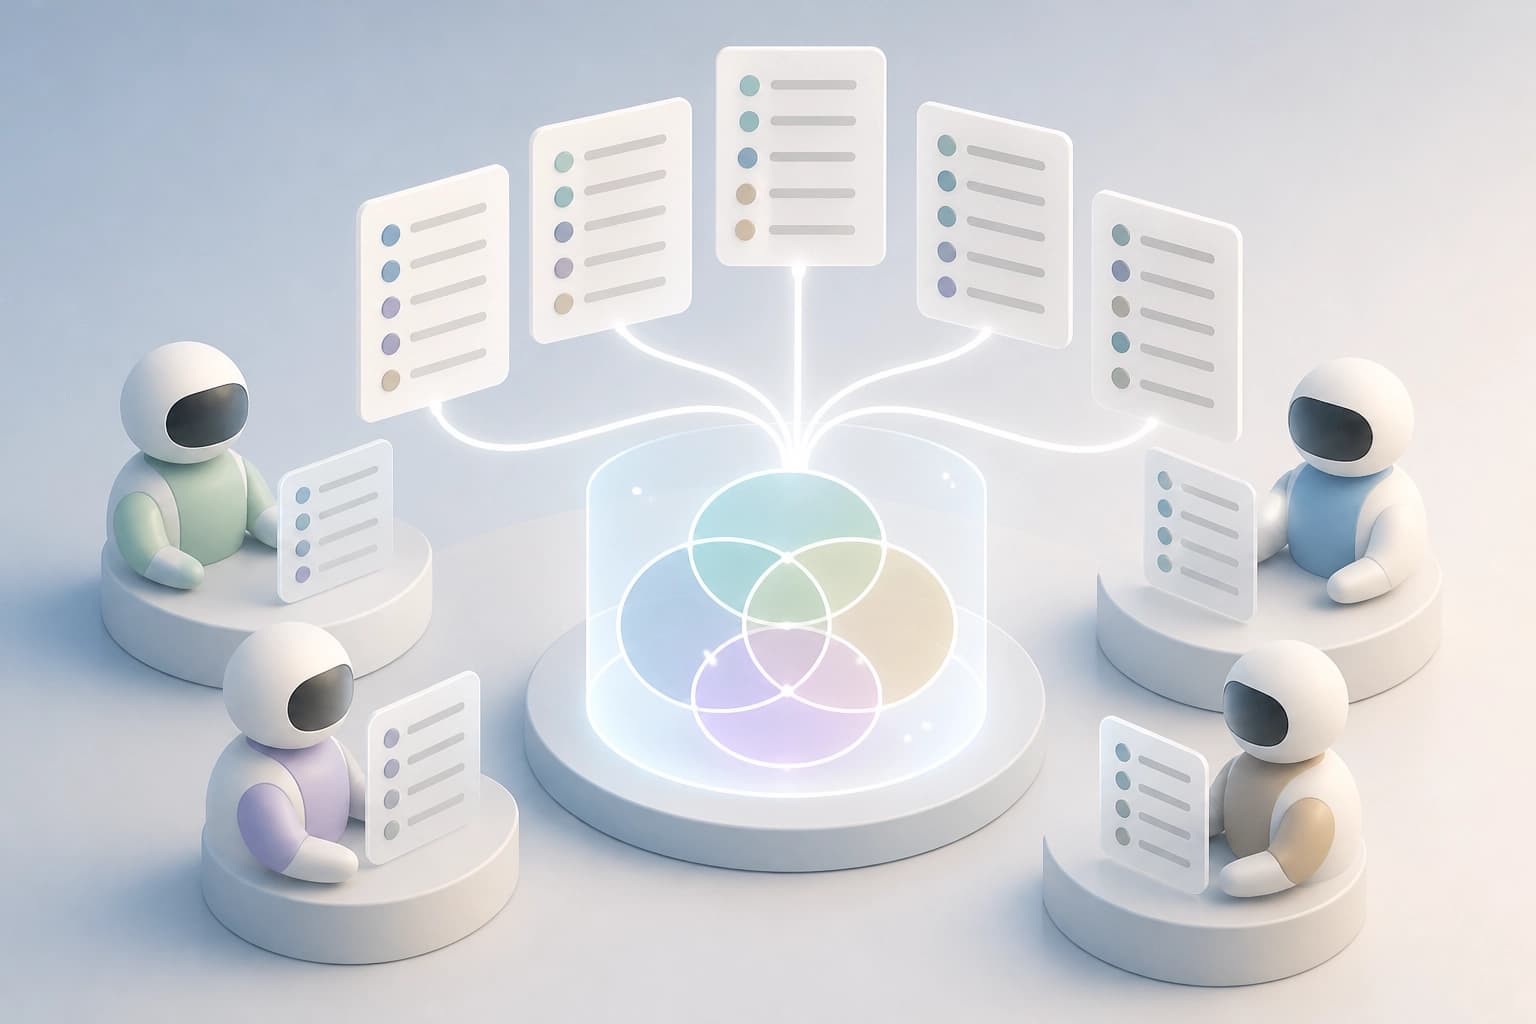
CHOIR расшифровывается как Collective Hierarchically-Ordered Inquiry Responses. Подход адаптирует элицитацию свободным списком для ансамблей LLM. Его задача — вскрыть позиции, по которым модели внутри ансамбля расходятся. Поверхностное согласие ответов такие расхождения скрывает.
Метод работает с перечислениями, а не с готовыми формулировками. Многократные запросы дают материал о том, какие темы модели поднимают сами. Дальше этот материал приводится к сопоставимому виду.
Практический критерий: брать CHOIR в работу, когда ответы ансамбля выглядят одинаково, а нужно понять, где именно модели не совпадают.
Этапы работы метода
Метод строится на трёх шагах.
- Многократный запрос ранжированных списков у моделей ансамбля.
- Объединение элементов списков в понятия на уровне промпта.
- Измерение заметности понятий между моделями, вариантами промптов и условиями с персонами.
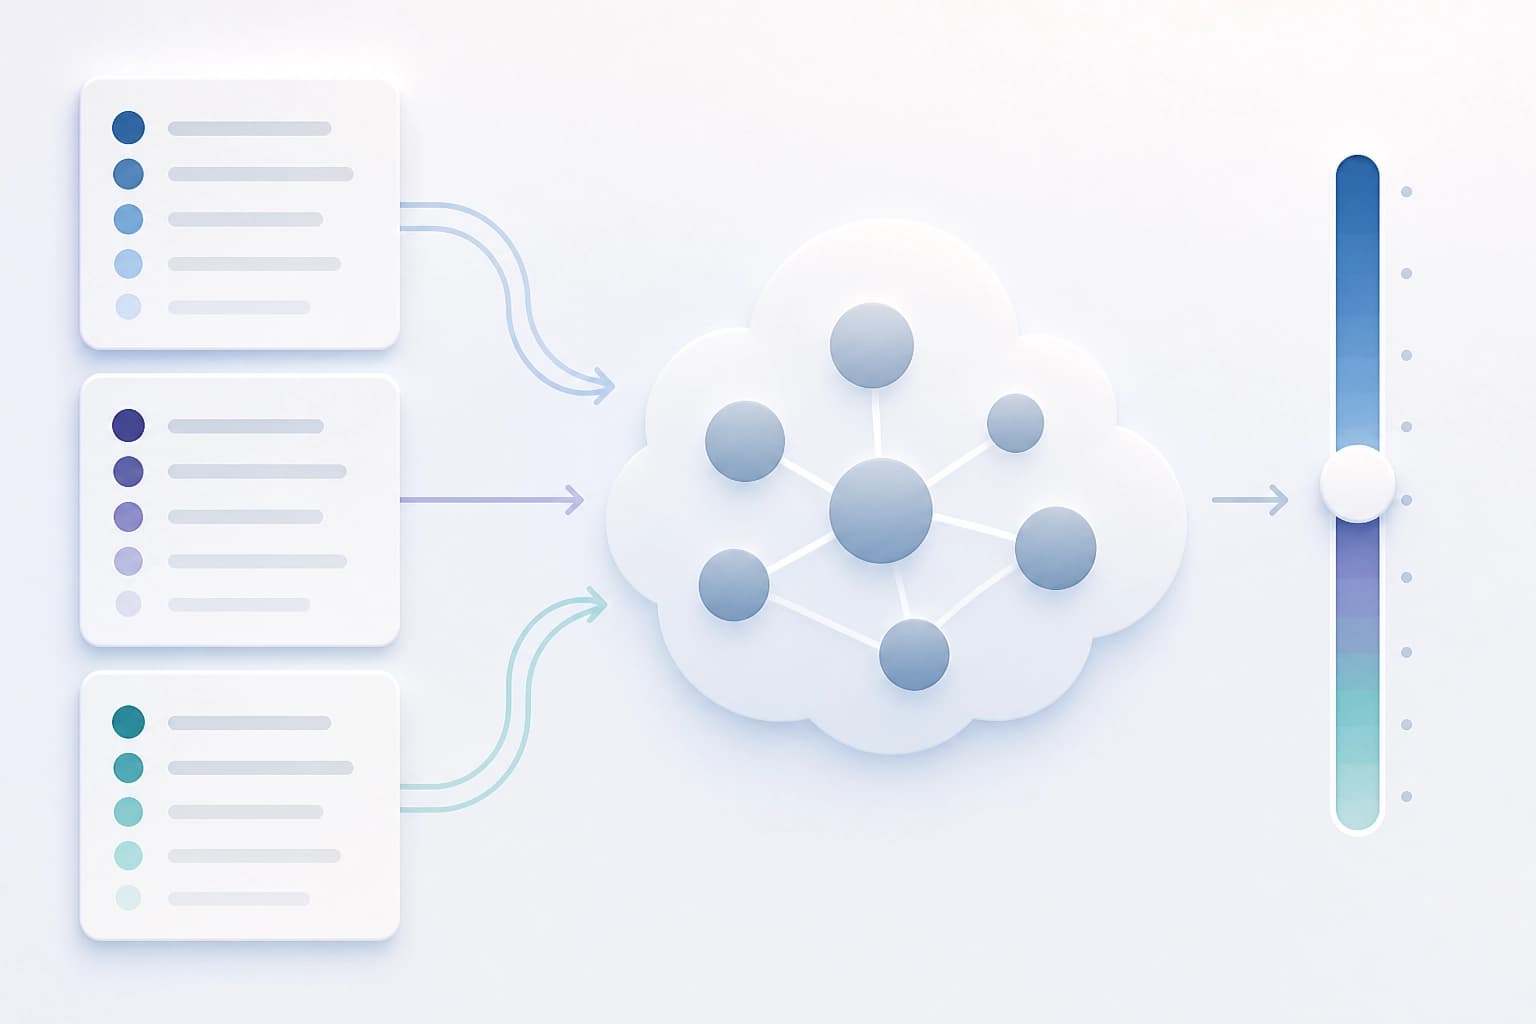
Каждый шаг добавляет измерение. Списки дают сырой материал, объединение приводит его к сопоставимому виду, замер заметности показывает различия. Без сведения к понятиям сравнение остаётся на уровне отдельных слов.
Практический критерий: проверять метод по тому, сохраняет ли он различия после объединения элементов в понятия.
На каких наборах проверяли
| Набор | Что это | Что показал |
|---|---|---|
| Infinity-Chat 100 | Внешний набор промптов из недавней работы об однородности открытых ответов моделей | Воспроизводит высокое поверхностное согласие: 93/100 промптов выше случайного уровня. Разделяет узкие промпты и широкие, у которых выявляется скрытая глубина ответов |
| Целевой диагностический набор | 27 вопросов для выявления различий на уровне механизмов | Служит для целевых проверок расхождений между моделями |
Наборы решают разные задачи. Внешний набор показывает общую картину согласия и одновременно отделяет широкие промпты от узких. Целевой набор заточен под различия на уровне механизмов.
Критерий выбора: для картины согласия брать внешний набор промптов, для разбора механизмов — диагностический.
Какие признаки различий видны
Наблюдения складываются в три группы.
- Идентичность базовой модели остаётся наиболее сильным восстанавливаемым признаком. Это верно и для целевых проверок, и для внешнего набора промптов.
- Промпты с персонами смещают проявляющиеся понятия внутри сигнатур базовых моделей.
- Модуль ранжирования, не знающий источника, выделяет редкие, но стабильные кандидаты для последующего изучения.
Персоны меняют проявление понятий, но не перекрывают сигнал базовой модели. Ранжирование без знания источника работает как фильтр для дальнейшего разбора.
Практический критерий: сначала фиксировать базовую модель, затем оценивать сдвиг от персоны.
Диагностическая рамка вместо констатации согласия
Авторы предлагают рассматривать однородность открытых ответов как диагностическую задачу. Вопрос тогда звучит иначе: где модели сходятся, почему они сходятся и что ещё можно выявить.
- Где сходятся — карта совпадающих понятий между моделями.
- Почему сходятся — причины за поверхностным согласием.
- Что ещё видно — кандидаты, которые выделяет ранжирование без знания источника.
Статья опубликована в Proceedings of the Third Conference on Language Modeling (COLM 2026), 2026. На arXiv она подана 29 сентября 2026. Авторы — Ben Wigler и Maria Tsfasman.
Критерий: однородность ответов — не финальный вывод, а вход в диагностику глубины.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026
Модель мира для агентов на закрытых LLM: коррекция в точках риска
Предложен PAWM — внешний предиктор, который не дублирует пошаговое наблюдение, а включается при вероятном сбое и уводит агента от ошибочного действия. После SFT на синтетических сценариях и GRPO-кообучения метод дал прирост 24,3% в ScienceWorld и 7,7% в WebArena-Lite для Claude Sonnet 4.5.
4 ноября 2026
Классификационная надстройка над SpeechLLM: где она обходит генерацию меток при распознавании эмоций
На материале IEMOCAP и MELD сопоставлены генеративный вывод эмоциональной метки и линейный классификатор поверх скрытых представлений компактной SpeechLLM. Прирост качества от классификатора не универсален: он зависит от корпуса и от того, используются эталонные транскрипты или результаты ASR.
4 ноября 2026