
CEG-Agent: причинный разбор отказов в следах LLM-агентов через графы ошибок
Работа предлагает CEG-Agent — инструментальный фреймворк для причинной диагностики агентных трасс. Формальная классификация разделяет аномалии, ошибки и сбои, а типизированные графы CEG связывают события выполнения с диагностическими узлами и итоговыми провалами; бенчмарк CEG-Bench подтверждает лидерство подхода по смысловой и структурной точности.
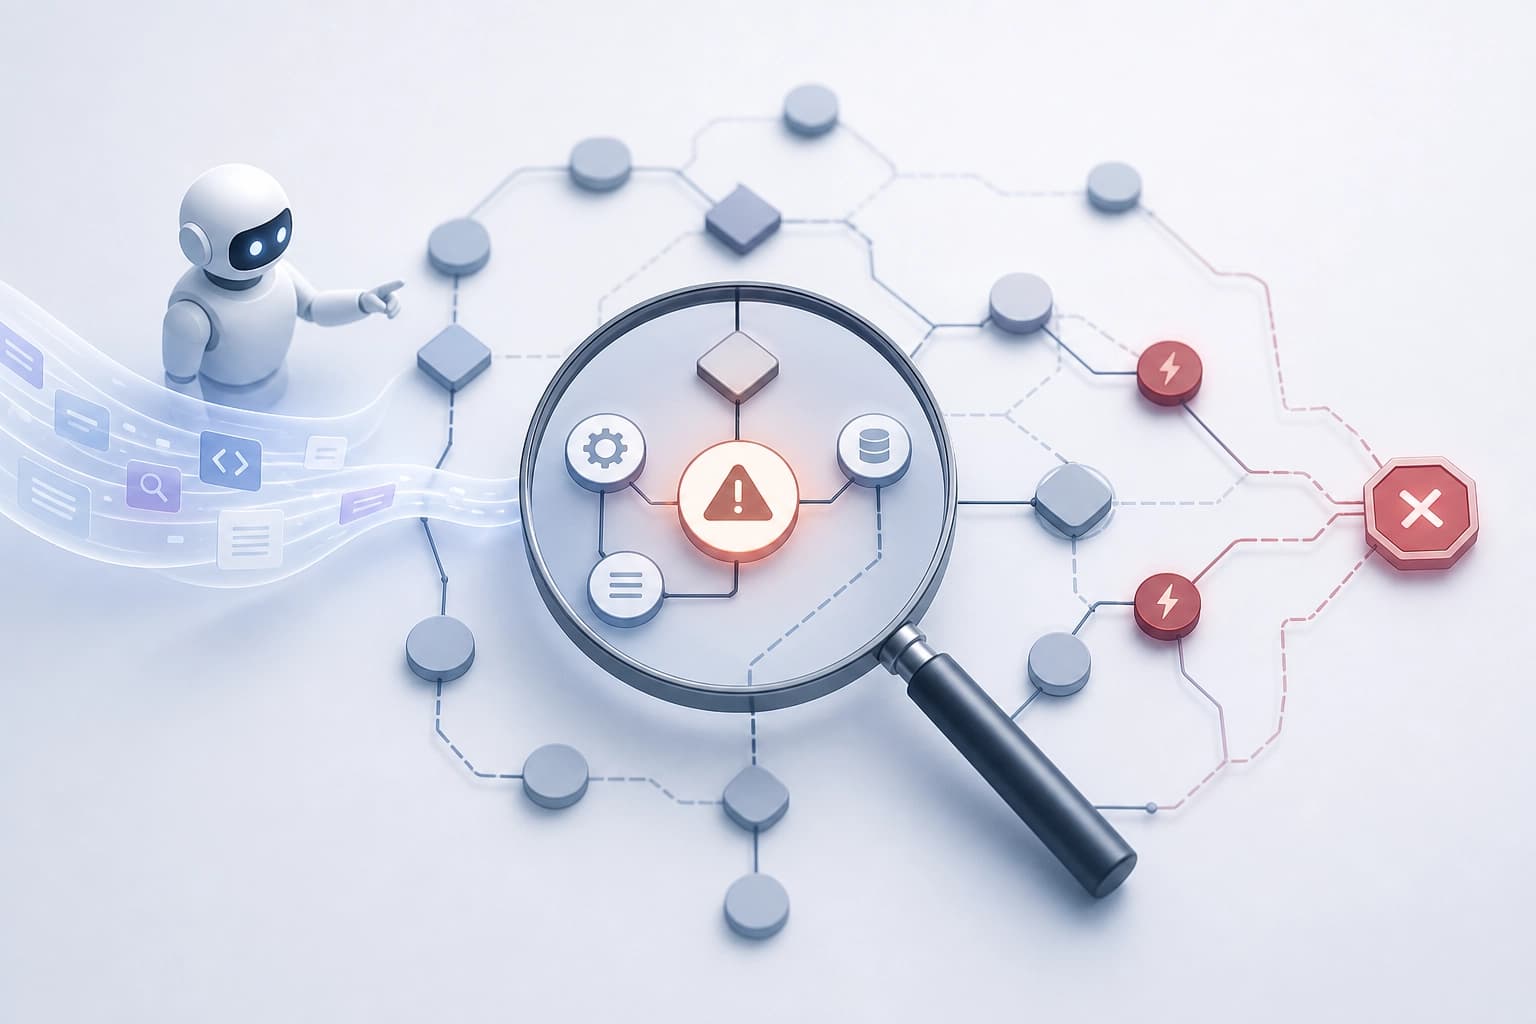
Где ломается диагностика трасс агентов
В сложных приложениях применяют агентов на базе LLM. Трассы таких агентов длинные. Это затрудняет диагностику сбоев.
Существующие методы диагностики смешивают аномалии, ошибки и сбои. Из-за этого диагностические цели становятся неоднозначными.
Методы не моделируют структурированно, как причинно значимые ошибки распространяются и усиливаются. Итоговые сбои задач остаются без надёжной атрибуции.
Практический критерий: метод диагностики должен разделять типы отклонений и прослеживать причинные связи между ними.
Что представляет собой CEG-Agent
CEG-Agent — агентный фреймворк с использованием инструментов. Он выполняет причинную диагностику трасс агентов.
Фреймворк вводит явную таксономию аномалий, ошибок и сбоев. На этой основе он строит Causal Error Graphs (CEGs).
| Подход | Разделение аномалий, ошибок и сбоев | Модель распространения ошибок |
|---|---|---|
| Существующие методы диагностики | Смешивают эти понятия | Не моделируют структурированно |
| CEG-Agent | Вводит явную таксономию | Строит CEGs с причинными отношениями |
Критерий выбора: фреймворк должен давать однозначные диагностические цели и опираться на типизированную модель причин.
Causal Error Graphs: типизированное представление причин
CEGs — унифицированное типизированное представление. Оно связывает элементы трассы причинными отношениями.
В граф входят три типа элементов:
- события выполнения;
- диагностические узлы;
- исходы в виде сбоев.
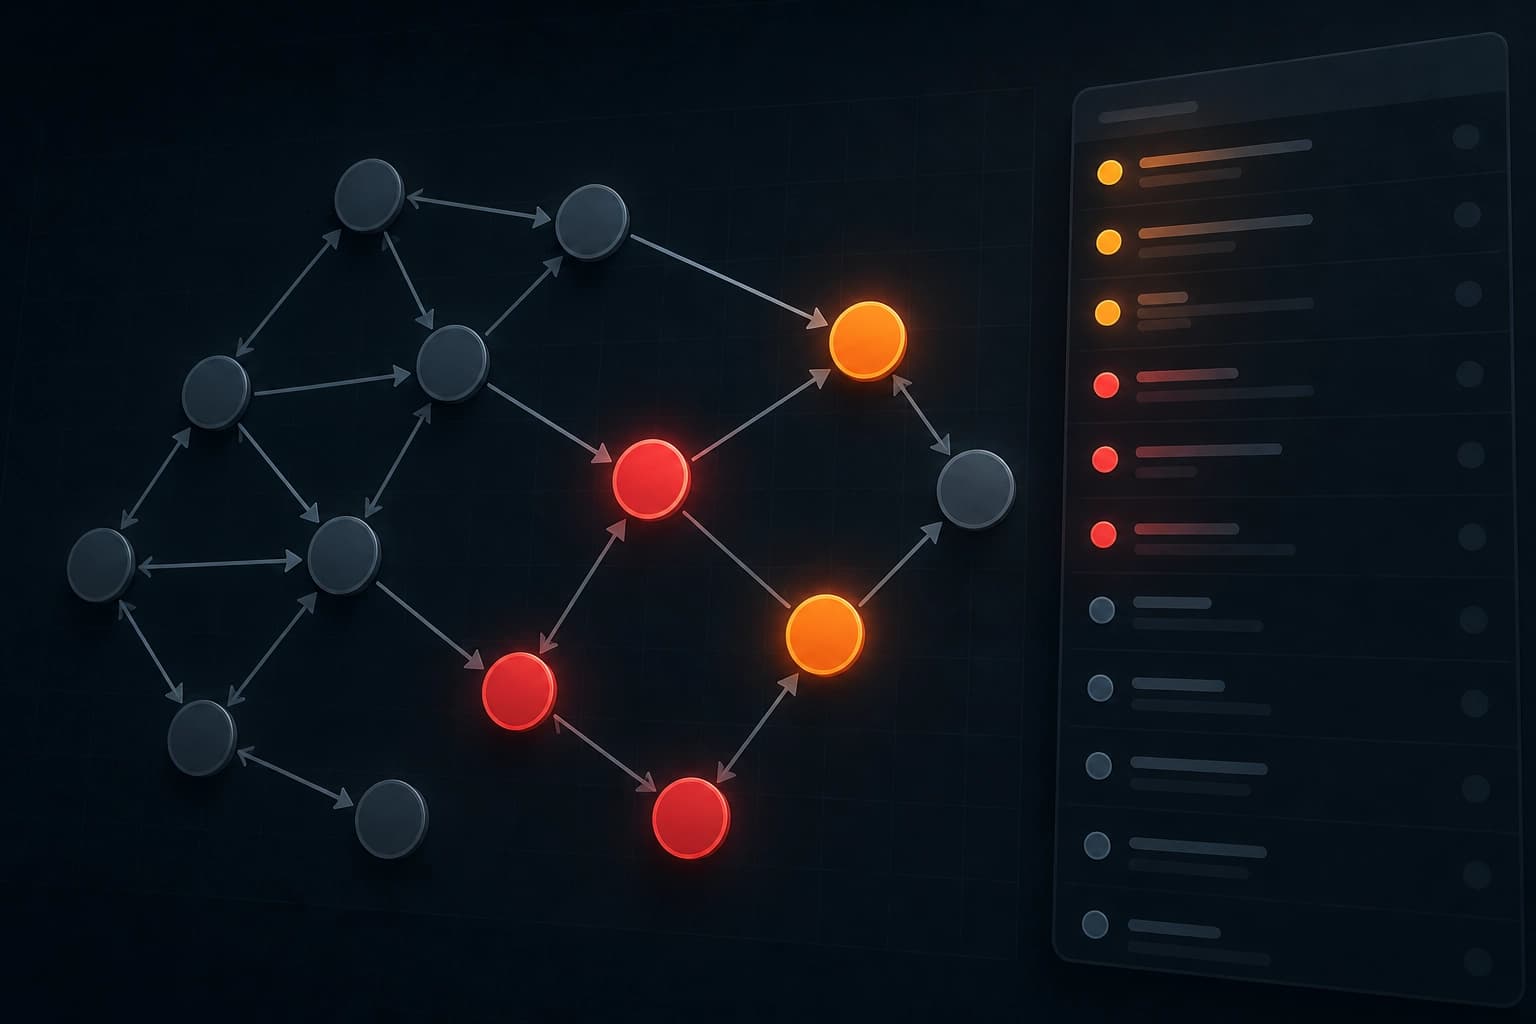
Все элементы связаны причинными отношениями в едином формате. Это отличает граф от набора разрозненных сигналов.
Критерий: представление должно связывать ход выполнения с итоговым сбоем через явные причинные связи.
CEG-Bench и разметка через AAAP
Для оценки причинной диагностики трасс создан CEG-Bench. Это бенчмарк с полностью агентной разметкой.
CEG-аннотации в бенчмарке получены с помощью Adversarial Agentic Adjudication Protocol (AAAP). Аннотации высоконадёжные и согласованные.
Аннотации проверили на экспертно сформированном человеческом эталонном наборе. Автоматические аннотации показали близкое соответствие экспертным.
Критерий: бенчмарк с проверкой разметки на человеческом эталоне годится для сравнения методов причинной диагностики.
Результаты и критерий выбора
В экспериментах на CEG-Bench CEG-Agent достигает результатов state-of-the-art. Оценка шла по двум критериям.
Первый критерий — семантически смягчённая оценка. Второй — структурно точная оценка. По обоим фреймворк показывает результат state-of-the-art.
Критерий выбора: если задача требует и смысловой, и структурной корректности разбора, ориентиром служит метод с результатом такого уровня.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Медицинские LLM узнают о пересмотре рекомендаций, но часто отвечают по прежним правилам
Исследование ChronoEvo на 1709 изменениях клинических рекомендаций показывает: в основной модели 90,8% ответов фиксировали новшество, однако полностью применяли его только 58,5%, а разрыв в 32,3 п.п. сохранялся у 14 моделей. Даже усиление заметности обновлений не дало значимого прироста в полном переносе новых правил в клиническую рекомендацию.
4 ноября 2026
Модель мира для агентов на закрытых LLM: коррекция в точках риска
Предложен PAWM — внешний предиктор, который не дублирует пошаговое наблюдение, а включается при вероятном сбое и уводит агента от ошибочного действия. После SFT на синтетических сценариях и GRPO-кообучения метод дал прирост 24,3% в ScienceWorld и 7,7% в WebArena-Lite для Claude Sonnet 4.5.
4 ноября 2026
Классификационная надстройка над SpeechLLM: где она обходит генерацию меток при распознавании эмоций
На материале IEMOCAP и MELD сопоставлены генеративный вывод эмоциональной метки и линейный классификатор поверх скрытых представлений компактной SpeechLLM. Прирост качества от классификатора не универсален: он зависит от корпуса и от того, используются эталонные транскрипты или результаты ASR.
4 ноября 2026