Выбор энкодера делают не по той метрике
Замороженный энкодер обычно берут в проект, глядя на одну вещь: насколько хорошо поверх его представлений обучается лёгкая голова — линейный слой, небольшая MLP, что-нибудь в этом духе. Если простая голова вытягивает нужный признак, энкодер считают удачным. Но такая оценка отвечает на вопрос «удобно ли из этих эмбеддингов что-то считывать», а не на вопрос «разделяет ли признак сама геометрия пространства». Это два разных вопроса, и путать их дорого: голова маскирует слабость представления, пока задачи простые и классов немного.
Отдельно стоит проблема баланса. Пока классы примерно равны, разница между «энкодер умеет» и «голова вытягивает» почти не видна. Как только один класс становится редким, метрики на основе ближайших соседей начинают systematically врать.
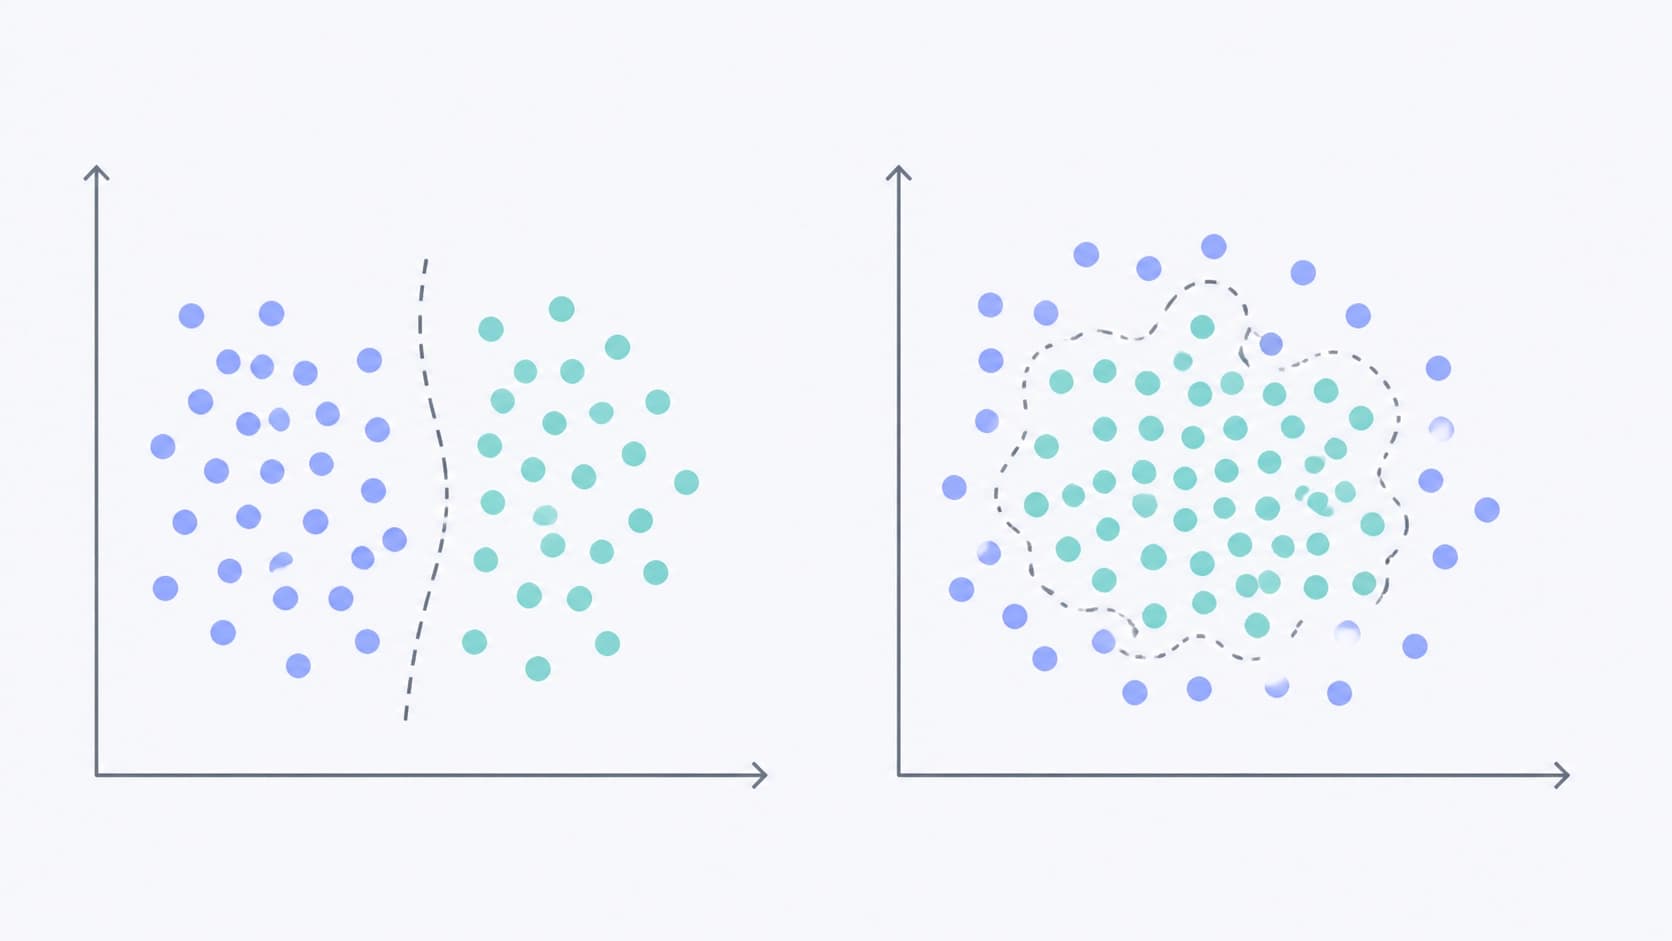
Почему дискордантность по ближайшим соседям врёт
Классическая метрика дискордантности устроена просто: для каждой точки ищут соседей в пространстве эмбеддингов, и если ближайший сосед носит противоположную метку — случай записывают как дискордантный. Внутри одного класса геометрия работает замечательно, к соседям претензий нет.
Проблема в асимметрии процедуры. Когда соседей для положительных и отрицательных примеров набирают из множеств разного размера, ближайший сосед с противоположной меткой выигрывает не потому, что так устроена геометрия, а потому, что его класс просто плотнее лежит в окрестности. Иными словами, в результат просачивается распространённость класса (prevalence) — статистика датасета, а не свойство представления. Эффект неприятный: полностью неинформированный энкодер начинает выглядеть слепым, хотя на деле он ровно так же бесполезен, как честная монетка, и не хуже.
Что именно меняет CANDOR
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — переопределяет саму процедуру подсчёта. Соседские банки здесь набираются равного размера, а конструкция метрики симметрична относительно перестановки меток: поменяйте положительные и отрицательные местами, и значение не изменится. Как следствие, уровень случайного угадывания зафиксирован ровно на одной второй — 50%. Не «примерно около половины, зависит от датасета», а строгая точка отсчёта в 1/2.
Это не косметическая правка. Именно плавающая точка отсчёта мешала сравнивать энкодеры между собой и между датасетами: там, где дисбаланс сильнее, случайное угадывание выглядело хуже, чем оно есть, и модель получала незаслуженный кредит доверия. Когда отсчёт закреплён, сравнение становится честным.
И ещё одна деталь, важная для практики: раз точка отсчёта фиксирована, CANDOR можно посчитать до обучения какой угодно головы. Никакого файнтюнинга, никакого подбора гиперпараметров — метрика описывает сами представления и заранее подсказывает, какие находки конкретный замороженный энкодер поддерживает плохо.
Проверка на масштабе
Авторы прогнали оценку широко: 22 энкодера, 20 датасетов из 7 предметных доменов, суммарно 605 443 изображения. Такой размах нужен был как раз для того, чтобы отделить эффект метрики от особенностей одной задачи.
Результат переворачивает вывод, к которому приводила старая процедура. После поправки коллапс представлений оказывается ниже уровня случайного угадывания почти везде. Читается это так: ни один из проверенных энкодеров не является слепым — информация о признаке в представлениях есть, — но все они слабы. Формулировка «все слабы, никто не слеп» звучит мягче, чем прежняя, и при этом гораздо точнее описывает реальность.
Клинический пример: сильная голова при слабой геометрии
Самая наглядная иллюстрация — медицинская визуализация. Лучшая модель для грудной клетки читает пневмоторакс с AUROC 84,5. Цифра солидная, и на неё обычно и смотрят при выборе модели. Но та же модель помещает 18,4% положительных случаев ближе к снимку с противоположной меткой, чем к собственному снимку с той же находкой — в пределах одной и той же больницы, то есть без доменного сдвига в качестве объяснения.
Разрыв между «голова хорошо решает задачу» и «геометрия путает положительные и отрицательные» — это и есть то самое расхождение. Голова компенсирует слабое представление; метрика CANDOR показывает, что компенсировать приходится много.
Дальше — сравнение между доменами. Один и тот же энкодер различает виды птиц на уровне 4,5 (то есть почти идеально), а находки грудной клетки оставляет на 42,8, глаукому — на 49,8. Последнее число стоит на уровне случайного угадывания, а по сути — хуже случайных весов. Один энкодер, одно обучение, три совершенно разных качества геометрии.
Дефицит отбора, а не информации
Из этого следует естественный вопрос: значит, представления безнадёжны? Не совсем. Случай ограничивает нормализованный отступ (normalized margin) любой липшицевой головы — то есть головы с ограниченной чувствительностью к сдвигу входа. Однако внутри набора из одиннадцати голов находится такая, которая права во всех случаях, кроме 2,8%, тогда как отдельно взятая голова промахивается в 35,9%. Информация о признаке в представлении есть — она просто неодинаково доступна разным считывающим устройствам. Значит, дефицит связан с отбором (selection), а не с отсутствием информации.
Интересная ассоциация обнаружилась и в другом месте: сохранение при стирании (erasure retention) связано с коллапсом. А вот с целью обучения, масштабом модели, давностью выпуска или размером находки связи не нашли. Проще говоря, «взять модель побольше и посвежее» проблему не решает — она не про размер и не про возраст.
Что из этого следует на практике
Три практических вывода.
- Считайте CANDOR до обучения головы. Это дешёвая проверка, которая показывает, поддерживает ли энкодер конкретную редкую находку, и позволяет отсеять неподходящий бэкбон до того, как вы потратите время на тюнинг.
- Не путайте AUROC головы с качеством представления. 84,5 при 18,4% дискордантных положительных — это нормальная, не редкая ситуация, и она стоит того, чтобы её измерять отдельно.
- Не ждите, что масштаб и новизна всё исправят. Ассоциаций с размером, целью обучения и давностью не нашлось; слабость замороженных энкодеров выглядит системной.
Главная ценность этой истории даже не в самой метрике, а в перевёрнутом выводе. Раньше казалось, что энкодеры «слепы» к отдельным классам. После калибровки по шансу видно другое: они видят почти везде, но везде слабо. Это куда менее драматичная и куда более рабочая картина — с ней понятно, что чинить и в каком порядке.